TGViewer
Channel Public Channel
SQL: Реляционные базы данных

SQL: Реляционные базы данных

@relational_databases

Канал айтишника о реляционных базах данных, SQL и модели данных. У нас тут много, очень много практических разборов))

Меня зовут Владимир Лунев (@lejnlune). Интересуюсь архитектурой систем и моделей данных.
Subscribers
986
Photos
88
Videos
1
Links
60

Showing posts older than #110 · Back to latest

Older Posts 14 shown
Post #108 1.25K
🧊 Айсберг SQL

Однажды, наткнулся на забавный мем, который с каждым уровнем становится все сложнее и страшнее, посмеялся и забыл. А недавно нашёл статью на Хабр и оказалось, что у мема есть реальное практическое применение, ведь он, по сути, этап за этапом разбирает взаимодействие через SQL с СУБД PostgreSQL, а автор мема SQL-разработчик Джордан Льюис.

Так что можно использовать мем, чтобы выстроить свой путь изучения SQL, как методичку))

На этой неделе, кстати, опубликую пост, как быстро погрузиться в SQL, если вы новичок, и за пару недель (или меньше) достичь гордого уровня junior, минимально необходимого для прохождения собеседований.
  • 🔥 29
  • 👾 5
  • 🌚 4
Post #107 1.05K
📥 Что такое CTE (WITH) в SQL?

CTE (Common Table Expression) — это временный результирующий набор данных, определённый в WITH-блоке и используемый внутри основного SQL-запроса. Он существует только в рамках одного запроса и не сохраняется в базе.
По сути, это "виртуальная подтаблица", которую можно использовать как обычную таблицу, но без создания объекта в БД.

Зачем нужен CTE?
➖ Упрощает структуру запроса. Вместо вложенных подзапросов (особенно повторяющихся), можно дать промежуточным результатам имена и вынести их в WITH.
➖ Повышает читаемость. Каждый WITH-блок как отдельный логический шаг, как в пайплайне обработки данных.
➖ Упрощает отладку. Можно легко запускать отдельные WITH-блоки как обычные SELECT-запросы и проверять результаты.
➖ Поддерживает рекурсию. С помощью WITH RECURSIVE можно обходить иерархии, строить деревья и графы.

🪙Общий синтаксис:
WITH имя_cte (опциональные_поля) AS (
SQL-запрос
)
SELECT ...
FROM имя_cte
...

WITH объявляет формирование CTE. Можно создавать несколько CTE за один раз, разделяя их запятыми:
WITH cte1 AS (...),
cte2 AS (...)
SELECT ...
FROM cte1
JOIN cte2 ...


🪣 Давайте разберем на примере. Задача:
Найти всех пользователей, которые заходили в систему за последние 30 дней, и посчитать, сколько заказов сделал каждый из них.

💳 Модель данных:
➖ Таблица пользователи — users (id, name, last_login)
Атрибуты:
➖users.id — уникальный идентификатор пользователя, первичный ключ.
➖users.name — имя пользователя, текстовое поле.
➖users.last_login — дата (или дата и время) последнего входа в систему, используется для фильтрации активных пользователей.

🪙Полный состав таблицы users по данным:
id   name   last_login
101 Иван 2025-07-20
105 Ольга 2025-07-15
109 Петр 2025-06-10


➖ Таблица заказы — orders (id, user_id, created_at).
Атрибуты:
➖orders.id — уникальный идентификатор заказа, первичный ключ.
➖orders.user_id — внешний ключ на users .id, связывает заказ с пользователем.
➖orders.created_at — дата (или дата и время) создания заказа.

🪙 Полный состав таблицы orders по данным:
id   user_id  created_at
201 101 2025-07-21
203 101 2025-07-20
206 101 2025-07-22
202 105 2025-07-19
204 105 2025-07-22
205 105 2025-07-23
207 105 2025-07-24
208 105 2025-07-25
209 105 2025-07-26
210 105 2025-07-27

💳 Пример запроса с CTE для решения задачи:
WITH active_users AS (
SELECT id AS user_id
FROM users
WHERE last_login > CURRENT_DATE - INTERVAL '30 days'
)
SELECT
u.user_id,
COUNT(o.id) AS orders_count
FROM active_users u
JOIN orders o ON o.user_id = u.user_id
GROUP BY u.user_id;

💳 Разберем запрос:
WITH active_users AS (...)

Создаём временный набор данных с именем active_users, в который попадут только те пользователи, чей last_login был в последние 30 дней.
CURRENT_DATE - INTERVAL '30 days' 

Это дата 30 дней назад от текущей.

💳Пример вывода отдельно по CTE active_users:
user_id
101
105
109

💳 Разберем основной запрос:
SELECT 
u.user_id,
COUNT(o.id) AS orders_count
FROM active_users u
JOIN orders o ON o.user_id = u.user_id
GROUP BY u.user_id;

➖ Присваиваем псевдоним u для CTE active_users
➖ Соединяем с таблицей orders по user_id
➖ Считаем количество заказов через COUNT(o. id)
➖ Группируем по пользователю, чтобы посчитать заказы отдельно для каждого.

💳 Итоговый результат:
user_id     orders_count
101 3
105 7

Пользователь 109, у которого нет заказов, не попадёт в результат — INNER JOIN исключает строки без соответствующих заказов. Чтобы включить таких пользователей и показать orders_count = 0, используйте LEFT JOIN

Когда точно стоит использовать CTE:
➖ У вас многоуровневая логика запроса.
➖ Один и тот же подзапрос используется несколько раз.
➖ Вы готовите пайплайн данных — шаг за шагом.
➖ Нужно рекурсивно обрабатывать данные (например, иерархии категорий).

#CTE #SQL

📱 Подписаться на канал
💻 Курс автора по SQL DDL
🌎 Мой ИТ-стартап
  • 🔥 22
  • 🤯 6
  • 💯 1
  • 👾 1
Post #106 936
👩‍💻 Генерация ключей в SQL: что выбрать — UUID, INT или BIGINT?

При проектировании таблиц в реляционных базах данных важно выбрать тип данных для первичного ключа. От него зависят скорость запросов, обеспечение уникальности, масштабируемость и даже архитектура системы. Даже если вы не проектируете БД, понимание ключей поможет в работе с данными.

🖥 Если необходимо, можете прочитать пост про первичный ключ и базовый автоинкримент тут

В этом посте рассмотрим три популярных способа генерации первичных ключей: INT, BIGINT и UUID.

🛠 INT — автоинкрементный числовой ключ.
Используется по умолчанию в большинстве проектов. Он требует минимум места, обеспечивает быструю сортировку и фильтрацию по индексу, хорошо читается в логах, легко реализуется средствами СУБД. Но у INT есть потолок (2.1 млрд значений) и ограниченная масштабируемость: при распределении на несколько серверов ID могут пересекаться. А ещё ID легко угадываются, что делает структуру базы предсказуемой.

✅ Подходит для централизованных систем с небольшим или средним объёмом данных, занимает минимум места в памяти и индексах, понятен при отладке и в логах.
✅ Быстрота отличная производительность при сортировке и фильтрации по индексу.
✅ Легко реализуется с AUTO_INCREMENT или SERIAL.
❌ ID легко предсказуемы, что может косвенно раскрывать объёмы или порядок операций, также при ошибке планирования в крупных системах может потребоваться переход на BIGINT.
❌ Сложность масштабирования, трудно синхронизировать генерацию ID между несколькими узлами.

🛠 BIGINT — INT с запасом на вырост.
То же самое, только 64 бита. Решает проблему переполнения — хватит на миллиарды строк. Сохраняет читаемость, скорость и простоту реализации. Поддерживается всеми современными СУБД. Но индекс и таблицы с такими ключами весят больше. А генерация ID всё ещё централизованная, что не даёт гибкости.

✅ Уместен в крупных монолитных системах с интенсивной вставкой данных (например, финансы, e-commerce).
✅ Сохраняет преимущества INT — скорость, простота, читабельность.
❌ По-прежнему требует централизованной генерации: не решает задачу горизонтального масштабирования.

🛠 UUID (Universally Unique Identifier).
UUID создаётся независимо, без единого центра, что делает его идеальным для микросервисов, Kafka, offline-режимов и распределённых архитектур. Его сложно предсказать — это повышает безопасность. UUID легко интегрируется в API и события. Но UUID весит больше (16 байт), хуже индексируется, не читается глазами, не сортируется. Это может замедлять JOIN и вставки. Если важна хоть какая-то упорядоченность, используйте UUID v1 или v7 — они содержат метку времени.

✅ Лучший выбор для распределённых систем, событийных шин, микросервисов, широко используется в API, Kafka, распределённых брокерах
✅ Можно безопасно генерировать на любом сервере, без централизованного координирующего узла
❌ Неудобны при ручной работе: тяжело читаются и неудобны в логах, CLI.
❌ 16 байт против 4–8 байт у числовых типов, что замедляет индексацию и JOIN

🧊 Объемы генерации ключей в экземпляре таблицы.
Вы можете создать не более примерно 2 миллиардов уникальных записей с автоинкрементом INT. Если же использовать BIGINT, то его диапазон гораздо шире — он позволяет задать свыше 9 квинтиллионов уникальных значений, что на практике практически никогда не достигается.

С UUID ситуация другая: это 128-битное значение, которое генерируется случайным или псевдослучайным образом. Количество возможных значений настолько велико (2^128), что даже при создании миллиардов UUID-ключей в секунду вероятность столкнуться с дублем за всю историю человечества минимальна. Однако при этом UUID занимает больше места, как на диске, так и в оперативной памяти, и может замедлять индексацию.

Что выбрать?
➖ Централизованная база — INT
➖ Крупная монолитная система — BIGINT
➖ Распределённые микросервисы — UUID
➖ Нужно скрыть структуру и объём данных, избежать переполнения навсегда — UUID
➖ Приоритет на компактность и быстрые JOIN/сортировки — INT / BIGINT

#UUID #INT #BIGINT

📱 Подписаться на канал
💻 Курс автора по SQL DDL
🌎 Мой ИТ-стартап
  • 🔥 16
  • 💯 5
  • 👾 4
  • 🤣 1
Post #105 971
🖥 История SQL: от лаборатории IBM до ядра современного ИТ

Привет, сегодня факультативный пост без разборов кода. Все слышали про SQL, многие с ним работали и работают, но давайте разберем откуда он вобще взялся и почему стал так популярен. Это язык, который пережил несколько поворотных технологических эпох в мире ИТ и до сих пор является самым актуальным и популярным инструментом управления данными.

🛠 Рождение: 1970-е
➖ В 1970 году Эдгар Ф. Кодд, исследователь IBM, публикует революционную работу "A Relational Model of Data for Large Shared Data Banks", это была академическая теория, но она перевернула подход к хранению данных.
➖ В 1974-м команда IBM разрабатывает язык SEQUEL (Structured English Query Language) для получения данных из экспериментальной БД System R.
➖ Позже название SEQUEL пришлось сократить до SQL, потому что его уже использовала британская авиакомпания Hawker Siddeley.

💽 Изначально SQL задумывался как язык, понятный и "близкий к английскому", чтобы бизнес-аналитики могли работать с данными без программистов.
В реальности — получилось не совсем так.

🛠 Стандартизация и рост
➖ В 1986 году SQL становится стандартом ANSI, а годом позже — ISO.
➖ К началу 90-х SQL — основной язык для большинства СУБД: Oracle, IBM DB2, Microsoft SQL Server, Informix, Sybase.
➖ Возникает "SQL-диалектология": почти каждый вендор внедряет свои особенности (например, LIMIT в MySQL, TOP в SQL Server, FETCH FIRST в стандартном SQL).

💽 Несмотря на принятие стандартов, парадигма "один SQL-запрос для всех СУБД" — остается мифом. Переносимость запроса — один из вечных триггеров боли и страданий разработчиков.

🧊 Реальный мир
➖ С начала 2000-х SQL стал ключевым инструментом для цифровизации банков — внедрение систем управления рисками, скоринга и автоматизации кредитных процессов построено именно на SQL.
➖ В 2000-х годах ритейлеры начали массово внедрять ERP и CRM-системы с поддержкой SQL, что позволило централизовать данные по продажам, складским остаткам и клиентам, улучшая управление и планирование.
➖ В середине 2010-х с ростом e-commerce SQL-системы стали основой для обработки больших объёмов транзакций и аналитики пользовательского поведения в онлайн-магазинах.
➖ С 2015 года популярность аналитических баз данных на основе SQL (ClickHouse) резко выросла, что позволило компаниям быстро анализировать миллионы строк данных.
➖ С 2018 года благодаря развитию облачных решений SQL всё чаще используется компаниями для масштабируемой аналитики без крупных капитальных вложений в инфраструктуру.
➖ SQL активно применяется в логистике и транспорте с 2000-х годов для оптимизации маршрутов, управления складскими запасами и интеграции данных между разными системами.
➖ Образовательные программы с 2000 года делают SQL обязательным языком для обучения ИТ-специалистов

💽 Несмотря на десятилетия развития, до сих пор любое веб-приложение можно "проколупать", если не использовать подготовленные выражения (prepared statements). Пост про SQL Injection тут

🧊 SQL сегодня
Сегодня есть ряд глобальных проблем, среди них:
➖ Современные архитектуры часто сочетают SQL и NoSQL, графовые базы, хранилища ключ-значение. Координация запросов и целостность данных в такой смешанной среде — сложная задача.
➖ Традиционные реляционные СУБД порой испытывают трудности с масштабированием на огромных объёмах данных (Big Data), полноценное масштабирование остаётся вызовом.
➖ SQL изначально предназначался для табличных данных, и работа с другими форматами требует расширений и зачастую приводит к усложнению запросов и снижению эффективности.

Некоторые плюсы:
➖ Несмотря на появление NoSQL, data lake и новых языков, SQL остаётся ключевым стандартом работы с данными.
➖ Современные облачные системы хранения и аналитики (BigQuery, ClickHouse) используют SQL как основной язык запросов.
➖ В проектах с машинным обучением и аналитикой данные извлекаются и подготавливаются с помощью SQL.

Вобщем, SQL, еще долго будет с нами, полноценного альтернативного решения, еще не изобрели, так что учим)

#История_SQL #SQL

📱 Подписаться на канал
💻 Курс автора по SQL DDL
  • 💯 9
  • 👾 6
  • 🔥 2
Post #104 950
И смешно и грустно. Но по моему опыту ИИ неплохие результаты показывает, ибо многие аналитики предочитают не думать об оптимизации запросов, ибо целью является, просто получение нужных данных через страдания CPU и прочих механизмов сервера 🖥
  • 🤣 10
  • 👾 4
  • 🔥 2
  • 🤔 1
Post #103 967
🔓 SQL Injection: как одна кавычка может взломать базу данных

Привет, обещал рассказать про SQL-инъекции. Начнем с теории, а потом расскажу пару интересных кейсов, как от этого пострадали крупные компании.

SQL-инъекция — это уязвимость, при которой злоумышленник может внедрить произвольный SQL-код в запрос и изменить его поведение. Обычно возникает, когда значения из внешнего ввода (пользователя) напрямую вставляются в SQL-запрос без очистки и параметризации.

❗️ Условный пример:
Представим, что на сайте есть форма входа, и backend формирует такой запрос на основе ввода пользователя:
SELECT * FROM users 
WHERE username = 'admin' AND password = '1234';

Но если пользователь введёт в поле password значение:
' OR '1'='1

Запрос превратится в нечто вроде:
SELECT * FROM users 
WHERE username = 'admin' AND password = '' OR '1'='1';

А это всегда истина. В итоге, пользователь войдёт без знания пароля.

⬇️ 💻 Вот несколько реальных случаев SQL-инъекций, которые нанесли урон крупным компаниям и организациям — как финансовый, так и репутационный:

❗️ 1. Heartland Payment Systems (2008)
Урон: более 130 миллионов украденных номеров кредитных карт.

Хакеры использовали SQL-инъекцию на публично доступном веб-сервере, чтобы получить доступ к внутренней сети компании. Далее они установили кейлоггер, чтобы собирать данные с систем обработки платежей.

Последствия:
➖ Один из крупнейших в истории взломов по объёму похищенных карт.
➖ Heartland потеряла сотни миллионов долларов на штрафах, судебных исках и модернизации безопасности.

❗️ 2. Sony Pictures (2011)
Урон: более 1 миллиона аккаунтов пользователей, включая пароли, e-mail и адреса.

Группа LulzSec заявила, что использовала простую SQL-инъекцию на одном из сайтов Sony, не требующую особых технических знаний. База данных была не зашифрована.

Последствия:
➖ Массовый слив пользовательских данных.
➖ Сильный удар по репутации компании, повторные взломы.
➖ Общественная критика слабой кибербезопасности Sony.

❗️ 3. TalkTalk (2015)
Урон: утечка данных более 150 тыс. клиентов, включая банковские данные и номера карт.

Хакер использовал простейшую SQL-инъекцию в форме запроса на сайте, где не была проведена должная проверка входных данных.

Последствия:
➖ Ущерб оценивался в более чем 77 миллионов фунтов.
➖ Штраф в размере 400 000 фунтов от регулятора (ICO).
➖Генеральный директор публично признал: «атака была примитивной».

❗️ 4. U.S. Election Assistance Commission (2016)
Урон: утечка информации о безопасности выборов, продажа на чёрном рынке.

Что произошло:
SQL-инъекция позволила злоумышленникам получить доступ к серверу агентства. Они смогли создать привилегированную учётную запись администратора и продали доступ к базе данных на хакерских форумах.

Последствия:
➖ Скандал на фоне выборов в США.
➖ Подозрения в попытках повлиять на демократический процесс.
➖ Усиление мер по кибербезопасности в госсекторе.

🔐 SQL-инъекция — это не баг кода, а баг архитектуры. Её можно полностью избежать, если изначально строить систему основанной на принципах безопасности данных.

Что объединяет все эти случаи?
➖ Недостаточная защита ввода данных
➖ Отсутствие параметризации запросов
➖ Плохая архитектура безопасности
➖ Данные хранились без шифрования

🔒Короткую методичку по защите от этого типа атак можно тезисно охарактеризовать так (подробно расписывать не буду, так как поста не хватит, если интересно почитать подробнее о способах защиты, пишите в коменты, сделаю отдельный пост):
➖ Используйте подготовленные выражения (prepared statements)
➖ Не собирайте SQL вручную через конкатенацию строк
➖ Ограничьте права пользователям базы данных, контролируйте права ролей
➖ Логируйте и анализируйте необычные запросы (Если в логах видите 1=1 или --, это может быть попыткой взлома)
➖ Используйте ORM (SQLAlchemy, Django ORM, Hibernate)

#SQL_Injection #SQL

📱 Подписаться на канал
💻 Курс автора по SQL DDL
  • 🔥 14
  • 👾 6
  • 🤔 3
  • 😱 2
Post #95 962

Forwarded from БАШНЯ

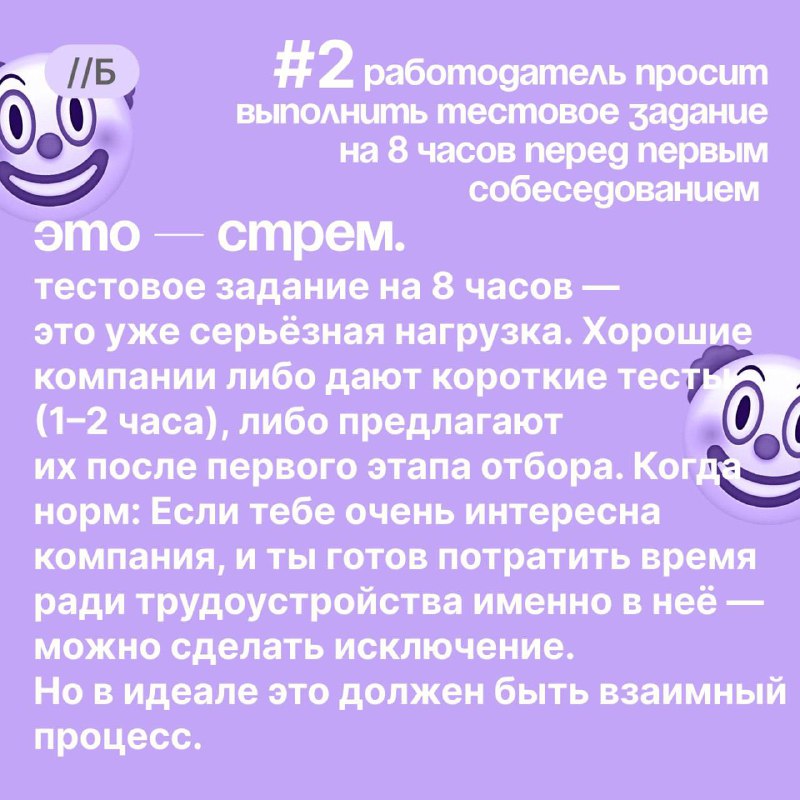
РАЗБОР РУБРИКИ НОРМ ИЛИ СТРЕМ ❗️

Владимир Лунев - наш ментор подготовил разбор, где детально рассмотрел каждый наш вопрос 🔥

Не забывайте, что уже сейчас можно записаться на занятие с ментором через нашего менеджера - @bashnya_edu 🤯

Более подробно про менторство можно узнать в нашем миниаппе 💪

#mini_app
  • 🔥 17
  • 💯 7
  • 👾 5
  • 🤣 1
Post #94 678
Привет, немного порассуждал над собесами и подготовкой к ним, совместно с @bashnya_education
  • 🔥 7
Post #92 967
😵‍💫 Как посчитать дельту к предыдущему дню в SQL

Недавно писал важный скрипт на работе, где необходимо было считать дельты внутри колонок (сегодня минус вчера). Подумал, что это очень полезное знание и решил передать его вам, моим подписчикам. Собственно вычисление между текущим и предыдущим значением внутри колонки мы и рассмотрим.

SQL-инструмент для расчёта такой дельты — оконная функция LAG()

💻 Общий синтаксис:
LAG(столбец, смещение, значение_по_умолчанию) 
OVER (PARTITION BY ... ORDER BY ...)

➖ LAG(column) возвращает значение из предыдущей строки.
➖ PARTITION BY — разбивка по группам (например, по пользователям или магазинам).
➖ ORDER BY — важный момент: он определяет, по какому порядку "сравнивать".

💻 Пример: считаем дельту выручки по дням.
Допустим, у нас есть таблица sales:
sale_date   amount
2024-06-01 1000
2024-06-02 1200
2024-06-03 800

Запрос:
select
sale_date,
amount,
amount - LAG(amount) OVER (ORDER BY sale_date) AS delta
FROM sales;

Результат:
sale_date   amount  delta
2024-06-01 1000 NULL
2024-06-02 1200 200
2024-06-03 800 -400

Что происходит в запросе?
➖ LAG(amount) OVER (ORDER BY sale_date) берёт значение за предыдущий день.
➖ amount - LAG(...) — рассчитывает дельту
➖ В первый день delta = NULL, ибо в первом ряду нет предыдущего значения

💻 Пример с группировкой по магазину.
Если у нас несколько магазинов в таблице store_sales:
store_id  sale_date    amount
1 2024-06-01 1000
1 2024-06-02 1200
2 2024-06-01 700
2 2024-06-02 900

Запрос:
select
store_id,
sale_date,
amount,
amount - LAG(amount) OVER (PARTITION BY store_id ORDER BY sale_date) AS delta
FROM store_sales;

➖ PARTITION BY store_id — Разбивает данные на группы по магазину. То есть, LAG() сравнивает значения только внутри одного store_id.
➖ ORDER BY sale_date — Определяет порядок, в котором будет вычисляться «предыдущее значение» — по дате продаж.
➖ LAG(amount) — Возвращает значение amount из предыдущей строки (внутри своей группы и в порядке дат).
➖ amount - LAG(amount) — Вычисляет дельту: текущий объём продаж минус предыдущий.

Что получится в результате:
store_id  sale_date   amount  delta
1 2024-06-01 1000 NULL
1 2024-06-02 1200 200
2 2024-06-01 700 NULL
2 2024-06-02 900 200


Доп.ситуация:
Если значения amount могут быть NULL, то delta будет NULL даже при корректном LAG(). Можно использовать COALESCE():
amount - COALESCE(LAG(amount) OVER (...), 0) AS delta


❗️Частые ошибки:
➖ Нет ORDER BY в OVER — дельта будет некорректной или всегда NULL
➖ Если даты перепутаны или дубликаты — ORDER BY может вести себя нестабильно. Лучше явно указать второй ключ (при этом в больших таблицах обязательно, читай принудительно, надо прописывать сорировку по нескольким ключевым столбцам иначе отработка запроса может давать нестабильные результаты, у вас будут буквально разные цифры при каждом перезапуске)
➖ Нет PARTITION BY, когда нужно сравнивать внутри группы, без оператора сравнение будет идти "вперемешку", не по логике.
➖ Сравнение разных типов данных — приводит к ошибкам или некорректным значениям.
➖ NULL-значения — дельта может стать NULL, если предыдущее значение отсутствует.

💻 Советы:
➖ Если нет LAG() в вашей СУБД — можно сделать JOIN таблицы самой на себя, но это медленнее.
➖ Дельту можно не только считать, но и фильтровать по ней (например: WHERE delta > 100).
➖ Вместо LAG() можно использовать LEAD(), чтобы сравнить с будущим значением.

#LAG #SQL

📱 Подписаться на канал
📱Мы в VK
💻 Курс автора по SQL DDL
  • 🔥 18
  • 👾 5
Post #91 635
Привет, вписался в конкурс каналов с качественным авторским контентом. Потом будут голосования за лучшие посты по номинациям среди каналов и все такое — здесь @tg_contest_main. Так что, не удивляйтесь, иногда буду просить вас голосовать))

Ну а вобще, я считаю, круто, что мой канал начинает участвовать в таких штуках, для меня это своеобразный признак оценки моих стараний (как и ваши реакции) 😁
  • 🔥 15
  • 🌚 3
  • 💯 3
Post #90 974
Когда удалил не ту таблицу. Ну, главное, чтобы не на проде 😂
  • 🤣 16
  • 🔥 5
  • 😱 3
  • 🌚 2
Post #89 729
Пишу пост про SQLi*, до конца недели опубликую. В июле, скорее всего буду много говорить о безопасности БД, методах их защиты, плюс затронем выдачу и управление правами пользователей в СУБД и бэкапы.

*⚠️SQL-инъекция (SQL injection)— это атака, при которой злоумышленник внедряет вредоносный SQL-код через поля ввода, например, на сайте (логин, пароль, поисковая строка), чтобы получить несанкционированный доступ к базе данных.
  • 🔥 9
  • 🌚 7
Post #88 706
👩‍💻 Специфические JOIN в SQL — тайные знания о соединениях

Итак, давайте разберем необычные виды join, про которые не так часто вспоминают, но они по своему прекрасны. Погнали.

💻 SELF JOIN — соединение таблицы с самой собой
SELF JOIN используется, когда нам нужно сравнить строки внутри одной и той же таблицы.
SELECT e1.name AS employee, e2.name AS manager
FROM employees e1
JOIN employees e2 ON e1.manager_id = e2.id;

Где полезен:
➖Связи типа «сотрудник – менеджер»
➖Поиск пар с определённым соотношением
➖Сравнение записей между собой (например, временных интервалов)

Обратить внимание:
➖ Обязательно используйте алиасы (e1, e2) — иначе SQL не поймёт, откуда брать данные.
➖ Производительность при больших таблицах может быть тяжёлой без индексов.

💻 CROSS JOIN — декартово произведение
Каждая строка из первой таблицы соединяется со всеми строками второй.
SELECT c.color, s.size
FROM colors c
CROSS JOIN sizes s;

Где полезен:
➖ Генерация всех возможных комбинаций (цвет + размер, дата + товар и т.д.)
➖ Математические переборы (в BI/аналитике)

Пример:
Таблица colors:
red
blue

Таблица sizes:
S
M
L

Результат:
color  size
red S
red M
red L
blue S
blue M
blue L

Обратить внимание:
➖ Растёт в геометрической прогрессии — при 100 строках в каждой таблице будет 10 000 строк в результате (100×100 = 10 000 строк)!
➖ Обычно требует явной фильтрации после соединения.

💻 NATURAL JOIN — соединение по совпадающим колонкам
Автоматически соединяет таблицы по колонкам с одинаковыми именами и типами.
SELECT *
FROM orders
NATURAL JOIN customers;

Где полезен:
➖ Быстрые выборки, когда точно знаешь схему таблиц
➖ Временные аналитические задачи или прототипирование

Обратить внимание:
➖ SQL сам решает, по каким колонкам соединять! Если колонок с одинаковыми именами много, можно получить непредсказуемый результат.
➖ Лучше не использовать в проде без явного указания колонок (ON), особенно если схему может кто-то изменить, потому что если структура изменится, все сломается.

💻 ANTI JOIN — найти то, чего нет
Ищем строки в первой таблице, у которых нет пары во второй.
На SQL делается через:
SELECT c.id
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
WHERE o.id IS NULL;

ИЛИ:
SELECT c.id
FROM customers c
WHERE NOT EXISTS (
SELECT 1 FROM orders o WHERE o.customer_id = c.id
);


Где полезен:
➖ Найти клиентов без заказов
➖ Найти товары без продаж
➖ Обнаружение "провалов" в связях

Обратить внимание:
➖ Вариант с NOT EXISTS работает быстрее при наличии индекса
➖ Убедитесь, что NULL действительно означает отсутствие связи, а не ошибку в данных

💻 SEMI JOIN — проверка на наличие
Найти строки из одной таблицы, у которых есть хотя бы одна пара в другой таблице, но не вытаскивать её. Забавно, но его синтаксис это JOIN без JOIN:
SELECT c.id
FROM customers c
WHERE EXISTS (
SELECT 1 FROM orders o WHERE o.customer_id = c.id
);

В отличие от INNER JOIN, мы не получаем orders.* — только customers.

Где полезен:
➖ Проверка: есть ли связи?
➖ Ускорение выборок, когда нужны только факты "да/нет"

Обратить внимание:
➖ Не получится использовать данные из второй таблицы (orders) в SELECT — она просто фильтрует
➖ Неявный тип соединения, часто путают с INNER JOIN
➖ Не вытаскивает данные из второй таблицы.

❗️ ANTI JOIN и SEMI JOIN — неофициальные типы (в ANSI SQL их нет), реализуются через LEFT JOIN + WHERE, EXISTS и т.п.

💻 Итого:
➖ SELF — Сравнивает записи одной таблицы
➖ CROSS — Сравнивает все на все, юзается для генерации комбинаций
➖ NATURAL — Сравнивает по одинаковым колонкам, используем при уверенности неизменности структуры таблиц или с ON
➖ ANTI — Выбирает всё, что не связано, используем для поиска отсутствий
➖ SEMI — Выбирает всё, что связано, пишется без оператора JOIN

Поддержка:
➖ SELF, CROSS, NATURAL — есть в большинстве СУБД (PostgreSQL, MySQL, Oracle, MS SQL)
➖ SEMI JOIN, ANTI JOIN — не имеют отдельного синтаксиса, реализуются через EXISTS / NOT EXISTS / LEFT JOIN + IS NULL
➖ В PostgreSQL и Oracle EXISTS работает особенно эффективно благодаря индексам.

#Join #SQL

📱 Подписаться на канал
📱Мы в VK
💻 Курс автора по SQL DDL
  • 🔥 14
  • 💯 4
Post #87 749
Привет, нашел прикольную шпаргалку по основным джоинам от ByteByteGo.

Для инфо, JOIN в SQL — это операция, которая позволяет объединять данные из двух или более таблиц по связанному столбцу (обычно по ключу: первичному и внешнему).

Ранее писал посты про базовые джоины, однако, есть еще куча необычных join-операторов, конечно, в обиходе не все они используются часто, но кто знает, куда неофитов могут завести скитания по базе данных 😂

Скоро напишу пост про специфические джоины.
Лайк если надо 👩‍💻
  • 🔥 29
  • 👾 4
  • 😱 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →