Ну и в продолжение
Что у других?
1. Процессы без частого человеческого ревью.Тут есть две концепции.
Первая - это мечтатели, которые все пытаются сделать полностью автономные"рои агентов", которые все сами. Пока это либо теоретики, у которых все на тестах как надо, и вообще теперь разрабы - это про что угодно, кроме кода. Либо практики, которые честно признаются, что пока ничего не получается, и деструктивные действия агентов другими агентами пока не купируются. Примеры: gas town и weaving loom.
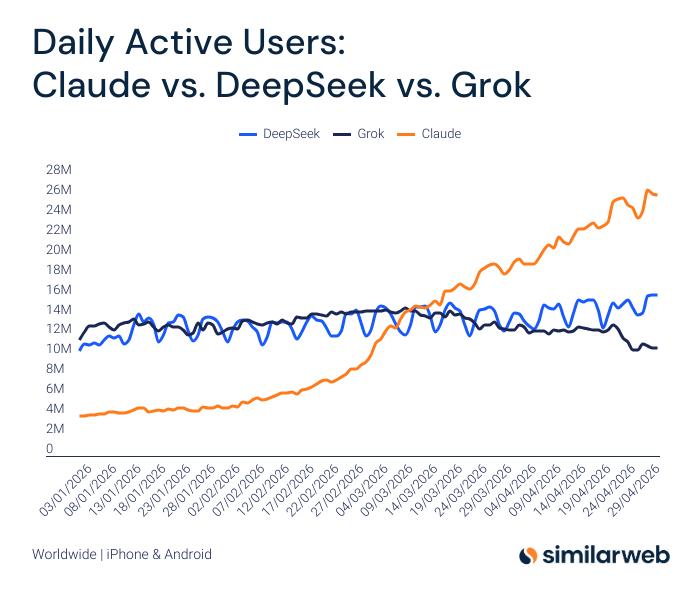
Вторая каста - это обычные разрабы и вайб-кодеры, которые по наивности своей считают, что можно и не ревьюить. Вы меня простите, конечно, но, все же, пока нельзя. Если думаете, что можно, посмотрите на график доступности Claude, и подумайте ещё раз.
2. Однослойные тесты.
Вот это здравая тема. Насколько я понимаю, большинство команд, которые все же внедрили полностью автоматическое тестирование в свои процессы, используют именно однослойное тестирование, и им обычно хватает. Но, как я уже написал, пока не тороплюсь в их лагерь.
В целом, думаю, superpowers + однослойные тесты + ревью глазами - дефолтный подход, который я бы рекомендовал всем, кто не хочет сильно запариваться. Это точно лучше, чем без тестов и ревью.
3. MCP-driven AI-manual тесты.
Вот это альтернативный вариант автоматического тестирования, который используют ребята, которые не очень умеют в обычные автотесты. В целом, это не постыдно не уметь. Я, например, очень редко видел разрабов, которые хоть что-то слышали про селениум.
А раз селениума нет, а фронт тыкать надо, то можно под это дело запрячь нейросеть. Ей даётся playwright-mcp и она отправляется тестировать интерфейс. И это ещё хорошо, если по одному и тому же тест-плану.
Какие тут проблемы? 3.1. Надёжность.
Нейросеть легко может сказать, что все проверила, и все работает, а на деле это будет не так по миллиону причин: не запустила проверки вообще, проверила не все; была проблема, но она ее посчитала нерелевантной, pre-existing или ещё чего.
3.2. Токеносжигание.
Playwright-mcp - самый страшный пожиратель токенов, который только можно придумать. Прогон сотни тестов легко сожрёт все ваше пятичасовое окно.
3.3. Время прогона.
Даже Selenium-тесты известны своей неторопливостью. Они не только завязаны на сеть, базу и даже, порой, шедуллеры, как апи-тесты, но и на многократное ожидание отрисовки и срабатывания элементов интерфейса.
А вот playwright-mcp тесты сюда добавляют ещё и обмен с mcp, и поход на север ллм, и болтологию ллм, и тупняк ллм.
Короче, это в десятки или даже сотни раз медленнее, чем обычные ui-тесты, которая сама нейросеть очень быстро и легко пишет. При этом это страшно дорого и, самое главное, совершенно ненадёжно. И в чем смысл ненадёжных тестов, я вообще не понимаю.
Заметьте, я не призываю использовать ui-тесты для тестирования функционала системы, это тоже не лучшая идея. Но даже в сравнении с нейросетевым ручным тестированием это лучше. Как правильно автотестировать приложения, я писал на Хабре
тут.
4. Хаотичный вайб-код.Тут ничего интересного я, если честно, не вижу. Народ на вайбе - как вайб-кодил полгода назад, так же это делает сегодня. Никакого прогресса я тут особо не наблюдаю. Эта группа плотно пересекается со всеми другими вышеописанными.
5. Экзотика.
Тут креативные ребята вовсю выдают разные фреймворки в меру своего понимания глубины проблемы.
Например, один товарищ очень нахваливает свой GRACE-фреймворк, который опирается на логи и автогенерированную документацию, встроенную в код. На выходе, по идее, получается, что llm лучше справляется со своими задачами.
Не знаю, насколько это реально может повлиять на процесс разработки. В моей работе LLM все свои задачи решает в пределах 7-10% контекста, код хорошо отрефакторен и довольно просто читается, а любое поведение легко воспроизводится тестами. При этом, я даже теоретически не очень понимаю, как можно протестировать, что этот фреймворк как-то помогает.