2️⃣При компиляции функции 𝚏𝚘𝚘 Python видит строку 𝚡 = 𝟸𝟶 и помечает 𝚡 как локальную переменную для всего тела функции.
3️⃣Когда функция вызывается и выполняется 𝚙𝚛𝚒𝚗𝚝(𝚡), Python ищет 𝚡 в локальной области видимости, но присваивание ещё не произошло — переменная существует, но не связана со значением.
4️⃣Выбрасывается UnboundLocalError: local variable 'x' referenced before assignment.
Почему это важно Эта ошибка часто сбивает с толку начинающих: кажется, что глобальная переменная должна быть видна, но наличие присваивания ниже по коду «перетягивает» её в локальную область. Решение — либо использовать 𝚐𝚕𝚘𝚋𝚊𝚕 𝚡, либо не переиспользовать имя глобальной переменной.
2️⃣Здесь 𝚜𝚝𝚊𝚛𝚝 = [] (пустой список), а элементы итерируемого — [𝟷, 𝟸] и [𝟹, 𝟺].
3️⃣Первый шаг: [] + [𝟷, 𝟸] → [𝟷, 𝟸].
4️⃣Второй шаг: [𝟷, 𝟸] + [𝟹, 𝟺] → [𝟷, 𝟸, 𝟹, 𝟺].
5️⃣Переменная 𝚛𝚎𝚜𝚞𝚕𝚝 получает этот список, и print выводит [1, 2, 3, 4].
Почему это важно Это «хакерский» способ сгладить список списков, но он неэффективен (квадратичная сложность из-за создания промежуточных списков); для реальных задач лучше использовать 𝚒𝚝𝚎𝚛𝚝𝚘𝚘𝚕𝚜.𝚌𝚑𝚊𝚒𝚗.𝚏𝚛𝚘𝚖_𝚒𝚝𝚎𝚛𝚊𝚋𝚕𝚎() или list comprehension.
2️⃣В условии 𝚢 := 𝚡 𝚘𝚛 𝚃𝚛𝚞𝚎 сначала вычисляется правая часть: 𝚡 𝚘𝚛 𝚃𝚛𝚞𝚎 → False or True → True.
3️⃣Затем walrus-оператор присваивает это значение переменной 𝚢, то есть 𝚢 = 𝚃𝚛𝚞𝚎.
4️⃣Условие if истинно (𝚢 равно True), поэтому выполняется print(y) и на экран выводится True.
Почему это важно Если бы разработчик хотел присвоить 𝚢 значение 𝚡, а потом проверить 𝚢 𝚘𝚛 𝚃𝚛𝚞𝚎, нужны скобки: (𝚢 := 𝚡) 𝚘𝚛 𝚃𝚛𝚞𝚎. Без понимания приоритета легко получить неожиданный результат.
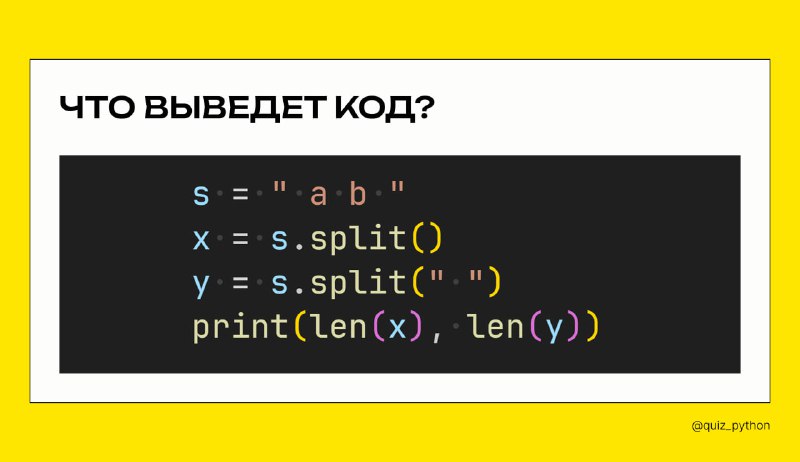
2️⃣Метод 𝚜.𝚜𝚙𝚕𝚒𝚝() воспринимает любую последовательность пробелов как один разделитель и игнорирует ведущие/завершающие, поэтому результат — ['𝚊', '𝚋'], длина 𝟸.
3️⃣Метод 𝚜.𝚜𝚙𝚕𝚒𝚝(' ') разбивает ровно по каждому пробелу: пробел в начале даёт '', затем '𝚊', затем '𝚋', пробел в конце даёт ''; итого ['', '𝚊', '𝚋', ''] — длина 𝟺.
Почему это важно Многие разработчики интуитивно считают, что 𝚜𝚙𝚕𝚒𝚝(' ') и 𝚜𝚙𝚕𝚒𝚝() — это одно и то же, но на практике разница критична при парсинге данных: логи, CSV-файлы или пользовательский ввод часто содержат лишние пробелы в начале/конце строк или двойные пробелы между словами. Если использовать 𝚜𝚙𝚕𝚒𝚝(' ') для такой строки, в результате появятся пустые элементы '', которые могут сломать дальнейшую обработку — например, 𝚒𝚗𝚝('') выбросит ошибку, а 𝚕𝚎𝚗(𝚛𝚎𝚜𝚞𝚕𝚝) покажет неверное количество «слов». Правило простое: если нужно разбить текст на слова — используй 𝚜𝚙𝚕𝚒𝚝() без аргументов; если нужно точное разбиение по конкретному символу с сохранением структуры — тогда 𝚜𝚙𝚕𝚒𝚝(' ').
1️⃣Вызов 𝚍𝚒𝚌𝚝.𝚏𝚛𝚘𝚖𝚔𝚎𝚢𝚜(['𝚊', '𝚋', '𝚌'], []) создаёт словарь с тремя ключами, но второй аргумент (пустой список) вычисляется один раз, и все три значения указывают на этот единственный список.
2️⃣Когда выполняется 𝚍['𝚊'].𝚊𝚙𝚙𝚎𝚗𝚍(𝟷), элемент 𝟷 добавляется в тот самый общий список.
3️⃣Поскольку 𝚍['𝚋'] и 𝚍['𝚌'] ссылаются на тот же объект, при печати видно {'a': [1], 'b': [1], 'c': [1]}.
Почему это важно Это классическая ловушка при инициализации словарей со значениями-списками; правильный способ — использовать dict comprehension: {𝚔: [] 𝚏𝚘𝚛 𝚔 𝚒𝚗 𝚔𝚎𝚢𝚜} или 𝚍𝚎𝚏𝚊𝚞𝚕𝚝𝚍𝚒𝚌𝚝(𝚕𝚒𝚜𝚝).
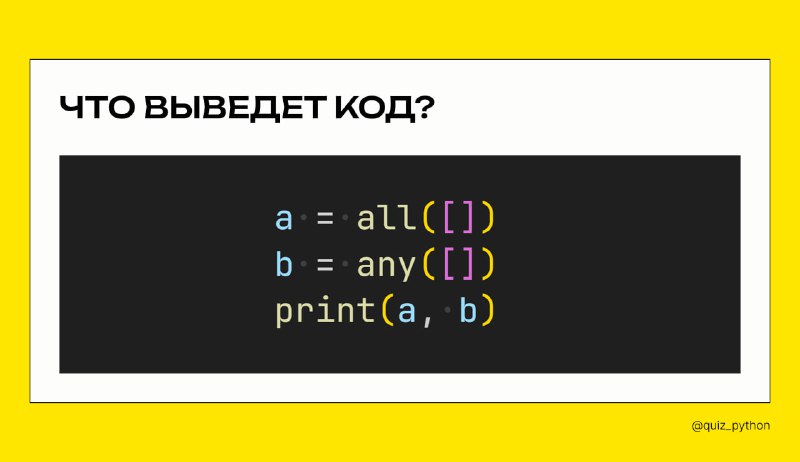
🔘Функция 𝚊𝚕𝚕(𝚒𝚝𝚎𝚛𝚊𝚋𝚕𝚎) проверяет, все ли элементы истинны; внутри она перебирает элементы и возвращает False, как только встречает ложный; если цикл завершился без такого элемента — возвращает True.
🔘Для пустого списка цикл не выполняется ни разу, поэтому сразу возвращается True — переменная 𝚊 получает значение True.
🔘Функция 𝚊𝚗𝚢(𝚒𝚝𝚎𝚛𝚊𝚋𝚕𝚎) работает наоборот: возвращает True, как только встречает истинный элемент; если таких нет — возвращает False.
🔘Для пустого списка нет ни одного истинного элемента, поэтому 𝚋 получает False, и print(a, b) выводит True False.
Почему это важно Это поведение часто ломает логику валидации: проверка 𝚊𝚕𝚕(𝚌𝚘𝚗𝚍𝚒𝚝𝚒𝚘𝚗𝚜) пройдёт, даже если список условий пуст, что может быть не тем, что ожидалось.