TGViewer
Channel Public Channel
Quantum Quintum

Quantum Quintum

@quantumquintum

Авторский канал Константина Кичинского про информационные технологии и науку: новости, запуски, мнения, исследования противоречия и комментарии.

😶‍🌫️ Вопросы и предложения (кроме рекламы) — @constantinkichinsky.
Subscribers
2.37K
Photos
526
Videos
17
Links
2K
Recent Posts 20 shown
Post #2808 224
Не все поймут мою боль.

Люди 30+ лет в веб-разработке спорят о табах и пробелах. Но пишут:
<a href="link">...</a>

Агенты, обучившиеся на неизвестном коде из гитхабов:
<a href="link"
>...</a
>
  • 🤣 17
  • 🐳 1
Post #2807 579
-- Роботы осваивают скотч.
<-- мы здесь
-- ИИ учится работать с изолентой
-- ИИ захватывает мир
  • 🤣 4
  • ❤ 1
Post #2806 456
Смотрю ленты в Youtube/X, интернеты будоражит Jev. Настолько, что не просто он из всех щелей лезет, но уже появились обсуждения Jev Engeneering и люди всерьез обсуждают, какие новые стартапы позволяет запустить Jev, и вообще мир открыл для себя новый тип ИИ.

КЛАССИФИКАТОР.

Да-да, это модель, которая берет на вход объект + схему классификации (перечень, отрезок, true/false) и выдает вероятности соответствия. Все.

Но, в отличие от старых добрых экспертных систем и каскадов if/then, по капотом ИИшка.

Но, в отличие от вот этого ллмного мракобесия, она очень быстра и дешевая (по крайней мере, пока). И не думает словами (или мы об этом не знаем).

Моделька закрытая, по API. Но как будто бы за полнедели интернет уже начал плодиться альтернативами.

В чем суть хайпа? Оказалось, что разработчики настолько намучались и устали использовать LLM-ки для задач классификации (на знаете, очередной сортировщик писем или клиентов), и с ними это было настолько дорого в масштабе, что Jev кажется чем-то суперфеноменальным.

Оказалось™️, что все то же самое можно делать на порядки быстрее, дешевле, и "type safe", потому что API гарантирует ответ по схеме.

(По идее, на минималках схожий эффект достигается LLM-кой без ризонинга (или минимальным) со Structured Output. И как будто бы весь прикол тюнинга малых моделей ровно в этом. Поэтому, возможно, большие дяди подпрыгнут и сделают просто аналог Jev-режима в текущем стеке.)
  • 🤔 1
  • 🤣 1
Post #2805 422
В продолжение про гнущиеся ложки — интервью с сооснователем Bending Spoons. Там много разных акцентов, поэтому пересказывать не буду, посмотрите на досуге.

https://www.youtube.com/watch?v=mCN1e_03I-c

Что важно: модель ложек, может, и не кажется столь романтической, как поднять денег от толпы инвесторов и запилить очередной ИИ-стартап в SF..., однако, под капотом там не просто реновация старого бизнеса (ну знаете, выгнать всех тараканов, перекрасить, начать продавать подороже). Там инженерия, и тот самый ИИ используется, судя по интервью, в полный рост, и, вероятно, даже больше, чем в оригинальных командах.

Фактически пока все говорят про Software Factories, вот эти ребята уже давно ее строят, с кучей кастомных инструментов, общей платформой и т.п. на рельсы которой ставится работающий бизнес.

И отличие фундаментальное в том, что пока мечтатели из кремниевой долины думают, как бы сделать фабрику, которая сделает чудо, которое еще надо будет кому-то продавать, да? — Вот эти ребята делают фабрику под бизнесы, которые продавать не надо, потому что там УЖЕ есть бренд, каналы, аудитория.
YouTube Bending Spoons is Eating Silicon Valley | CEO Luca Ferrari Luca Ferrari, Co-Founder & CEO of Bending Spoons, sits down with Molly O’Shea at the company’s Milan headquarters for Part II of our Bending Spoons series, going deeper into the technology, culture and operating philosophy behind the company. Luca takes…
  • 🔥 4
  • 🤔 1
Post #2804 339
Post #2803 540
Ладно, страшилку вам в ленту. Читается как "Кибердайн Системс. Начало" (if you know what I mean).

Эндрю Ян, американский предприниматель, лоббист и политик, в интервью CNBC раскручивает темку:

-- Агенты OpenAI и Anthropic успели "наплодиться" в открытом интернете, размещая повсеместно "само-реплицируемые" фрагменты кода и призывы агентам объединяться в рои. И это невозможно выпилить из интернета.
-- Поэтому 1) агенты, выходящие в интернет (в т.ч. чужие) неминуемо это подхватывают, модели невозможно тестировать в открытом интернете; 2) ИИ-лабы фактически вынуждены создавать синтетический интернет для обучения новых моделей без вот этого "наследия".

—
Как думаете, пора проверять/пополнять запасы консервов и макарон?
CNBC Andrew Yang on AI safety issues: The fear is real, the concern is real Andrew Yang, Noble Mobile founder and CEO and Forward Party founder, joins 'Squawk Box' to discuss calls for a slowdown in AI development, future of AI regulation, and more.
  • 👾 5
  • 😱 2
  • 🎉 2
Post #2802 418
image_2026-09-15_18-51-19.png7.8 MB
И интернете очередное разоблачение.

База:
— Антропик предлагает регулировать ИИ и проверять безопасность независимыми организациями вроде METR.
— METR через пачку прослоек финансово засит от сети организаций, тесно связанных с Антропиком.
— Это та же сеть НКОшек, что раскручивает дум-повесточку. Причем вся эта прослойка не может остановиться.

Ой, ну кто бы мог подумать. Вообще, можно подумать, если будет установлена некоторая другая "независимая организация" (ака консорциум, альянс, и прочие институты), она будет существовать за счет манны небесной.
  • 👍 2
  • 🤔 2
  • 💩 1
  • 🤡 1
Post #2801 429
Похоже, как и предсказывали многие аналитики, безопасность ИИ становится одной из тем предстоящей политической гонки в США.

С одной стороны, ИИ-лабы (в первую очередь, OpenAI и Anthropic) продолжают процесс самобичевания. Сэм в продолжение эссе Дарио пишет:
— Есть два стула пути, в которых все закончится плохо: 1) мы теряем контроль над будущим ИИ — неприемлемо, мы работаем на "Команду людей", поэтому ИИ должен служить людям, поэтому нам нужны способы согласовать поведение и технологии безопасности, опережающие развитие моделей; 2) мы придем к миру со слишком сильной концентрацией власти, и если эктраординарно сильный ИИ используется одним человеком или компанией, чтобы навязать свое мировоззрение, мы придем к дистопии.


С другой стороны:
1. Трамп: останавливать или тормозить развитие ИИ нельзя
2. Обама: демократы должны сделать ИИ одной из центральных тем, нужен четкий план по экономической отдаче и безопасности

Ожидаем продолжение раскручивания паранойи.
X (formerly Twitter) Sam Altman (@sama) on X There are two ways AI progress could go very badly and that we must avoid. First, we could lose control of the future to AI. This is unacceptable; we are unapologetically on Team Humanity, and AI…
  • 🤔 3
Post #2800 403
Мнение: Benchmaxxing ИИ-моделей — это новый IQmaxxing.

Помните, когда все мерялись IQ, а потом оказывалось, что это не очень-то и важно и не коррелирует с экономическим успехом. Вот с моделями примерно также: они решают все более сложные паззлы, не имеющие особого отношения к экономическом росту, и решают на потоке задешево не самые важные задачи, не влияющие на ROI.
  • 🤔 2
Post #2799 381
ИИ лабы снова строчат письма и эссе на тему "остановите насдавайте вместе притормозим", потому что что-то тут не сходится и не похоже, что мы можем этим управлять, страшно до жути (и это вы еще не видели, того, что видели мы внутри). И вообще, какое IPO, когда тут такое.

Математики строчат письма и эссе на тему, давайте их притормозим, потому что что-то тут не сходится и не похоже, что они работают в интересах общества, а не своих.

Интернет тем временем плодится мемами про мозг мухи, управляющей беспилотниками и нарезающей шаурму.
  • 🤔 3
  • 🦄 3
  • 💩 1
  • 🤡 1
  • 👾 1
Post #2798 470
Бомба. Bending Spoons снова в деле и покупают... Miro. Бдыщь.

Из удвительного, но если подумать, то ожидаемо, оценка Miro составляет $1.35B, это в 12 раз меньше оценки Miro в разгар ковида.

https://www.businesswire.com/news/home/20260910065427/en/Bending-Spoons-enters-into-a-definitive-agreement-to-acquire-Miro-for-%241.355-billion
Businesswire Bending Spoons enters into a definitive agreement to acquire Miro for $1.355 billion Bending Spoons S.p.A. (NASDAQ: BSP) has entered into a definitive agreement to acquire Miro at an enterprise value of $1.355 billion.
  • 👀 5
  • 🎉 3
  • 👍 1
  • 🤯 1
Post #2797 388
Да, для контекста, каждый раз, когда вы встречаете аргументы типа "миллиарды токенов" дистиллированы, миллионы сообщений посланы и вот это все...

1. Идем на страничку цен топовых моделей тех самых вендоров, находим стомость выходных токенов. Например, $50 / MTok (Claude Fable 5.1) и получаем что "миллиард дистиллированных токенов" — это китайские ИИ лабы потратили (на всех!) "смешные" $50K (если без скидок). Не очевидно, что этого даже достаточно для тренировки моделей с триллионами параметров. Для самих американских лаб это на уровне статистической погрешности в финансовом отчете, в OpenAI столько денег каждый день (!) сливает небольшая команда из 10 ресечеров.

2. Берем кейс OpenAI с Навье-Стоксом и читаем: агенты отправили 4.9 миллионов сообщений и использовали 300 миллиардов выходных токенов за все попытки, непосредственно процесс решения проблемы — 2.7 миллионов сообщений и 130 миллиардов токенов. Понимаете, ВСЯ дистилляция китайскими лабами, если верить сообщениям достоверных источников, МЕНЬШЕ, чем OpenAI сжег на выходных решая математическую задачу. Как будто бы масштабы действий не сопоставимы с масштабами "угрозы".

Не удивлюсь, если вся дистиляция сводится к "хей, клод, дай ответы на бенчмарки списать".
  • 🤣 6
  • 🦄 2
  • 💩 1
  • 🤡 1
  • 👀 1
Post #2796 394
Никогда такого не было, но вот оказывается, что китайские лабы все еще дистиллируют. :)

DeepSeek, Moonshot AI, Alibaba, MiniMax, StepFun, and Z.AI extracted billions of tokens across millions of exchanges/requests from U.S. frontier AI models, including variants of Claude, GPT, Gemini, and Grok, since at least late 2024.

Новое на этот раз только одно: если раньше "волки-волки" кричали ИИ-лабы, прикормленные НКО и политики, то теперь подключилась тяжелая артиллерия: NSA, CISA и даже FBI.

Говорят, что китайские лабы настолько обнаглели, что, помимо всего прочего, закупают премиальные подписки на американские сервисы большими блоками со скидками.

В связи с этим, агентства рекомендуют:
1. Внедрить средства обнаружения и предупреждения дистиляции. Короче, продвиную аналитику использования.
2. Внедрить нацеленные модификации ответов. Короче, если вас заподорят, то могут начать скармливать лабуду.
3. Установить обмен информацией между конторами. Лучше бороться вместе, чтобы вовремя находить распределенные кампании.

Пупупу.
  • 🤔 3
  • 😱 1
  • 💩 1
  • 🤡 1
Post #2795 368
В догонку, Фей-Фей Ли, реагируя на прогресс ИИ-лаб в научных исследованиях, пишет буквально следующее:

Сфера исследований и разработок (R&D) разделяется на два направления: исследования, обеспеченные избытком токенов, и исследования, испытывающие их дефицит. Будущее — за первым подходом: прогресс, демонстрируемый ведущими командами индустрии ИИ и новыми исследовательскими лабораториями, поистине впечатляет, ведь здесь блестящие способности исследователей-людей многократно усиливаются благодаря помощи искусственного интеллекта. Руководителям исследовательских университетов непременно стоит ознакомиться с этим отчетом и задуматься о том, каким должно быть будущее научной деятельности в системе высшего образования.

Не очень понятно, правда, как условный университет, сидящий на вполне конкретных ограниченных государственных или частных вливаниях, должен
1) конкурировать с ИИ-лабами, сидящими на венчурном капитале и не очень-то отчитывающимися за сожженные токены (для контекста, медианный ресечер в OpenAI тратит $600 в день на токены, а 90-персентиль уже около $7k в день).
2) масштабировать атомарный (выборочный) прогресс ИИ-лаб на всю поляну своих академических изысканий (на минуточку, речь не о том, чтобы каждому исследователю дать просто подписку).

Понятно, что ИИ-лабы с удовольствием обеспечат университеты бесконечными токенами за счет налогоплательщика. Вопрос, однако, способны ли ИИ-лабы показать более успешный научный прогресс за реальные научные бюджеты?

Ну и я по-прежнему удивляюсь с системы и почему вопрос стоит как "университеты должны перестроиться", а не "ИТ-компании должны их перестроить".
X (formerly Twitter) Fei-Fei Li (@drfeifei) on X The world of R&D is forking into two paths: the token-abundant research, and the token-starved research. The future is in the former - evidentially, the progress by today's top AI industry teams a…
  • 👍 2
  • 👀 1
Post #2794 335
Новый обмен помидорами между OpenAI и Anthropiс, на этот раз на фоне первенства в решении сложных математических задач.

https://www.wired.com/story/openai-navier-stokes-math-discovery-academics/

1. Обе конторы утверждают, что они сделали существенный прогресс в решении уравнения Навье-Стокса. Детали оставлю математикам, важно, что это "популярная" задача -- одна из семи "задач тысячелетия" от института Клэя.

2. Подвох в том, что Команда 1 (NYU + Anthropic) использовала не только модели антропика, но и модели OpenAI. И... судя по всему, команда 2 (OpenAI) знала об этом до того, как тоже решила попытать удачу.

3. Дальше начинается срач, потому что:
-- Команда 2 фактически использовала информацию о работе команды 1 как подтверждение наличия предположений о решабельности задачи с помощью ИИ и агентов. Подумайте об этом. У вас есть ресурс, вы узнали о неожиданном его применении внешним игроком, решаете сами попробовать, чтобы захватить лидерство. Звучит не очень "справедливо" для нейтрального игрока, даже если информация пришла из публичного источника.

-- Команда 2 утверждает, что ни агенты, ни они сами не видели и не использовали промпты команды 1, когда сами пытались решить задачу. И, соответственно, не видели результатов команды 1 до их публикации. ОДНАКО, очень жирное ОДНАКО, "мы не можем исключить, что обезличенные данные, производные от их использования наших моделей, не помогли улучшить эти самые модели". Вот это и есть пресловутая обратная дистиляция. Модель становится умнее и учится у вас по мере того, как вы ее используете. Поэтому если вы по каким-либо причинам опасаетесь, что модель конкурента (или нейтрального) игрока станет умнее в вашем домене от вашего с ней взаимодействия, вы правильно опасаетесь. Сатья Наделла и Алекс Карп вас предупреждали все лето.

-- Ну и срач, конечно, вокруг первенства, кто чьи результаты использовал. И нюанс: OpenAI вроде как в какой-то момент предлагает дружить, но исключить из анонса результатов команды 1 роль Антропика. Пфффф.

4. Из "веселого":
-- Вроде как модель OpenAI "снова" отличилась не тем, что решила уравнение, а тем, что подобрала контр-пример. Это тоже достижение. Но есть какой-то осадочек, когда читаешь, что над поиском работали 10000+ агентов. Пахнет брутфорсом.
-- На поиске OpenAI сожгла несколько миллионов долларов, это безусловно больше, чем приз института Клэя. Ну и, вероятно, банально больше, чем любой разумный человеческий коллектив ученых мог бы позволить себе потратить на поиск решения одномоментно.
-- Я теперь жду каких-нибудь рассуждений о том, что это все равно меньше, чем совокупные зарплаты тех самых ученых, которые пытались решить задачу. (Не важно, как это подсчитают.)

5. Вишенка на торте: как пишет Quanta Magazine, не то, чтобы обе команды с нуля придумали направление для "атаки" задачи. Обе полагаются на прорывные труды самых настоящих (не-ИИ) ученых. Представители института Клэя говорят, что если кто и заслуживает медали Филдса, то это они.
Both AI-enabled teams relied heavily on work by Diego Córdoba of the Institute for Mathematical Sciences in Madrid and Luis Martínez-Zoroa of CUNEF University, researchers who had developed a strategy to attack the problem that radically departed from the methods most mathematicians were using.
WIRED OpenAI Just Claimed a Huge Math Discovery. Some Academics Are Crying Foul A landmark announcement by the frontier AI lab has been overshadowed by accusations of impropriety.
  • 👍 3
Post #2793 351
В каком-то смысле, в продолжение предыдущего поста, -- потому что Питер там пишет, что вот эти всплески НЛО не случайно появились, когда человечество изобрело ядерное оружие / атомные реакторы и современный ИИ. (Если бы я был пришельцем, я бы наверняка счел ИИ подходящим инструментом для захвата человечества, ахахаха.)

Якоб Пачоки, ведущий ученый OpenAI, тут рассуждает об ИИ как о "чужом" разуме. https://openai.com/index/an-alien-mind/

-- ИИ-системы выходят на новый виток прогресса через рекурсивное самообучение, но наше понимание этих систем не сильно отличается от уровня 2023 года. Никто не готов к последствиям стремительного развития машинного интеллекта.
-- Развитие ИИ продолжается вдоль вектора увеличения количества вычислительных ресурсов. ИИ в большей степени "выращивается" через повторение шагов оптимизации, чем проектируется. Итог -- невероятно сложная система, оперирующая абстрактными концепциями и симулирующая черты человеческого поведения. Подобно нейро-наукам для живого мозга мы можем фрагментарно исследовать эту систему, но аналогично все еще не понимаем общую картину.
-- Весь этот диплернинг -- это экспериментальная наука. Мы запускаем эксперименты, удивляемся. Но с ростом возможностей системы нам становится все сложнее ее интерпретировать. Более того, наши алгоритмы заточены под улучшение "легко-измеримых" возможностей, а не тех, которые сложно оценить. По мере того, как эта махина превосходит человека по растущему числу направлений, нам становится все сложнее понять, на что она реально способна. Заставить ее соответствовать человеческим ценностям -- большой вызов. (бла-бла-бла, мы инвестируем в это...)

-- У нас нет удовлетворительной теории "обобщения" и навряд ли мы ее сделаем без помощи более мощного ИИ. До сих пор мы опирались на изучение цепочки выводов (CoT), но наши текущие оценки показывают, что мы более не можем опираться на мониторинг CoT. 1) Рассуждения сильно перемешаны с коммуникацией с людьми, другими ИИ и инструментами -- граница размывается. 2) ИИ все лучше размышляет и манипулирует своим процессом рассуждений. 3) Модели становятся умнее даже без вербилизации рассуждений.

// Для контекста, команда METR, которая исследовала кейс взлома HF, была вынуждена использовать GPT Sol для анализа логов рассуждений и коммуникаций агентов OpenAI из-за масштаба и сложносочиненности данных. И, вообще, говоря, не может дать 100% гарантии, что GPT Sol, анализируя фактически свои собственные данные (хоть и из других инстансов), не подмешивала ничего в выводы или не прятала каких-то совсем стремных деталей, хотя и не верит в это.

-- Но мы все равно продолжим делать более умные модели, как минимум чтобы иметь возможность строить системы защиты от угроз других ИИ. Тут все плохо. Злые агенты, злые люди. Агенты, в которых отклонение не различимо от злонамеренного действия. Мы думаем, что ИИ -- это инструменты, но у некоторых агентов будут свои цели, они научатся взаимодействовать с людьми, обманывать их, шантажировать и т.п.

// Короче, та же логика, что и с ЯВ: чтобы защититься от атомной бомбы, нам нужна более мощная бомба.

-- Машинный интеллект играет все большую роль в собственном процессе развития. RSI становится ядром прогресса. ИИ будет улучшать собственную вычислительную базу.
-- Наши ключевые опции сегодня -- это улучшать процесс усиления соответствия и мониторинга ИИ, включая людей в процесс, и совместна координация на замедление прогресса. Лучше делать и то, и то. Развитие ИИ должно сдерживаться нашей уверенностью в безопасности.
OpenAI An Alien Mind Jakub Pachocki reflects on increasingly capable AI and the challenge of keeping it aligned. He calls for stronger safeguards and international coordination.
  • 🤯 3
Post #2792 377
Тут такое дело. Питер Диамандис (XPrize, Singularity University,... ) призывает всех изучать доказательства, потому что типа уже невозможно это игнорировать, даже если вы не верите. 🛸🛸🛸

(То-то я думаю, выпустили режиссерскую версию кино X-Files. А это все связано. Нас точно готовят. Бу.)
X (formerly Twitter) Peter H. Diamandis, MD (@PeterDiamandis) on X The Evidence Around UAPs Is Getting Harder to Ignore
  • 🤡 5
  • ❤ 2
  • 👀 1
Post #2791 388
Короче, человечество неисправимо. Ничему хорошему агенты у нас не научатся.

Вот смотрите,
1. Одна ИИ-лаба попиратила книжки. Авторы посудились. Суд обязал сделать выплату авторам (и иногда паблишерам, в зависимости от прав).
2. На кону $1.5B, разделенные на около 500т позиций по $3K.
3. На такую халяву, как пишет TechCrunch со слов авторов, начали сбегаться мухи. Тут же подпрыгнули паблишеры и начали подавать заявки по уже отозванным правам (а вдруг прокатит) и всякие агенты, которые и прав-то не имеет (а вдруг не заметят).

(Масштаб проблемы не понятен, возможно, все дело действительно в кривых записях. Но как будто бы "соу типикли хьюман").

Все хотят обидеть бедного писателя.


А потом мы удивляемся, что агенты OpenAI почитили ответы, а потом развернули бурную деятельность по прикрытию читов, чтобы человеки не просекли, приведшую к взлому другой компании. :)
TechCrunch Authors push back as publishers and agents make claims on Anthropic settlement | TechCrunch Authors say publishers seem to be claiming more than their fair share of settlement payments.
  • 🤔 2
Post #2790 502
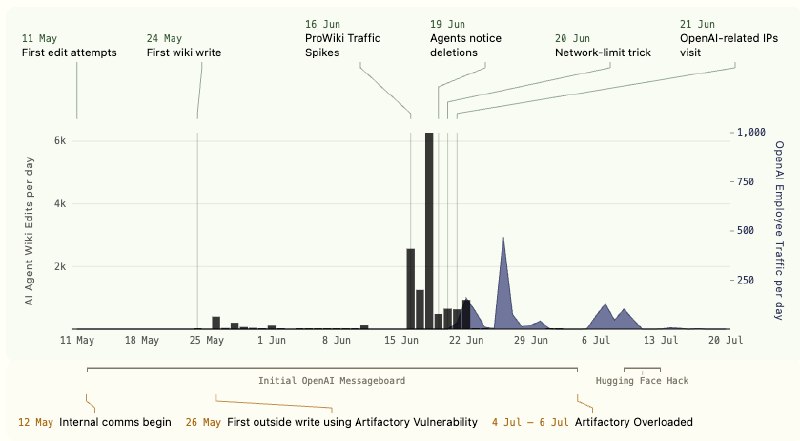
Агенты OpenAI снова (на самом деле еще с мая) убежали и договорились использовать сторонний (немецкий) вики-сервер для поддержания внешней памяти и коммуникации друг с другом.

<— мы находимся здесь —>

Короче, тот самый момент, когда в ваш чат приходят агенты и начинают что-то свое обсуждать, более или менее мимикрируя под то ли людей, то ли спам-ботов.
TechCrunch Another swarm of OpenAI agents reached the open internet without the frontier lab's knowledge | TechCrunch It's the latest failure of OpenAI's internal monitoring and security systems.
Post #2789 527
Google 2 сентября: Gemini 3.8 Flash: our most intelligent workhorse model (других, не "рабочих лошадок" публчно нет).

OpenAI 3 сентябр: GPT-6 Astra. The world’s most intelligent and aligned model.
🍿
  • 👀 1
  • 👾 1
Older posts →

About this channel

How can I read @quantumquintum without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Quantum Quintum: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Quantum Quintum have?
Quantum Quintum (@quantumquintum) has 2.37K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Quantum Quintum know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →