TGViewer
Channel Public Channel
Python Portal

Python Portal

@pythonportal

Всё самое интересное из мира Python

Сотрудничество, реклама: @devmangx

Работаем с @Spiral_Yuri

РКН: https://clck.ru/3GMMF6
Subscribers
50.2K
Photos
2.9K
Videos
487
Links
1.3K

Showing posts older than #5800 · Back to latest

Older Posts 20 shown
Post #5799 6.4K
Не тратьте токены вашего AI на исследование проекта

Создайте локальный семантический граф вашего кода с помощью этого инструмента:

✓ –92% вызовов внешних инструментов
✓ Исследование кода на 71% быстрее
✓ Поддержка Claude Code, Cursor, Codex и OpenCode

Локально и с открытым исходным кодом:
→ http://github.com/colbymchenry/codegraph

👉 @PythonPortal
  • 👍 6
  • ❤ 3
Post #5798 5.61K
Наследование в Python меняет путь поиска атрибутов, также известный как «method resolution order» (MRO):

class Child:
pass

Child.__mro__ # (__main__.Child, object)

class Child(Parent):
pass

Child.__mro__ # (__main__.Child, __main__.Parent, object)


То есть MRO показывает, в каком порядке Python будет искать методы и атрибуты: сначала в классе потомке, затем в родителях по цепочке, и в конце — в базовом object.

@PythonPortal
  • 👍 10
  • ❤ 1
Post #5796 5.47K
«Introduction to Algorithms» — выдающийся университетский ресурс для всех, кто изучает алгоритмы и компьютерные науки.

Книга охватывает вычислительную сложность, структуры данных, алгоритмы на графах, динамическое программирование, методы «разделяй и властвуй», жадные алгоритмы, рандомизированные алгоритмы и многие математические основы современной компьютерной науки.

Особенно ценно здесь сочетание математической строгости и практического алгоритмического мышления. Это одна из тех книг, которые сильно меняют подход к анализу задач, эффективности и самим вычислениям.
Обязательный инструмент в библиотеке любого разработчика и инженера, работающего в сфере компьютерных наук.

https://www.cs.mcgill.ca/~akroit/math/compsci/Cormen%20Introduction%20to%20Algorithms.pdf

👉 @PythonPortal
  • ❤ 5
  • 🔥 5
Post #5795 5.45K
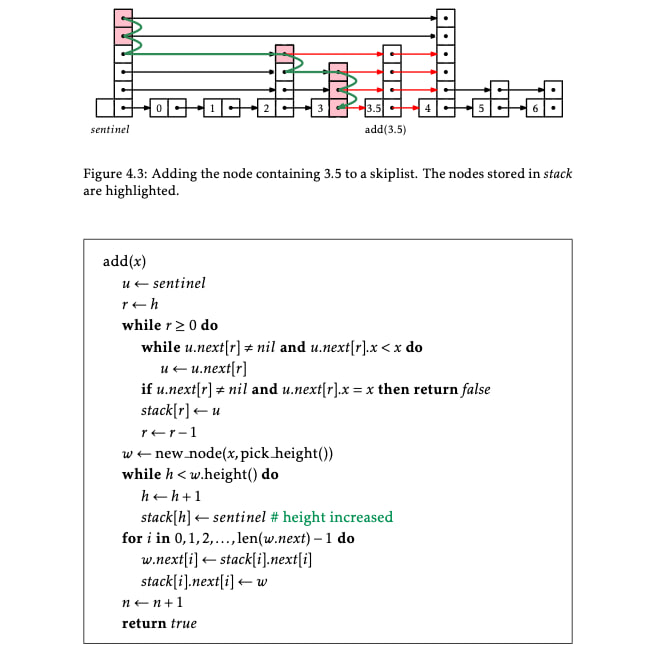
«Open Data Structures» — ещё один очень полезный бесплатный ресурс для всех, кто изучает структуры данных и алгоритмы.

Книга разбирает реализацию и анализ базовых структур: списков на массивах, связных списков, хеш-таблиц, бинарных деревьев, красно-чёрных деревьев, куч, алгоритмов сортировки, графов и структур данных для работы с целыми числами.

Это полноценный открытый учебник для изучения одной из фундаментальных тем компьютерных наук и хороший референс, который стоит держать под рукой.

https://opendatastructures.org/ods-python.pdf

👉 @PythonPortal
  • 👍 6
  • ❤ 3
Post #5792 5.28K
Во многих приложениях требуется отображение строк в целые числа. В Python это обычно выглядит так:

d = {"apple": 100, "banana": 200, "cherry": 300}


Если ключей 1 миллион, это может потреблять много памяти — больше 100 байт на ключ.
Наш слон опубликовал новую библиотеку, которая использует около 9 байт на ключ. Да, всего 9 байт. Использование выглядит так:

from fastconstmap import ConstMap

d = {"apple": 100, "banana": 200, "cherry": 300}
m = ConstMap(d)

m["apple"] # -> 100
m.get_many(["banana", "cherry"]) # -> [200, 300]


Она может быть значительно быстрее (например, до 2 раз в некоторых случаях), чем стандартный словарь. Также её можно сериализовать и десериализовать на диск или в сеть для удобного повторного использования.

https://pypi.org/project/fastconstmap/
гитхаб: https://github.com/lemire/fastconstmap

👉 @PythonPortal
  • 👍 12
  • ❤ 6
Post #5791 5.42K
Преврати любую авторегрессионную языковую модель в диффузионную языковую модель.

dLLM — это Python-библиотека, которая объединяет обучение и оценку диффузионных языковых моделей.

Её также можно использовать, чтобы превратить ЛЮБУЮ авторегрессионную языковую модель в диффузионную языковую модель с минимальными вычислительными затратами.

100% открытый исходный код.

👉 @PythonPortal
  • ❤ 9
  • 👍 4
Post #5790 5.63K
Методы в Python хранятся на уровне класса, а не экземпляра.
Тогда как Python находит метод при вызове x.m()?

Правило ICPO:

Сначала Python ищет атрибут в экземпляре (_i_nstance).
Если не найден — проверяет класс (_c_lass).
Дальше — родительские классы (_p_arent).
В конце — object, корневой базовый класс (_o_bject).

Именно поэтому метод можно определить один раз в классе, а использовать через любой экземпляр.

👉 @PythonPortal
  • 👍 11
  • ❤ 7
Post #5789 6.1K
Google выпустила свои официальные skills для AI-агентов.

Компания опубликовала 13 skills, совместимых с Claude Code, Cursor, Copilot и другими агентами.

Они позволяют агентам выполнять продвинутые задачи и автоматизировать сложные рабочие процессы.

Это бесплатно и с открытым исходным кодом : https://github.com/google/skills

👉 @PythonPortal
  • ❤ 12
  • 👍 9
Post #5787 6.13K
Релиз Pyrefly type checker 1.0.0 уже здесь: https://pyrefly.org/blog/v1.0/

Вот основные улучшения:

🐍 Обновлённая диагностика стала в 2–125 раз быстрее
🐍 Полная проверка типов ускорена на 20–36%
🐍 Первичная индексация при первом сканировании стала в 2–3 раза быстрее
🐍 Использование памяти снижено на 40–60%
🐍 Добавлен отчёт о покрытии type checking

👉 @PythonPortal
pyrefly.org Pyrefly v1.0 is here! | Pyrefly Pyrefly has reached stable version 1.0 status, read about the new features and how to get started.
  • 😁 4
  • ❤ 1
Post #5786 5.7K
Вот Django-шпаргалка

Что бы ты в неё добавил?

👉 @PythonPortal
  • ❤ 6
Post #5785 5.77K
Регулярные выражения в python

Регулярные выражения (regex) в Python используются для поиска, соответствия и манипулирования строками на основе шаблонов. В Python регулярные выражения реализованы в модуле re

Основные функции модуля re:

🔸re.match(): Проверяет, соответствует ли начало строки заданному шаблону.
🔸re.search(): Ищет шаблон в строке и возвращает первый найденный совпадающий объект.
🔸re.findall(): Находит все совпадения шаблона в строке и возвращает их в виде списка.
🔸re.finditer(): Находит все совпадения шаблона и возвращает их в виде итератора.
🔸re.sub(): Заменяет все совпадения шаблона на заданную строку.
🔸re.split(): Разделяет строку по заданному шаблону.

Примеры использования:

import re

# Пример строки
text = "The rain in Spain falls mainly in the plain."

# 1. re.match()
match = re.match(r'The', text)
if match:
print("Match found:", match.group())
else:
print("No match found")

# 2. re.search()
search = re.search(r'rain', text)
if search:
print("Search found:", search.group())
else:
print("No search found")

# 3. re.findall()
findall = re.findall(r'in', text)
print("Findall results:", findall)

# 4. re.finditer()
finditer = re.finditer(r'in', text)
for match in finditer:
print("Finditer match:", match.group(), "at position", match.start())

# 5. re.sub()
substitute = re.sub(r'rain', 'snow', text)
print("Substitute result:", substitute)

# 6. re.split()
split = re.split(r'\s', text)
print("Split result:", split)


Объяснение примера:

> re.match(r'The', text): Проверяет, начинается ли строка text с "The".
> re.search(r'rain', text): Ищет первое вхождение "rain" в строке text.
> re.findall(r'in', text): Находит все вхождения "in" в строке text.
> re.finditer(r'in', text): Возвращает итератор, который перебирает все вхождения "in" в строке text.
> re.sub(r'rain', 'snow', text): Заменяет все вхождения "rain" на "snow" в строке text.
> re.split(r'\s', text): Разделяет строку text по пробелам (символы пробела).

Дополнительные примеры шаблонов:

\d: Любая цифра.
\D: Любой символ, кроме цифры.
\w: Любая буква, цифра или символ подчеркивания.
\W: Любой символ, кроме буквы, цифры или символа подчеркивания.
\s: Любой пробельный символ.
\S: Любой непробельный символ.
.: Любой символ, кроме новой строки.
^: Начало строки.
$: Конец строки.
*: 0 или более повторений.
+: 1 или более повторений.
?: 0 или 1 повторение.
{n}: Ровно n повторений.
{n,}: n или более повторений.
{n,m}: От n до m повторений.

Регулярные выражения мощный инструмент для работы с текстом, и они могут быть полезны в самых разных задачах, от простой проверки ввода до сложного парсинга текста. 💊

👉 @PythonPortal
  • ❤ 23
  • 👍 3
Post #5784 6.03K
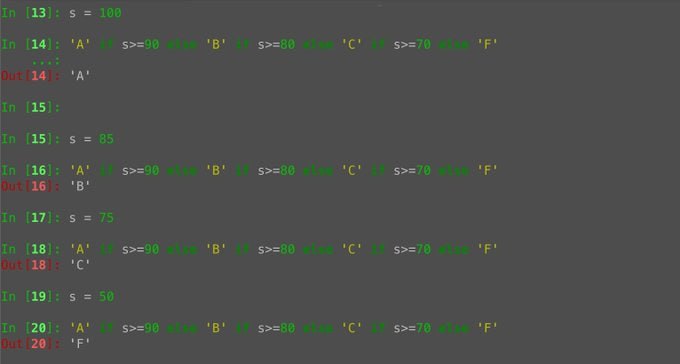
Тернарный оператор в Python — удобная штука, но им легко злоупотребить:
'A' if s>=90 else 'B' if s>=80 else 'C' if s>=70 else 'F'


То, что это можно написать, ещё не значит, что так стоит писать.
Если условий 3 и больше — лучше использовать if-elif-else.

А тернарный оператор стоит оставить для:
comprehensions (генераторов списков / коллекций), lambda-выражений, return в одну строку.

👉 @PythonPortal
  • 👍 11
  • ❤ 2
  • 👀 2
Post #5783 6.2K
Компании, которые увольняют программистов и направляют деньги на ИИ выглядят примерно так

👉 @PythonPortal
  • ❤ 65
  • 😁 26
  • 👍 14
Post #5781 5.73K
Пишешь объектно-ориентированный Python? Не путай два базовых типа отношений:

1/ has-a («композиция»). Один объект содержит другой. У Person есть (has-a) name. У Car есть (has-a) color.

2/ is-a («наследование»). Один класс является разновидностью уже существующего. Employee — это (is-a) Person. Car — это (is-a) Vehicle.

👉 @PythonPortal
  • 👍 12
  • ❤ 6
Post #5780 6.32K
Лёгковесный автономный AI-агент на Python с поддержкой нескольких моделей и множества инструментов, может заменить Claude Code и работает локально: https://github.com/KevRojo/Dulus

Автономный AI-агент, написанный на 12 000 строк Python-кода, с поддержкой 11 провайдеров моделей, между которыми можно переключаться по необходимости, и 27 встроенными инструментами. Поддерживает протокол MCP, горячую загрузку плагинов, параллельную работу саб-агентов, офлайн-голосовой ввод/вывод и интеграцию с Telegram (Telegram-bridge).

👉 @PythonPortal
  • 👍 15
  • ❤ 4
Post #5779 6.34K
7 обязательных сложностей алгоритмов (Big-O) для собеседований:

1. 𝐎(1) — 𝐤𝐨𝐧𝐬𝐭𝐚𝐧𝐭𝐧𝐚𝐲𝐚 𝐬𝐥𝐨𝐳𝐡𝐧𝐨𝐬𝐭𝐢

- Время выполнения не зависит от размера входных данных.
- Пример: доступ к элементу массива по индексу.

2. 𝐎(𝐥𝐨𝐠 𝐧) — 𝐥𝐨𝐠𝐚𝐫𝐢𝐟𝐦𝐢𝐜𝐡𝐞𝐬𝐤𝐚𝐲𝐚 𝐬𝐥𝐨𝐳𝐡𝐧𝐨𝐬𝐭𝐢

- Время растёт медленно при увеличении входа. Обычно встречается в алгоритмах, которые делят задачу пополам на каждом шаге.
- Пример: бинарный поиск в отсортированном массиве.

3. 𝐎(𝐧) — 𝐥𝐢𝐧𝐞𝐲𝐧𝐚𝐲𝐚 𝐬𝐥𝐨𝐳𝐡𝐧𝐨𝐬𝐭𝐢

- Время растёт линейно относительно размера входных данных.
- Пример: поиск элемента в массиве перебором.

4. 𝐎(𝐧 𝐥𝐨𝐠 𝐧) — 𝐥𝐢𝐧𝐞𝐲𝐧𝐨-𝐥𝐨𝐠𝐚𝐫𝐢𝐟𝐦𝐢𝐜𝐡𝐞𝐬𝐤𝐚𝐲𝐚 𝐬𝐥𝐨𝐳𝐡𝐧𝐨𝐬𝐭𝐢

- Время растёт чуть быстрее линейного. Обычно включает логарифмическое число операций на каждый элемент.
- Пример: сортировка quick sort или merge sort.

5. 𝐎(𝐧^2) — 𝐤𝐯𝐚𝐝𝐫𝐚𝐭𝐢𝐜𝐡𝐞𝐬𝐤𝐚𝐲𝐚 𝐬𝐥𝐨𝐳𝐡𝐧𝐨𝐬𝐭𝐢

- Время растёт пропорционально квадрату входа.
-Пример: bubble sort, где происходит сравнение и возможный swap каждой пары элементов.

6. 𝐎(2^𝐧) — 𝐞𝐤𝐬𝐩𝐨𝐧𝐞𝐧𝐭𝐬𝐢𝐚𝐥𝐧𝐚𝐲𝐚 𝐬𝐥𝐨𝐳𝐡𝐧𝐨𝐬𝐭𝐢

- Время удваивается с каждым новым элементом входа. Такие алгоритмы быстро становятся непригодными для больших данных.
- Пример: генерация всех подмножеств множества.

7. 𝐎(𝐧!) — 𝐟𝐚𝐤𝐭𝐨𝐫𝐢𝐚𝐥𝐧𝐚𝐲𝐚 𝐬𝐥𝐨𝐳𝐡𝐧𝐨𝐬𝐭𝐢

- Время пропорционально факториалу размера входа.
- Пример: генерация всех перестановок множества.

👉 @PythonPortal
  • 🤣 24
  • 👍 10
  • ❤ 5
  • 🏆 4
Post #5778 6.82K
Кто-то сделал бесплатный PDF-редактор, который делает всё то же, что и Adobe, но занимает всего 20 МБ.

RevPDF работает полностью локально на устройстве. Позволяет редактировать текст и изображения, подписывать документы, редактировать конфиденциальные данные, сжимать файлы, конвертировать в Word — без интернета, без аккаунта и без подписки.

Полностью бесплатно. Полностью офлайн.

👉 @PythonPortal
  • 🤔 22
  • ❤ 11
  • 👍 6
  • 😢 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →