
Kimi снова это сделали!
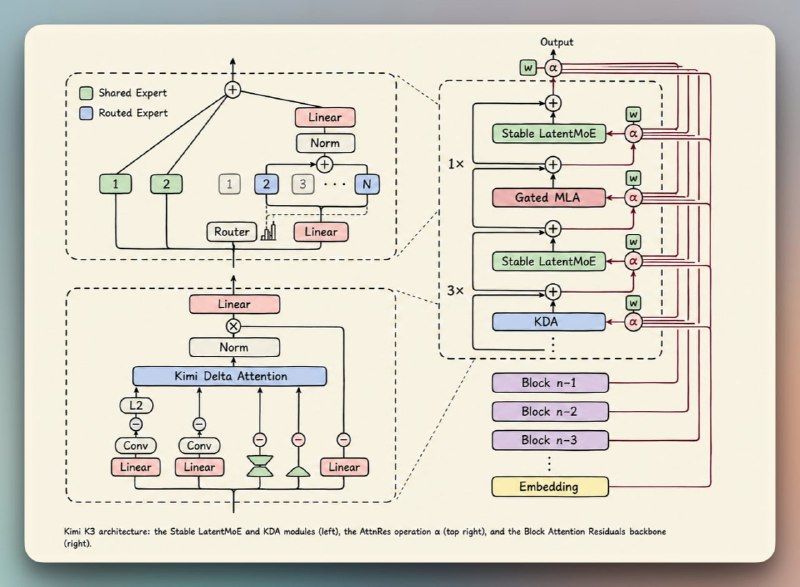
В Kimi K3 они разработали новый подход к работе с residual connections (остаточными связями) в Transformer-архитектурах — механизмом, который практически не менялся со времён ResNet в 2015 году.
В стандартном Transformer каждый слой добавляет свой выход обратно к входу с фиксированным весом 1.
То есть каждый слой получает одинаковую важность независимо от того, что именно нужно конкретному токену.
При глубине в 40, 60, 80+ слоёв скрытое состояние превращается в сумму всех предыдущих представлений с одинаковыми весами.
Более глубоким слоям приходится создавать всё более крупные выходные значения, чтобы хоть как-то влиять на итоговое представление. При масштабировании моделей это делает обучение менее стабильным.
Attention Residuals решают эту проблему, заменяя фиксированное сложение на softmax attention по глубине сети.
Теперь каждый слой сам учится определять, сколько информации брать из каждого предыдущего слоя — в зависимости от входа. Благодаря этому разные токены могут извлекать разные представления из разных слоёв, ориентируясь на то, что действительно полезно.
Идея повторяет то, что оригинальный Transformer сделал с последовательностями.
RNN сжимали всю предыдущую информацию о токенах в одно состояние, которое передавалось по времени. Transformer заменил это механизмом attention. Attention Residuals применяют ту же идею, но уже к глубине модели.
Когда Kimi впервые проверили этот подход на своей модели Kimi Linear 48B в марте, Block AttnRes показал такую же производительность, как базовая модель, обученная с в 1,25 раза большим количеством вычислений, при этом добавив менее 2% задержки на инференсе.
Kimi K3 стала первой моделью, где этот подход применяется в масштабе фронтирной модели: 2,8 трлн параметров, вместе с Kimi Delta Attention, который обеспечивает до 6,3× более быстрое декодирование при работе с контекстом размером в миллион токенов.
👉 @PythonPortal
Post #5999
4.93K
- 👍 16
- ❤ 5