🔥 Yoooo Tencent только что выпустила новую модель генерации видео с открытым исходным кодом, и она выглядит довольно интересно! Модель (img2videos) может генерировать видео лучше, чем Gen 3 и Luma, создавать анимированные говорящие аватары, генерировать динамические сцены.
⚡️ HunyuanVideo: модели генерации видео по тексту от Tencent.
Tencent опубликовала в отрытый доступ модели с 13 млрд. параметров для генерации видео по текстовым промптам:
HunyuanVideo и
HunyuanVideo-PromptRewrite. Архитектура HunyuanVideo простроена на пространственно-временном сжатии, которое позволяет обрабатывать видео и изображения в едином формате.
Входные текстовые запросы кодируются с помощью MLLM (комбинация CLIP and T5-XXL) и используются в качестве основы для генерации. Модель генерирует латент, который затем декодируется в изображения или видео с помощью 3D VAE.
HunyuanVideo-PromptRewrite - специальный файнтюн для адаптации и автоматического расширения пользовательских промптов к предпочтениям модели. В PromptRewrite 2 режима работы: Normal и Master:
🟢Режим Normal улучшает понимание моделью намерений пользователя, способствуя более точной интерпретации промпта.
🟢Режим Master улучшает описание композиции, освещения сцены генерации и движения камеры, что на выходе дает видео с более высоким визуальным качеством.
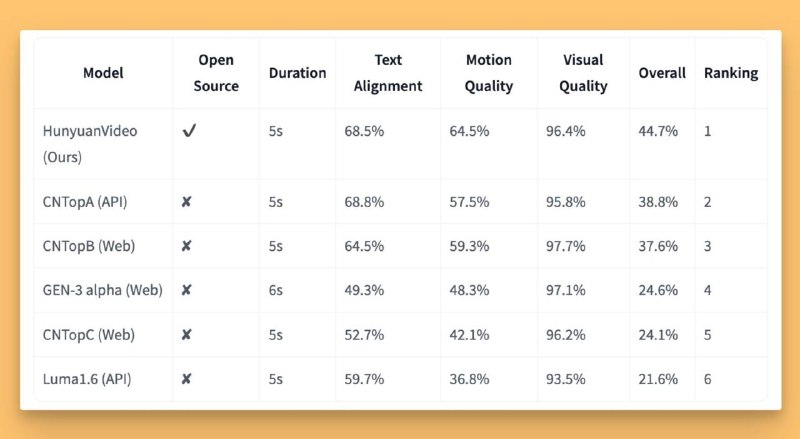
HunyuanVideo оценивалась 60 экспертами на 1533 промптах в сравнении с топовыми T2V-моделями: Gen-3, Luma 1.6 и тремя лучшими китайскими коммерческими моделями.
Результаты оценки показали, что HunyuanVideo достигает общего уровня удовлетворенности, особенно выделяясь качеством движения объектов.
▶️Планы развития HunyuanVideo:
🟠Бенчмарк Penguin Video;
🟠Web Demo (Gradio);
🟠Поддержка ComfyUI;
🟠Поддержка Diffusers;
🟠Модель и код инференса Image-to-Video версии.
⚠️ Минимальный объем GPU - 60 GB для 720pX1280pX129f и 45 GB для 544pX960pX129f. Рекомендованный
GPU - 80 GB.
▶️Установка и инференс T2V в 720р:
# Clone repo:
git clone https://github.com/tencent/HunyuanVideo
cd HunyuanVideo

# Prepare conda environment
conda env create -f environment.yml
conda activate HunyuanVideo

# Install pip dependencies
python -m pip install -r requirements.txt

# Install flash attention v2
python -m pip install git+https://github.com/Dao-AILab/flash-attention.git@v2.5.9.post1

# Inference
python3 sample_video.py \
    --video-size 720 \
    --video-length 129 \
    --infer-steps 50 \
    --prompt "%prompt%" \
    --flow-reverse \
    --use-cpu-offload \
    --save-path ./results
📌Лицензирование:
Tencent Hunyuan Community License.📽️
Project http://aivideo.hunyuan.tencent.com🧑💻
Github:
http://git.new/hyvideo📃
Paper:
http://thursdai.news/hypaper🏋️
Weights on HF:
http://thursdai.news/hyv-weights https://pic.x.com/qIib0wdkzy🤗
Hf:
https://huggingface.co/tencent/HunyuanVideo-PromptRewrite@pythonl