
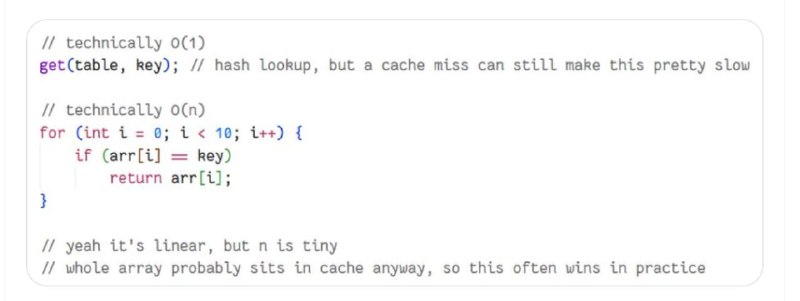
Одна из самых частых ошибок в алгоритмах: считать, что O(1) всегда быстрее O(n).
На практике это не так.
O(1) означает только одно: время работы не растёт вместе с размером входных данных.
Но сама операция может быть дорогой.
Например, хеш-таблица формально даёт O(1) для поиска, но если данные не в кэше CPU, один cache miss может сделать её медленнее, чем простой линейный проход по маленькому массиву.
Именно поэтому в Go, Python и даже C-библиотеках для маленьких map/таблиц иногда используют обычный linear search.
Парадоксально, но:
O(n) при n = 16 и тёплом кэше может быть быстрее, чем O(1) с холодным cache miss.Big O описывает асимптотический рост, а не реальную скорость на маленьких данных.