TGViewer
Channel Public Channel
Разъяснивший Python

Разъяснивший Python

@python_pssss

Твой проводник в омут Python'а

Ссылка: @Portal_v_IT

Сотрудничество: @oleginc, @tatiana_inc

Канал на бирже: https://telega.in/c/python_pssss
Subscribers
6.96K
Photos
3.3K
Videos
48
Links
3.3K

Showing posts older than #3258 · Back to latest

Older Posts 18 shown
Post #3257 518
numpy.where

Функция numpy.where используется для поиска элементов в массиве, которые соответствуют определённому условию. Она возвращает индексы этих элементов или позволяет заменять их на другие значения. Благодаря данной статье ты узнаешь, как пользоваться numpy.where.

👉Читать статью

Разъяснивший Python
  • 🔥 2
  • ❤ 1
  • 👎 1
Post #3256 540
any

any возвращает True, если хотя бы один элемент итерируемого объекта является истинным. Это полезно для быстрых проверок условий в коллекциях.

Разъяснивший Python
  • 👍 1
Post #3253 579
Полезные библиотеки Python

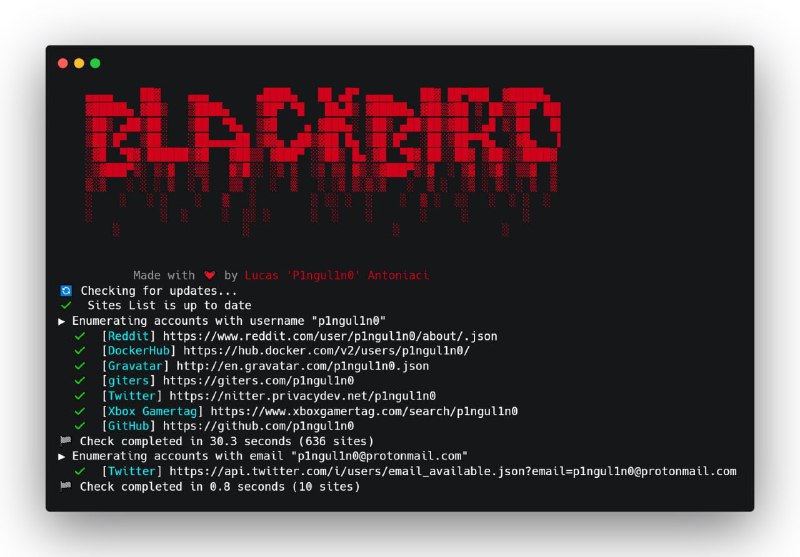
Blackbird — мощный инструмент OSINT для поиска аккаунтов по всему интернету.

Ищете эффективный способ обнаружить учетные записи пользователя по нику или email?
Blackbird — продвинутый инструмент для OSINT-исследований, позволяющий быстро находить профили на более чем 600 платформах.

GitHub/Инструкция

Разъяснивший Python
Post #3252 469
Как удобно отформатировать строку с переменными?

Новички часто используют конкатенацию (+) для вставки переменных в строки. Это может быть неудобно и плохо читаемо. Вместо этого лучше использовать f-строки — современный и лаконичный способ форматирования строк в Python!

F-строки (или форматированные строки) позволяют вставлять переменные прямо внутрь строки с помощью фигурных скобок {}. Это и быстрее, и чище!

Итог:
F-строки — самый читаемый и удобный способ форматирования.
Позволяют вставлять выражения прямо в строку.
Работают с любой версией Python 3.6+.

Разъяснивший Python
  • 👍 1
Post #3251 450
re.sub

re.sub заменяет все вхождения шаблона в строке на указанное значение. Это полезно для очистки и нормализации текста.

Разъяснивший Python
Post #3250 476
Ridge и Lasso

Иногда простая линейная регрессия начинает чудить: переобучается, даёт нестабильные коэффициенты, особенно если в данных много признаков или они между собой похожи. Это называется мультиколлинеарность, и лечится оно регуляризацией — техникой, которая добавляет “штраф” за слишком сложную модель. В линейной регрессии это реализуется через Ridge (L2-регуляризация) и Lasso (L1-регуляризация).

Ridge-регрессия добавляет к ошибке сумму квадратов коэффициентов. В результате модель получает штраф за то, что “раздувает” веса. Чем больше alpha, тем сильнее сжимаются веса. Маленькое значение — почти обычная линейная регрессия, большое — всё приближается к нулям.

Lasso-регрессия штрафует за модули коэффициентов. То есть она не просто сжимает веса, а может вообще сделать некоторые из них равными нулю. Это превращает Lasso в инструмент для отбора признаков: она как бы говорит «этот признак не важен — выкину его сам».

Разъяснивший Python
Post #3248 433
Как быстро проверить, является ли строка числом?

При обработке пользовательского ввода важно понимать, содержит ли строка число. Новички могут пытаться использовать try-except или проверять вручную, но есть более элегантное решение — метод .isdigit().

Метод .isdigit() возвращает True, если строка состоит только из цифр. Это удобно, когда нужно, например, убедиться, что пользователь ввёл возраст или ID.

Итог
.isdigit() — простой способ проверить, состоит ли строка только из цифр.
Полезен при валидации ввода.
Работает только для положительных целых чисел.

Разъяснивший Python
Post #3247 459
zip

zip объединяет несколько итерируемых объектов в кортежи по элементам. Это полезно для параллельной обработки нескольких списков.

Разъяснивший Python
Post #3246 476
enumerate

enumerate добавляет индексы к элементам итерируемого объекта. Это полезно для одновременного доступа к элементу и его позиции в цикле.

Разъяснивший Python
Post #3245 546
Как быстро получить уникальные значения из списка?

Когда нужно найти все уникальные элементы в списке, новички часто перебирают элементы вручную и добавляют их в новый список. Но Python предлагает простое и эффективное решение — использовать set.

Множество (set) автоматически удаляет все повторяющиеся значения. А если нужно сохранить порядок, можно дополнительно применить dict.fromkeys(). Всё это делается буквально в одну строку!

Итог:
set() — простой способ убрать дубликаты.
dict.fromkeys() сохраняет порядок элементов.
Отлично подходит для быстрой фильтрации!

Разъяснивший Python
  • ❤ 2
Post #3244 488
dict.setdefault

dict.setdefault возвращает значение по ключу, если он существует, или добавляет ключ со значением по умолчанию. Это полезно для группировки, счётчиков и инициализации вложенных структур.

Разъяснивший Python
Post #3243 521
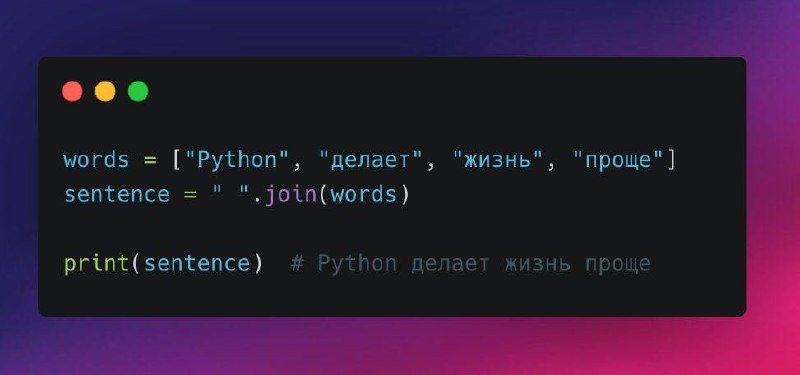
Как объединить строки без цикла?

Когда нужно склеить несколько строк из списка в одну, новички часто используют цикл for и оператор +. Но в Python есть более быстрый и лаконичный способ — метод .join().

Метод join() принимает список строк и объединяет их через указанный разделитель. Это работает гораздо эффективнее циклов и особенно полезно при работе с большими объёмами текста.

Итог:
.join() — лучший способ объединения строк.
Работает быстро и читаемо.
Подходит для любых итерируемых объектов со строками.

Разъяснивший Python
Post #3241 454
Pandas: Удаление дубликатов

pandas.dropduplicates() — метод в библиотеке pandas, который используется для удаления дубликатов строк из DataFrame. С помощью duplicated ты можешь проверить, имеются ли дубликаты.

Разъяснивший Python
Post #3240 517
SDV - библиотека, разработанная учеными MIT, использующая алгоритмы машинного обучения для генерации различного рода таблиц при помощи анализа реальных данных и создания на их основе синтетических данных в Python.

Либа позволяет создать единичные таблицы, соединенные мульти-таблицы и секвентальные таблицы.

Пример кода:
from sdv.datasets.demo import download_demo

real_data, metadata = download_demo(
modality='single_table',
dataset_name='fake_hotel_guests')


В результате генерирует такую таблицу.

Ставится командой pip install sdv
Документация и примеры кода на Github

Разъяснивший Python
Post #3234 542
Ускорение компиляции с помощью numba

Если определённая часть твоего кода всё ещё работает медленно, попробуй библиотеку numba, чтобы компилировать код. numba ускоряет выполнение в 10-20 раз, так как компилирует код в машинные инструкции.

Разъяснивший Python
  • 🤯 1
Post #3232 478
Как проверить, все ли элементы в списке одинаковые?

Иногда нужно убедиться, что все элементы в списке одинаковые. Новички могут использовать циклы, но Python предлагает элегантный способ — set и all().

Этот приём позволяет сделать проверку за одну строку:

len(set(list1)) == 1 — если в множестве только один элемент, значит, все элементы одинаковые.

all(x == list1[0] for x in list1) — проверяет, равны ли все элементы первому.

Итог:
Проверяет список за одну строку.
Подходит для любых типов данных.
Упрощает валидацию данных!

Разъяснивший Python
  • ❤ 2
Post #3231 459
str.removeprefix

str.removeprefix удаляет указанный префикс из строки, если он присутствует. Это полезно для очистки и нормализации данных без лишних условий и срезов.

Разъяснивший Python
Post #3229 532
Как найти самое частое значение в списке?

Иногда нужно определить, какой элемент встречается в списке чаще всего. Новички могут использовать циклы и счётчики, но Python предлагает удобный способ — collections.Counter.

Этот приём позволяет найти самый частый элемент за одну строку: Counter(list1).most_common(1)[0][0] возвращает элемент с максимальной частотой.

Итог:
Определяет самый частый элемент за одну строку.
Работает с числами, строками и любыми данными.
Удобно для анализа данных!

Разъяснивший Python
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →