TGViewer
Channel Public Channel
[PYTHON:TODAY]

[PYTHON:TODAY]

@python2day

Python скрипты, нейросети, боты, автоматизация. Всё бесплатно!

Приват: https://boosty.to/pythontoday
YouTube: https://clck.ru/3LfJhM
Канал админа: @akagodlike
Чат: @python2day_chat

Сотрудничество: @web_runner

Канал в РКН: https://clck.ru/3GBFVm
Subscribers
63.7K
Photos
2.4K
Videos
1.2K
Links
1.5K

Showing posts older than #7064 · Back to latest

Older Posts 12 shown
Post #7063 14.4K
😎 Нейросеть сама создает контент и монтирует видео!

В Genspark появилась новая фича — Clip Genius.

ИИ-агент берёт любое длинное видео и превращает его в готовый контент для соцсетей.

Что умеет:
➡️ Делать Shorts из многочасовых роликов.
➡️ Анализирует и вырезает самые смешные и интересные моменты из интервью.
➡️ Собрать хайлайты подкастов и стримов.
➡️ Достать все голы из футбольного матча.
➡️ Автоматически добавить субтитры.
➡️ Сразу собрать готовый видос.

😘 И всё это работает абсолютно бесплатно.

Буквально редактор, который работает за тебя. Монтажёры прикурили в сторонке 🚬

Сохраняем и пробуем ТУТ 👍

#nn #soft
  • 👍 38
  • 🔥 13
  • ❤ 8
Post #7062 13.6K
😰 Python-шпаргалка по работе с датой и временем!

Модуль datetime — твой лучший друг, если нужно работать с датами, временем или таймзонами.

🔥 Форматы путают все. Держи удобный список, который точно пригодится:

📅 Форматирование дат и времени:

* %a → короткий день недели (Mon)
* %A → полный день недели (Monday)
* %b → короткий месяц (Jan)
* %B → полный месяц (January)
* %d → день месяца (01–31)
* %m → месяц (01–12)
* %y → год без века (23)
* %Y → год с веком (2023)
* %j → день в году (001–366)

⏰ Форматирование времени:

* %H → час (24ч, 00–23)
* %I → час (12ч, 01–12)
* %M → минуты (00–59)
* %S → секунды (00–61, да, 61! 😅)
* %f → микросекунды (000000–999999)
* %p → AM/PM
* %z → UTC-смещение (+0300)
* %Z → таймзона (если есть)

* %U → номер недели (с воскресенья)
* %W → номер недели (с понедельника)
* %x → локальная дата
* %X → локальное время
* %% → просто знак %

Примеры:

from datetime import datetime

now = datetime.now()
print(now)
# 2025-09-03 13:41:30.123456


Примеры форматирования даты:

print(now.strftime("%A, %d %B %Y"))
# Wednesday, 03 September 2025

print(now.strftime("%a, %d.%m.%y"))
# Wed, 03.09.25

print(now.strftime("День года: %j"))
# День года: 246


Примеры форматирования времени:

print(now.strftime("%H:%M:%S"))
# 12:45:30

print(now.strftime("%I:%M %p"))
# 12:45 PM

print(now.strftime("Микросекунды: %f"))
# Микросекунды: 123456


👍 Сохрани, чтобы не гуглить каждый раз!

#python #doc #cheatsheet
  • 👍 74
  • ❤ 10
  • 🔥 7
Post #7060 14.2K
😂 Кибер гоп-стоп

Ты: Решил приехать в Китай по безвизу.
Местные роботы: 👊

С добрым утром! ☕️

#cyberpunk
  • 👍 72
  • 🔥 24
  • 🤯 19
  • ❤ 9
  • 😱 8
  • 🫡 1
Post #7059 15.8K
🔥 GitByBit — крутой игровой тренажер, который поможет освоить Git.

Понятный и простой курс из 48 уроков, которые проходишь прямо в VS Code: учишься, решаешь задания и тут же закрепляешь навыки.

А ещё внутри есть Gitopedia — личная база знаний, куда складываются все важные фишки по мере прохождения.

⚡️ Сохраняем и пробуем бесплатно ТУТ!

#git #cheatsheet #soft
  • 🔥 71
  • 👍 22
  • ❤ 12
Post #7056 14.9K
🔥 Имба для Python-разработчиков!

PDF-EXTRACT-API — крутой Python инструмент для конвертации любого изображения или PDF документа в текст Markdown или структурированный документ JSON с очень высокой точностью, включая табличные данные, числа или математические формулы.

Под капотом:
🟢FastAPI для скорости;
🟢Celery для асинхронных задач;
🟢Redis для кэша и молниеносного OCR.

⚙️ GitHub/Инструкция

#python #soft #github
  • 👍 61
  • 🔥 18
  • ❤ 12
Post #7054 13.7K
😃 700к в месяц на кисках

Держите идею для стартапа. Парень из Филиппин зарабатывает $9000 в месяц (≈720 тыс.₽), снимая рандомные видео с ИИ-сгенерированными котами.

⏱️ Чувак «работает» всего по 2 часа в день, а сюжеты придумывает ChatGPT .

Профит:
💬 уже 600 тыс. подписчиков,
💬 больше 500 миллионов просмотров,
💬 куча денег ежемесячно просто за мемы с пушистыми героями.

🤨 В удивительное время живем...

С добрым утром! ☕️
  • 👍 81
  • 🔥 22
  • ❤ 10
  • 🤯 9
  • 😱 5
Post #7046 14.9K
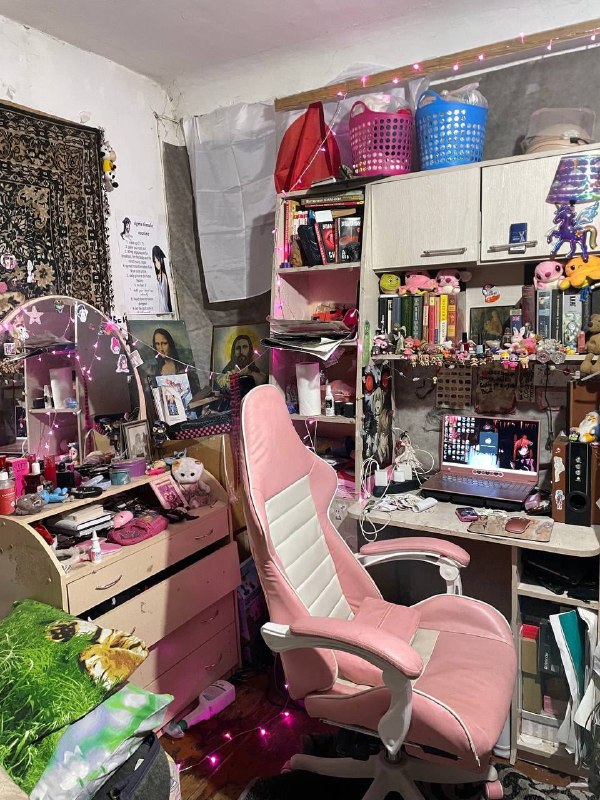
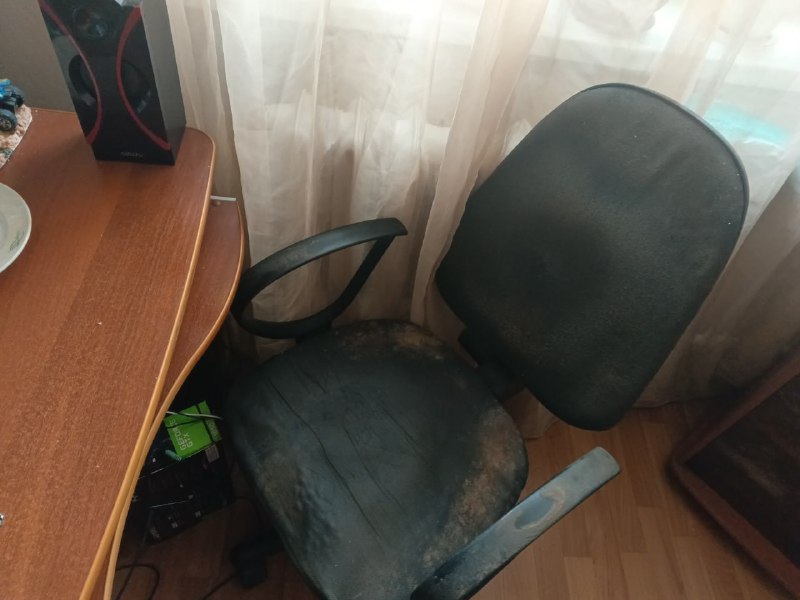
🤨 Думаешь у тебя грязно?

В сети зумеры «похвастались» своими сетапами 😕
  • 🤯 108
  • 😱 37
  • 🫡 13
  • ❤ 8
  • 🔥 6
  • 👍 1
Post #7042 13.4K
💀 Он просто не очень любит фоткаться... Смотреть со звуком 😂

С добрым утром! ☕️
  • 👍 49
  • 🔥 24
  • ❤ 11
Post #7041 13.6K
😄 Не ждут, а готовятся...

Сотрудники ИИ-компаний в США и Европе сходят с ума от страха, будто завтра наступит «судный день». Одни копают бункеры с биозащитой, чтобы спрятаться от «восстания машин», другие — уходят в полный отрыв: вечеринки, наркотики, оргии, деньги на ветер.

⚡️ Бывший исследователь OpenAI признался, что перестал копить на пенсию — уверен, человечеству наступит конец уже к 2035 году.

🤑 Одни тратят всё, что зарабатывают («в будущем деньги не понадобятся»), другие, наоборот, выжимают максимум сейчас, понимая, что скоро ИИ отберёт их работу.

Даже подход к отношениям меняется: вместо «умных партнёров» советуют выбирать красивых и харизматичных — живи здесь и сейчас!

Грядет техноапокалипсис... 😁
  • 👍 45
  • 🤯 32
  • 🫡 8
  • 🔥 6
  • ❤ 2
  • 😱 1
Post #7040 13.8K
🔥 Kreuzberg — умный фреймворк для работы с документами на Python.

Надоело вручную вытаскивать текст и данные из PDF, Word или сканов? Теперь это можно делать в один вызов API.

Что умеет:
📄 Извлечение текста с сохранением структуры и форматирования.
🧾 Метаданные: автор, язык, дата создания, ключевые слова.
🌍 Поддержка 18 форматов (PDF, Office, HTML, изображения и др.).
👁 OCR (Tesseract, EasyOCR, PaddleOCR) — распознавание текста со сканов и фото.
📊 Извлечение таблиц с точностью до ячейки.
🤖 Автоматическая классификация документов (контракты, счета, отчёты и т.п.).

Технические фишки:

💬 Производительность — до 30+ документов/сек;
💬 Малый вес (71MB) и низкое потребление памяти;
💬 Плагинная архитектура — можно писать свои экстеншены;
💬 Полная поддержка синхронного и асинхронного API.

👨‍💻 Примеры использования:

CLI:

# Извлечь текст
uvx kreuzberg extract document.pdf > output.txt

# OCR + таблицы
uvx --from "kreuzberg[all]" kreuzberg extract invoice.pdf --ocr-backend tesseract --output-format text


Python (async):

from kreuzberg import extract_file

result = await extract_file("presentation.pptx")
print(result.content)
print(result.metadata.title, result.metadata.author)


Подходит для:
🟢автоматизации документооборота;
🟢систем анализа контрактов и счетов;
🟢интеграции в web-приложения.

♎️ GitHub/Инструкция

#python #soft #code #github
  • 👍 48
  • 🔥 30
  • ❤ 13
Post #7039 13.2K
😎 Ну, спасибо...

💀
  • 🔥 146
  • 👍 25
  • 🤯 14
  • 😱 13
  • 🫡 9
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →