
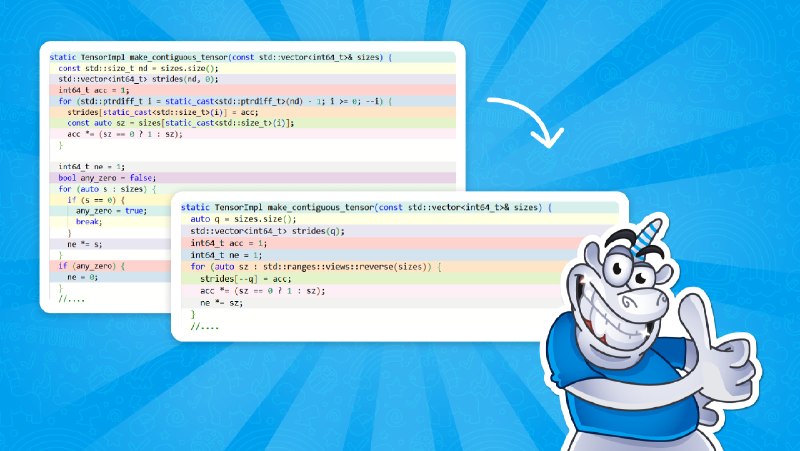
Взглянем целиком на вариант кода, который получился к текущему моменту.
static TensorImpl make_contiguous_tensor(const std::vector<int64_t>& sizes) {
  const std::size_t nd = sizes.size();
  std::vector<int64_t> strides(nd, 0);
  int64_t acc = 1;
  size_t i = nd;
  for (auto sz : std::ranges::views::reverse(sizes)) {
    strides[--i] = acc;
    acc *= (sz == 0 ? 1 : sz);
  }
   int64_t ne = 1;

  for (auto s : sizes) {
    ne *= s;
    if (ns == 0) {
      break;
    }
  }
  ....
}
Теперь, когда кода меньше, становится очевидным, что второй цикл избыточен. В первом цикле мы перебираем все элементы. Так почему бы их сразу не перемножить?
static TensorImpl make_contiguous_tensor(const std::vector<int64_t>& sizes) {
  const std::size_t nd = sizes.size();
  std::vector<int64_t> strides(nd, 0);
  int64_t acc = 1;
  size_t i = nd;
  int64_t ne = 1;
  for (auto sz : std::ranges::views::reverse(sizes)) {
    strides[--i] = acc;
    acc *= (sz == 0 ? 1 : sz);
    ne *= sz;
  }
  ....
}
Красота. Мы перемножаем все элементы, несмотря на то, что один из них может оказаться нулевым? Нестрашно. Микропроцессоры сейчас быстро умножают. Можно потерять больше на повторном доступе ко всем элементам во втором цикле.
Что ещё осталось? Не требуется изначально обнулять контейнер
strides нулями. Всё равно все его элементы будут перезаписаны.std::vector<int64_t> strides(nd, 0); // надо убрать второй аргумент
В принципе, мы закончили. Но можно сделать ещё одно косметическое изменение, избавившись от переменной
nd. Она ни здесь, ни в последующем коде не нужна. Итоговый код:static TensorImpl make_contiguous_tensor(const std::vector<int64_t>& sizes) {
auto q = sizes.size();
std::vector<int64_t> strides(q);
int64_t acc = 1;
int64_t ne = 1;
for (auto sz : std::ranges::views::reverse(sizes)) {
strides[--q] = acc;
acc *= (sz == 0 ? 1 : sz);
ne *= sz;
}
....
}Код сократился в два раза: с 20 до 9 строк!
P.S. Если захотите и напишите комментарий, я приведу ассемблерный код, чтобы показать как он сократился и оптимизировался.