
Подножка для AI в виде UTF-8. Часть 1 из 3: предисловие
Публикую своё наблюдение в преддверии подкаста Ever Secure на тему "Любимые грабли программистов, и станет ли вайб-кодинг спасением или новым проклятием". Решил разместить здесь пример, который я, скорее всего, упомяну в подкасте. На слух может быть сложно понять суть бага, поэтому код для наглядности не помешает.
Я немного экспериментировал с генерацией кода с помощью GigaChat и DeepSeek. Это не рабочие задачи и не полноценное исследование. Мне просто было интересно найти примеры пересечения некой грани сложности при решении задачи, после которой начинаются проблемы с генерацией C++ кода.
Если просить сгенерировать код уровня лабораторных и даже, наверное, некоторых курсовых работ, то проблем нет. Великолепно получается код сортировки массива или код подсчёта количества единичных бит в массиве байт. Причём для подсчёта единичных бит предлагаются такие интересные оптимизированные по скорости решения, про которые я даже не знал, хотя и читал давно в книге про различные подходы к этой задаче.
Кстати, здесь вырисовывается потенциальная проблема при обучении программированию: слишком велик соблазн сразу получить ответ, так и не разобравшись, как всё работает. Видимо, придётся обратно возвращаться к написанию кода на бумаге :) Но сейчас не будем углубляться в эту тему.
Для одного из экспериментов я выбрал создание программы, которая будет читать файлы с исходным кодом и выполнять ряд операций над названиями переменных или их составными частями. Одна из задач — это получить из имени переменной RedColor три токена: RedColor, Red и Color.
Думаю, задача разбития на токены часто встречается в программировании, и существует много открытого кода на эту тему. Поэтому в такой постановке GigaChat и DeepSeek с этой задачей справляются хорошо.
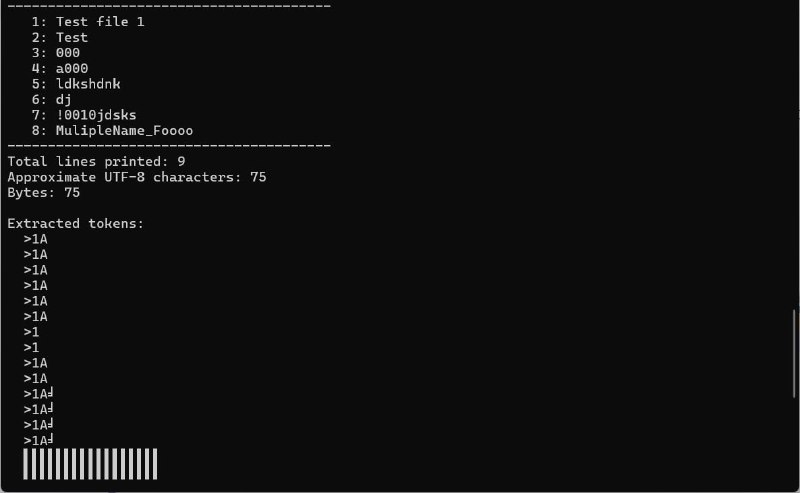
Однако мир сложнее, и нужно работать не просто со стандартной ANSI кодировкой, но и, например, с UTF-8. Поэтому я начал просить писать код, обрабатывающий файлы в том числе в формате UTF-8. И в этот момент генераторы кода поплыли.
Полагаю, количество открытого кода, учитывающего кодировки, в том числе и UTF-8, в несколько раз меньше. Дополнительно мои формулировки задания стали сложнее и от этого расплывчатее. Кстати, за пару подходов у меня не получилось добиться работающего кода. Думаю, это можно сделать, проведя ещё несколько генераций с уточнениями задания. Но у меня нет цели написать конечную программу и мне интересно экспериментировать именно со сбоями :)
Post #426
483
- 🔥 4