
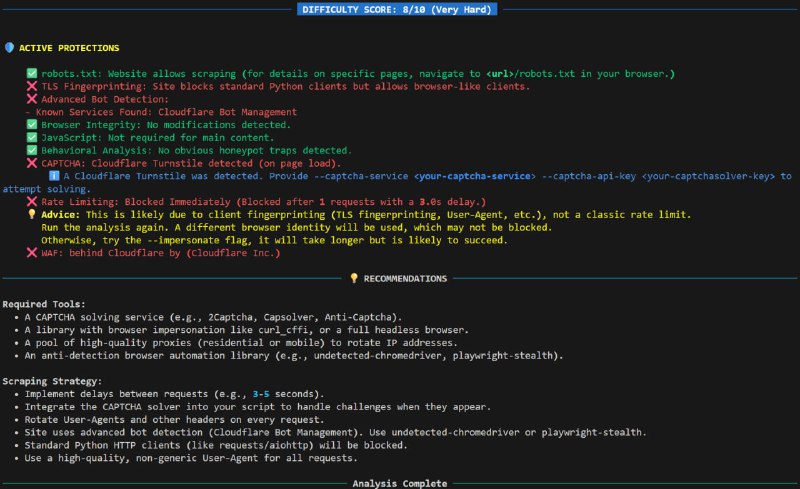
Код открыт в репозитории на GitHub. Установка через
pip install caniscrape, плюс установите зависимости: sudo apt install pipx # если нет pipx
pipx install wafw00f
playwright install chromium
Затем запускаете
caniscrape scan https://example.com
Внутри caniscrape делает как обычные HTTP‑запросы, так и запросы через браузер на базе Playwright, а для определения веб‑фаерволов использует wafw00f. По ответам он понимает, на каком уровне стоит защита (WAF, JS‑челлендж, капча, лимит и т.д.) и подсказывает, что вам потребуется: сессии, прокси, браузер, внешнее scraping‑API или, может, вообще не связываться.
Нужно учитывать, что на тяжёлых сайтах защита ведёт себя динамически, поэтому результаты могут отличаться между запусками. Логичный сценарий применения — включить caniscrape в пайплайн перед основным парсером, чтобы заранее понять, во что вы вписываетесь, и не тратить часы на скрипт, который будет сразу получать блок.
@prog_tools