Как запускать асинхронное GRPO без общей машины
Обстоятельный разбор рабочей системы: тренер с LoRA и серверы генерации работают в отдельных Hugging Face Jobs, без общей машины и межузлового обмена через NCCL.
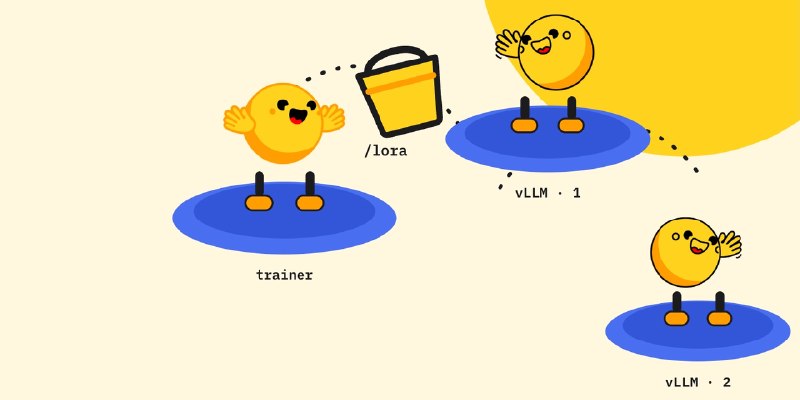
Тренер кладёт адаптер в объектное хранилище, которое каждый Job видит как файловую систему. Прокси добавляет авторизацию, выбирает реплику, где уже вычислено начало запроса, и сообщает всем репликам о новой версии.
Адаптер ранга 1 для модели на 1,5 млрд параметров занимает несколько мегабайт против примерно 3 ГБ у полной модели. При max_staleness=4 нужны шесть слотов LoRA, иначе vLLM может вытеснить версию с незавершёнными запросами.
Схема и пять последовательных прогонов показывают, где искать узкое место: 500 шагов удалось сократить с 3 часов 27 минут до 53 минут. Читать ML-инженерам, которые разносят обучение и генерацию по отдельным машинам.
Post #3043
167