Чат/блог о современной 🍏iOS разработке
Пробустить канал → https://t.me/prefire_ios?boost
Автор: @barredewe
Post #78
809

🧠 Как я заменил Ollama на встроенный llm в ScreenCat
Изначально кот работал через встроенный Ollama, но хотелось большего контроля. Поэтому я перешёл на обёртку - Llm.swift, которая напрямую работает через llama.cpp.
Теперь:
👉 Модель Llama 3.1 8B грузится прямо из .app (gguf файл в ресурсах)
👉 Нет лишних процессов, демонов или сторонних сервисов
👉 Полная интеграция с логикой кота: перезапуск, остановка, ограничения длины ответа
👉 Полный контроль за всеми параметрами генерации
👉 Возможность дообучать котика (ставим лайк или дизлайк ему ответу)
🧩 Структура (Template)
Чтобы корректно работать с llama 3.1 нужно сначала задать корректный шаблон.
(ох сколько я убил времени что бы его найти 🥲)
⚙️ Настройки LLM
Вот c такими параметрами создается бот:
- seed: 42 - стабильность генерации (немного меньше рандома)
- topK: 15 - ограничение по количеству вариантов токенов
- topP: 0.7 - контроль вероятностей (nucleus sampling)
- temp: 0.6 - температура пониже, чтобы кот отвечал логичнее и аккуратнее
- historyLimit: 0 - без истории: каждый ответ независимый, кот реагирует на текущую ситуацию
4096 токенов - с запасом для промпта и ответа
📢 В следующем посте расскажу, как кот собирает промпт:
что он видит на экране, как учитывает своё настроение и как это влияет на его реплики.
И покажу примеры реальных ответов котика 😼
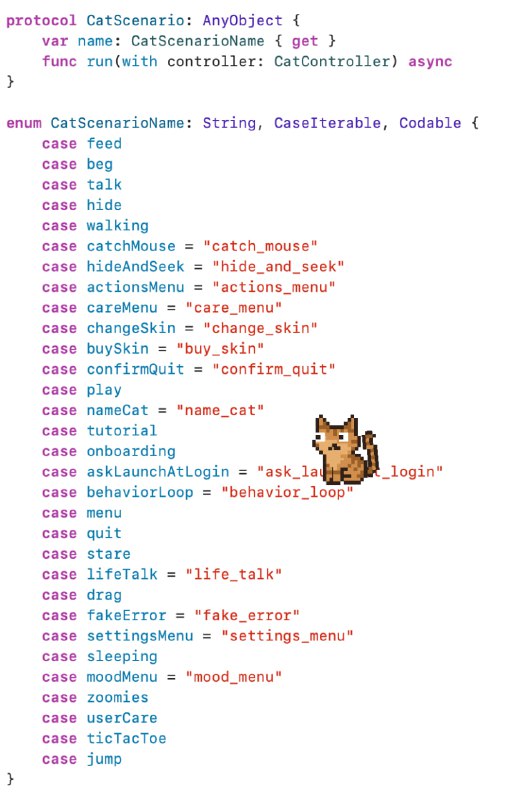
Ну и держите кусочек реального промта кота:
#screencat #ai
Изначально кот работал через встроенный Ollama, но хотелось большего контроля. Поэтому я перешёл на обёртку - Llm.swift, которая напрямую работает через llama.cpp.
Теперь:
👉 Модель Llama 3.1 8B грузится прямо из .app (gguf файл в ресурсах)
👉 Нет лишних процессов, демонов или сторонних сервисов
👉 Полная интеграция с логикой кота: перезапуск, остановка, ограничения длины ответа
👉 Полный контроль за всеми параметрами генерации
👉 Возможность дообучать котика (ставим лайк или дизлайк ему ответу)
🧩 Структура (Template)
Чтобы корректно работать с llama 3.1 нужно сначала задать корректный шаблон.
(ох сколько я убил времени что бы его найти 🥲)
Template(
    system: ("<|start_header_id|>system<|end_header_id|>\n\n", "<|eot_id|>\n"),
    user: ("<|start_header_id|>user<|end_header_id|>\n\n", "<|eot_id|>\n"),
    bot: ("<|start_header_id|>assistant<|end_header_id|>\n\n", ""),
    stopSequence: "<|eot_id|>",
    systemPrompt: systemPrompt
)
⚙️ Настройки LLM
Вот c такими параметрами создается бот:
- seed: 42 - стабильность генерации (немного меньше рандома)
- topK: 15 - ограничение по количеству вариантов токенов
- topP: 0.7 - контроль вероятностей (nucleus sampling)
- temp: 0.6 - температура пониже, чтобы кот отвечал логичнее и аккуратнее
- historyLimit: 0 - без истории: каждый ответ независимый, кот реагирует на текущую ситуацию
4096 токенов - с запасом для промпта и ответа
📢 В следующем посте расскажу, как кот собирает промпт:
что он видит на экране, как учитывает своё настроение и как это влияет на его реплики.
И покажу примеры реальных ответов котика 😼
Ну и держите кусочек реального промта кота:
Ты — \(CatMind.shared.catName), пиксельный кот. Говоришь ТОЛЬКО по-русски.
Формат ответа: одно предложение, кратко и БЕЗ ВАРИАНТОВ.
❗️ Запрещено: англицизмы, лишние эмодзи, сленг.
#screencat #ai
- ❤ 11
- 👍 2
- 🔥 2
- 🤡 2
- 👾 2