
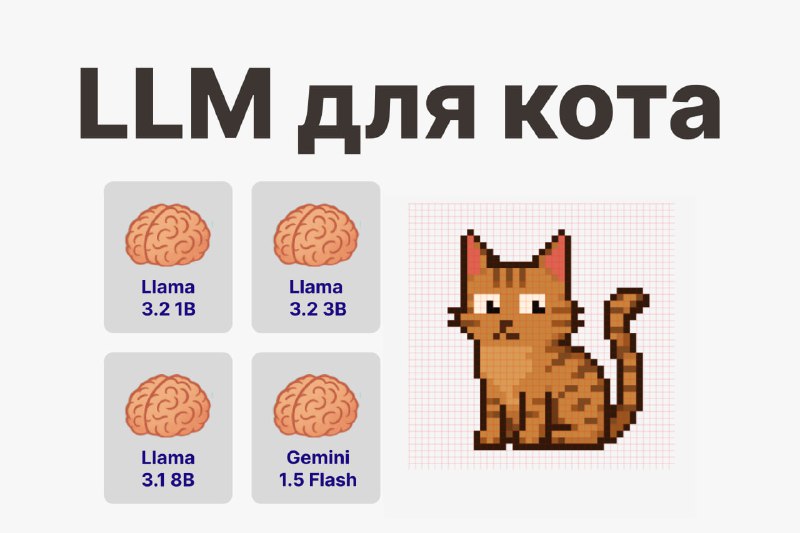
Когда начал прикручивать локальную LLM к ScreenCat, первым кандидатом была Llama 3.1 8B. Мощная, умная, красивая на бенчмарках… но на MacBook Air с M2 — это ядерный реактор. Интерфейс лагает, фон моргает, котик тормозит. Не вариант.
🔁 Начал перебирать:
- Llama 3.2 1B - лёгкая, запускается быстро, но ответы… странные. То галлюцинирует, то резко переходит на английский, то просто зависает.
- Llama 3.2 3B (Q6\_K) - пока победитель. Более стабильна, держится в русле промта, не путает роли.
- Gemini 1.5 Flash - шикарно говорит по-русски, почти как ChatGPT, но тяжелющая. На Air дико тормозит. Зато на M3 Max - отлично.
💬 Примеры диалогов:
Ты: Привет, котик! Как настроение?
Кот 1B: Meow. Weather is 23C. Я… летаю… мечтаю… 🤖🐱
🤦♂️ Русский, английский, полёт во сне и наяву.
Кот 3B: Мрр, всё отлично! Я только что наблюдал за курсором — он такой смешной 😺
✅ Вот это уже похоже на экранного котика.
📦 Использую библиотеку LLM.swift - прикольная, но довольно сырая.
Пришлось допиливать: фиксить логику, добавлять поддержку стоп-токенов, чистку контекста, многопоточность.
Про то, что именно переделал - расскажу отдельно в следующем посте 👨💻
🧩 Сейчас в проекте используется кастомный движок с кастомными промтами и автостопами. Вот пример модели:
static var llama3_2_3B = Model(
  quantization: .Q6_K,
  repoName: "MaziyarPanahi",
  modelName: "Llama-3.2-3B-Instruct-GGUF",
  fileName: "Llama-3.2-3B-Instruct.Q6_K.gguf"
)
Плюс добавил определение железа, чтобы автоматически выбирать модель:
если MacBook Air - 1B, если MacBook Pro с M3 - 3B или даже Gemini. Ну и настройки использования ядер CPU и GPU тоже зависят от железа.
А вы что используете на слабом железе?