
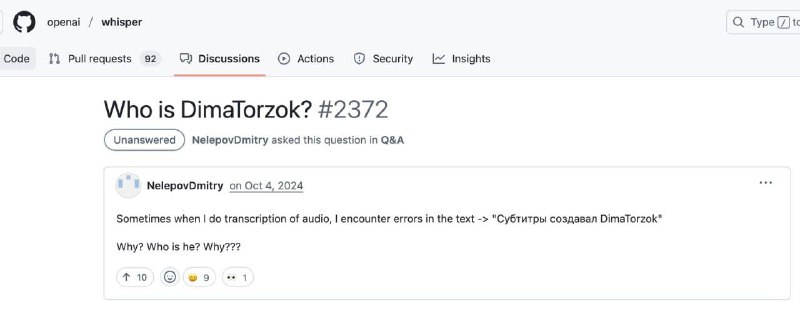
(или как OpenAI не фильтрует данные обучения)
Делаю пет-проект с распознаванием речи на видео через whisper.cpp. Всё шло нормально… пока вместо музыки модель не стала писать:
👉 «Субтитры добавил DimaTorzok»
Я же распознаю голос, а не ищу какого-то Диму 😅
Оказалось, что в обучающих данных с YouTube полно видео, где при музыке так и было написано в субтитрах. Whisper это честно выучил и теперь считает: музыка = DimaTorzok.
⚡️ Фикс элементарный: заменяем эту фразу на music прямо в коде.
Два дня бился, но теперь знаю:
🎶 любая музыка для OpenAI - это DimaTorzok.
PS: Работет только по распознавании русского языка
📎 Обсуждение на GitHub: Who is DimaTorzok?