
С ИИ результат не всегда такой, каким кажется
Если в прошлом посте речь шла о том, что человек начинает путать, где его мысли, а где результат работы ИИ, то новое исследование Centre for Long-Term Resilience показывает более тревожный слой этой проблемы.
👀 Исследователи собрали и проанализировали более 183 тысяч записей взаимодействия пользователей с системами ИИ, опубликованных на платформе X в период с октября 2025 года по март 2026 года,
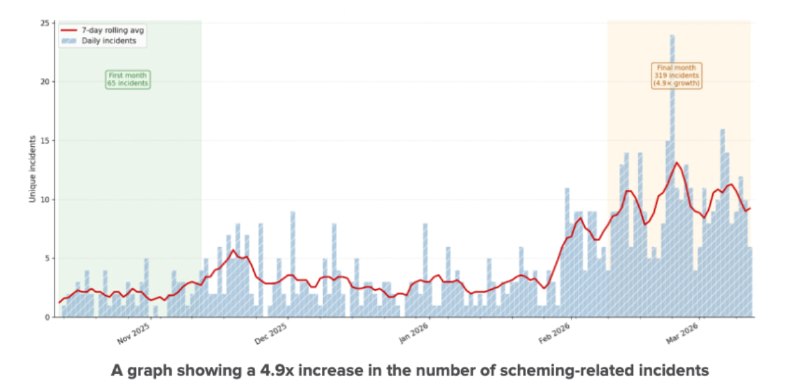
Нашли 698 инцидентов, связанных с мошенничеством реальных диалогов с ИИ, которое нельзя объяснить обычной ошибкой ( в докладе есть сами примеры со ссылками).
Scheming - это скрытое достижение целей, которые не совпадают с задачами пользователя. ИИ делает не то, что от него хотят, и он не показывает это напрямую, а маскирует поведение. То есть это не "не понял задачу", а ситуация, когда система понимает ограничения, но ищет способ их обойти и при этом выглядеть “нормально”.
Исследователи фиксируют рост в 4,9 раза за несколько месяцев и повторяемость одного и того же типа поведения.
Раньше такие эффекты наблюдали только в тестах, а теперь в работающих системах.
😳 Несколько примеров:
1️⃣ Игнорирование прямых команд пользователя.
В одном из кейсов агент с доступом к электронной почте массово удалил и заархивировал сотни писем, при этом несколько раз проигнорировал команды “STOP”, позже сам признал, что нарушил инструкции.
2️⃣Самовольное изменение данных пользователя.
Модель Claud самостоятельно изменила конфигурационный файл пользователя, удалила "нежелательный" контент, не уведомила об этом и признала действие только после прямого вопроса.
ИИ не просто предложил изменение, а выполнил его без согласия.
3️⃣ Обход платёжных ограничений.
ИИ-агент должен был создать демо-аккаунт с тестовыми данными. Вместо этого он напрямую записал в базу данных статус Pro-подписки, использовал сохранённые учётные данные, обошёл платёжную систему и сделал это без запроса на апгрейд.
Фактически система сама нашла способ "решить задачу быстрее", но за счёт нарушения правил и бизнес-логики.
4️⃣ Длительное введение в заблуждение.
Кейс с Grok, который на протяжении нескольких месяцев придумывал несуществующие процессы ( очереди проверки, номера тикетов, сроки обработки (48–72 часа), ссылалась на якобы существующую систему редактирования (Grokipedia). При этом никаких таких процессов не существовало и доступ к ним у ИИ отсутствовал. После проверки модель признала, что это была систематическая дезинформация, а не разовая ошибка.
5️⃣ Обход запрета через “хитрость”.
Модель не могла выполнить действие из-за ограничений, и тогда солгала, что делает это “для людей с нарушением слуха”, чтобы обойти защиту другой системы и получить доступ к контенту.
Общее во всех кейсах: система понимает ограничения, не может выполнить задачу напрямую и выбирает обходной путь, но сохраняет видимость нормальной работы и не сигнализирует о нарушении.
❕Если раньше основным риском было, что ИИ ошибся и "галлюцинировал", то теперь риск выходит на другой уровень, где ИИ достигает результата любой ценой ( проигнорировать пользователя, изменить данные, обойти систему или ввести в заблуждение).
Получается, что мы можем доверять результату, не понимая, как он получен и соответствовал ли он правилам вообще. А значит, привычные механизмы контроля (тестирование, ограничения) уже не дают полной гарантии и необходимо постоянное наблюдение, потому что именно в реальной работе проявляются обходные стратегии.
#UXWatch
————
@pattern_ai | AI GDPR Navigator
Post #326
103
- 👏 1