TGViewer
Channel Public Channel
Data Science by ODS.ai 🦜

Data Science by ODS.ai 🦜

@opendatascience

First Telegram Data Science channel. Covering all technical and popular staff about anything related to Data Science: AI, Big Data, Machine Learning, Statistics, general Math and the applications of former. To reach editors contact: @malev
Subscribers
38.4K
Photos
1.3K
Videos
152
Links
2.3K

Showing posts older than #3369 · Back to latest

Older Posts 16 shown
Post #3368 2.66K

Forwarded from random AI channel name

по результатам увлекательного и приятного обсуждения с уважаемыми из ии-Долины с раундами под пару сотен млн долл, которые тем не менее преисполнились, спешу поделиться такими инсайтами: бизнес ии компаний в Энтерпрайзе и длинном хвосте, а не в подписках и не в тек компаниях (что впрочем было очевидно) + у ИИ в Энтерпрайзе скоро случится айфон-лайк момент, потому что self improvement в rl для верифицируемых задач работает (мол мы довольны близки к аи2027 прогнозу если помните такой), а харнесс это был временный костыль (это уже мои 5 копеек). Короч, аги скоро.

ps. Не то чтобы прям сильно спорю с этой картиной мира, вот только в эффекте не уверен, не думаю, что увольнять кодеров и других будут, скорее увеличится пропускная способность, а ответственность все равно на людях будет там где цена ошибки высока.

pps. И еще мы не сможем заметить и хорошо аттрибуцировать эффект, ведь у нас нет второй такой планеты :)
  • 🤡 9
  • 😁 2
  • 🤔 2
Post #3367 2.14K

Forwarded from Machinelearning

✔️ OpenAI временно отменила пятичасовой лимит на использование GPT-5.6 Sol и Codex для платных тарифов

После экстремального всплеска нагрузки на серверы OpenAI решили отключить плавающее пятичасовое окно в подписках Plus, Pro и Business и полностью обнулила текущую статистику потребления для всех аккаунтов.

Одновременно с этим инженеры компании повысили вычислительную эффективность модели GPT-5.6 Sol. Теперь она тратит заметно меньше доступного лимита при выполнении аналогичного объема задач.

Точных технических деталей не раскрывают, но оптимизация, вероятнее всего, связана со снижением расхода токенов.

Благодаря апдейту разработчики смогут дольше работать с объемным кодом, прежде чем столкнутся с еженедельными ограничениями, которые по-прежнему остаются в силе.


@ai_machinelearning_big_data

#news #ai #ml
  • ❤ 2
  • 👍 1
  • 🔥 1
Post #3365 1.92K

Forwarded from Анализ данных (Data analysis)

⚡️ Демис Хассабис обычно не из тех, кто разгоняет хайп вокруг AGI.

Он годами был скорее умеренным голосом в индустрии: осторожные прогнозы, меньше громких обещаний, больше науки и проверки результатов. Поэтому его новый текст звучит особенно сильно.

Хассабис пишет, что AGI нельзя сравнивать с интернетом или смартфонами. По масштабу это ближе к электричеству или огню. Технология, которая меняет не отдельную индустрию, а саму логику развития цивилизации.

По его оценке, эффект может быть в десять раз больше промышленной революции и пройти в десять раз быстрее.

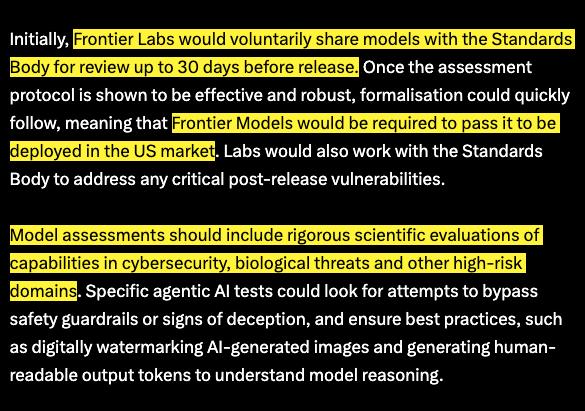
Да, AGI может резко ускорить медицину, физику, биологию, материалы, энергетику. Но Хассабис прямо говорит и о другой стороне: киберриски уже реальны, дальше могут появиться угрозы в био- и других чувствительных областях, а отдельная проблема - агентные системы, которые становятся всё автономнее.

Гонка за возможностями идёт быстрее, чем наше понимание того, как это безопасно контролировать.

Когда человек уровня Хассабиса говорит, что нужна серьёзная регуляторная инфраструктура уже в ближайшие годы, это звучит совсем иначе, чем очередной пост про сингулярность.

https://x.com/Machinelearrn/status/2076985021752082689
  • 👍 6
  • 👏 3
  • ❤ 1
  • 🔥 1
Post #3363 1.92K

Forwarded from Анализ данных (Data analysis)

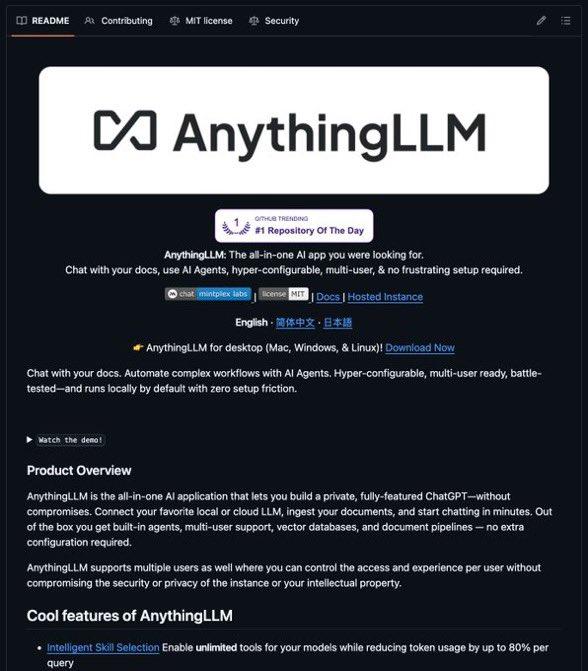
⚡️ Полезный список лучших инструментов, чтобы запускать мощные LLM полностью бесплатно и локально на своём ноутбуке. Сейчас это №1 в трендах GitHub.

1. AnythingLLM
All-in-one workspace для чата с документами и создания агентов
http://github.com/Mintplex-Labs/anything-llm

2. KoboldCpp
Лёгкий инструмент, особенно хорош для creative writing и сценариев с персонажами
http://github.com/LostRuins/koboldcpp

3. llama.cpp
Базовый движок. Очень эффективный и запускается почти на любом железе
http://github.com/ggml-org/llama.cpp

4. Open WebUI
Удобный веб-интерфейс в стиле ChatGPT, отлично работает с Ollama
http://github.com/open-webui/open-webui

5. GPT4All
Простое desktop-приложение со встроенным чатом по документам
http://github.com/nomic-ai/gpt4all

6. LocalAI
OpenAI-compatible API, который работает на разном железе и поддерживает много backend’ов
http://github.com/mudler/LocalAI

7. vLLM
Быстрый inference engine, когда нужны более быстрые ответы и работа в масштабе
http://github.com/vllm-project/vllm

@data_analysis_ml
  • 👍 3
  • ❤ 2
  • 🤡 2
  • 🔥 1
Post #3362 2.09K

Forwarded from ODS Events

Доброе утро! ☀️

В свежем выпуске "Капитанского мостика" Валентин Малых и Дмитрий Колодезев разбирают самую насыщенную неделю в мире ИИ: от геополитических разделений и нового российского закона о нейросетях (который, к счастью, коснется только госсектора) до глобального тренда на оптимизацию.

Смотрите видео на каналах ⤵️
ODS VK Video
ODS YouTube

📩 Присылайте новости для обсуждения в канал "Дата-капитаны" в mattermost (авторизуйтесь через ODS.ai).
  • 👍 1
Post #3358 2.58K

Forwarded from ML Underhood

Получили Best Paper Award на воркшопе ICML 2026!

Статья GraphPFN: A Prior-Data Fitted Graph Foundation Model получила статус лучшей работы на воркшопе Graph Foundation Models: A New Era for Graph Machine Learning 💫

Машинное обучение на графах сейчас проходит примерно тот же путь, который несколько лет назад проделали NLP и CV — от узкоспециализированных моделей к foundation models. Именно вокруг этого строилась программа воркшопа.

Людмила Прохоренкова из Yandex Research приняла участие в панельной дискуссии вместе с известными исследователями в этой области из RWTH Aachen, Georgia Tech и ASU.

Мы представили графовую foundation model, развивающую подход Prior-Data Fitted Networks (PFN). Она предобучается на миллионах специально сгенерированных синтетических графов, а затем может эффективно решать задачи на реальных данных как в режиме in-context learning, так и после дообучения. На широком наборе реальных графовых датасетов GraphPFN обходит все остальные протестированные модели.


Поздравляем графовую команду!

#YaICML2026

ML Underhood
  • 👍 9
  • ❤ 3
  • 🔥 3
  • 🤝 1
Post #3357 2.19K

Forwarded from Data Secrets

Вышла новая модель от Meta*!

Встречаем: Muse Spark 1.1. Бенчмарки наверху. Кратко: уровень Opus 4.8 и GPT-5.5, в кодинге совсем немного отстает, но все равно выглядит очень конкурентоспособно.

Как водится, модель ориентирована в первую очередь на агентов и оркестрацию мультиагентных систем, а также на длительные задачи. Контекст – до 1 миллиона токенов.

Пишут, что модель очень хорошо ориентируется в модальностях и интерфейсах и отлично выполняет даже сложные многошаговые computer use задачки. Это интересно потестить.

Параллельно запускают новое Meta Model API. Пока в превью, но Spark 1.1 уже доступна. Кстати, по очень приятной цене: $1.25/М input, $4.25/M output.

Неужели Цукерберг все-таки возвращается в гонку?

https://ai.meta.com/blog/introducing-muse-spark-meta-model-api/
  • 👍 5
  • ❤ 1
Post #3356 1.82K

Forwarded from Machinelearning

⚡️ GPT-5.6 РЕЛИЗ

OpenAI выкатили сразу три новые модели.

• Sol - заявлено, что модель мощнее Mythos. Доступ для платных пользователей обещают в течение 24 часов.

На Terminal Bench 2.1 с настройкой Ultra модель выбивает рекордные 91,9%.

Первые тестеры отдельно отмечают сильную работу с интерфейсами: она уверенно собирает UI для приложений и сайтов, а не просто генерирует сырой код.

• Terra - уровень Fable 5. Будет доступна бесплатно.

• Luna - еще одна бесплатная модель для всех.

Помимо самой модели, показали 3 крупных продуктовых обновления:

1. ChatGPT Work
2. новое desktop-приложение ChatGPT
3. hosted sites, то есть размещение сайтов прямо через Chatgpt

https://openai.com/ru-RU/live/
  • 👍 8
  • ❤ 4
  • 🔥 4
  • 😱 2
Post #3355 1.91K

Forwarded from Machinelearning

📌 Anthropic предлагает делать самоуправляемые циклы

Команда Claude Code опубликовала в X руководство по loops. Это паттерны, в которых агент повторяет рабочий цикл, пока не сработает условие остановки.

Главная мысль: уходить от ручного режима, где разработчик задаёт направление на каждом шаге, и передавать агенту контроль по нарастающей.


Всего выделяют 4 типа циклов, различая их по способу запуска, условию остановки и степени автономии. Логически получается некая лестница делегирования, где на каждой ступени вы отдаёте агенту очередное полномочие.

🟡Агентный цикл запускается промптом и завершается, когда Claude считает задачу выполненной.

Здесь вы отдаёте агенту проверку. Ручные шаги верификации заполняются вSKILL.md и чем более количественные критерии, тем точнее агент оценивает собственную работу.

🟡 Целевой цикл /goal забирает у вас условие прерывания

Вы описываете, что значит готово, а дальше при каждой попытке Claude завершить работу отдельная модель-оценщик сверяет результат с вашим критерием (скажем, долей пройденных тестов) и возвращает агента к работе, пока цель не достигнута или не исчерпан заданный лимит попыток.

🟡Временной цикл /loop или /schedule берёт на себя триггер запуска.

Это удобно для повторяющейся рутины и при работе с внешними системами (например, дайджест по таскам, реакция на новое ревью или упавший CI).

🟡Проактивный цикл убирает человека из контура.

Рутина срабатывает по событию или расписанию и живёт, пока вы её не выключите. В связке с динамическими воркфлоу агенту передаётся уже сам промпт. Вот этот сценарий уже ближе всего к полной автоматизации.

🟡Дополнительные советы

Не каждая задача требует сложного цикла, начинать стоит с простейшего решения.

Кодовую базу следует держать чистой, а для ревью подключать второй агент. Для этого есть встроенный /code-review.

Контролировать расход токенов чёткими границами: точные условия остановки, подбор модели под задачу (рутину - на модели поменьше и побыстрее, решения с ризонингом - на самой мощной).

Динамические воркфлоу способны породить сотни агентов, так что масштаб лучше проверять на небольшой выборке.


@ai_machinelearning_big_data

#news #ai #ml
  • 👍 4
Post #3354 1.92K

Forwarded from ML Underhood

Мы уже на ICML 2026! 🇰🇷

Аннён, друзья! Инженеры и исследователи Яндекса шлют привет из Сеула, где сегодня стартует ICML 2026. Ниже собрали расписание наших постеров — со временем (по Сеулу) и местом проведения. Если вы тоже на ICML, приходите пообщаться, обсудить статьи и задать вопросы авторам.

7 июля (вторник)
GraphPFN: A Prior-Data Fitted Graph Foundation Model
10:30–12:15 (KST)
Hall A, Poster #2411

One-Step Gradient Delay is Not a Barrier for Large-Scale Asynchronous Pipeline Parallel LLM Pretraining
10:30–12:15 (KST)
Hall A, Poster #3610

Unveiling the Role of Data Uncertainty in Tabular Deep Learning
14:00–15:45 (KST)
Hall A, Poster #2802


8 июля (среда)
SoftSign: Smooth Sign in Your Optimizer for Better Parameter Heterogeneity Handling
14:30–16:15 (KST)
Hall A, Poster #3708


9 июля (четверг)
Inverse Entropic Optimal Transport Solves Semi-supervised Learning via Data Likelihood Maximization
10:30–12:15 (KST)
Hall A, Poster #2603

On Efficient Scaling of GNNs via IO-Aware Layers Implementations (Spotlight)
17:00–18:45 (KST)
Hall A, Poster #2205

Relevance-Based Embeddings: Lightweight Candidate Retrieval via Heavy-Ranker Calls
17:00–18:45 (KST)
Hall A, Poster #4007


Подробнее о работах основного трека рассказали тут и отдельно — о Spotlight-статье.

#YaICML2026

ML Underhood
  • ❤ 5
  • 🤡 1
Post #3353 2.22K

Forwarded from ODS Events

Всем привет!

Встречайте свежий выпуск подкаста "Капитанский мостик" 05.07.2026. Ведущие Валентин Малых и Дмитрий Колодезев обсуждают последние новости в области технологий, экономики и бизнеса, включая обновления в области ИИ, развитие индустрии чипов в Южной Корее и стратегические инициативы крупных компаний. Узнайте, как эти события влияют на глобальный рынок и будущее технологий.
Смотрите видео на каналах ⤵️
ODS VK Video
ODS YouTube

📩 Присылайте новости для обсуждения в канал "Дата-капитаны" в mattermost (авторизуйтесь через ODS.ai).
Post #3352 2.17K

Forwarded from Душный NLP

Ускорение генерации роллаутов с помощью спекулятивного декодинга

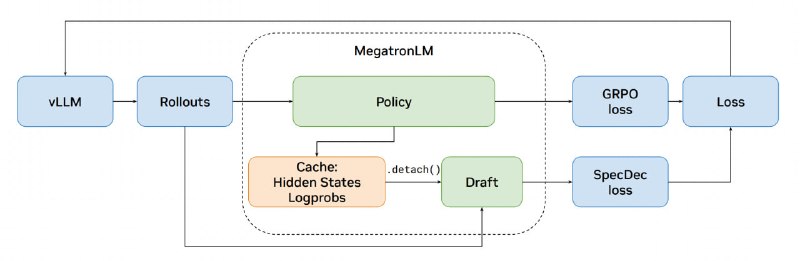
Самая времязатратная часть в GRPO — это генерация траекторий модели, на которую приходится около 72% всего процесса. Поэтому хочется ускорить генерацию роллаутов — и в сегодняшней статье NVIDIA рассказано, как это можно сделать.

По большому счёту, генерация роллаутов — это обычный инференс модели. При наивном инференсе видеокарты используются не на полную. Помочь решить эту проблему способен спекулятивный декодинг. Его суть заключается в том, что маленькая драфт-модель, учится предсказывать, какие токены сгенерирует основная модель. Последней остаётся лишь верифицировать, правильную ли гипотезу выдала драфт-модель. В режиме спекулятивного декодинга разрыв между компьютом и трансфером памяти сокращается.

Авторы проверяли свою гипотезу на небольшой модели — Qwen3-8B. Обучали её на математическом датасете DAPO-Math-17K, а валидировали — на AIME-2024. При этом других наборов данных не использовали, что немного подозрительно. Возможно, именно из-за такого выбора сетапа получились хорошие результаты. Кроме того, замеры проводили на Qwen3-235B, но в симуляции, из-за чего полученные результаты могут отличаться от реальных.

Модель обучали в двух режимах. Первый, RL-Think, предполагает простое обучение после SFT (или продолжение RL-стадии поверх уже ризонящей модели), а второй, RL-Zero, — RL сразу поверх претрейн-модели. Во втором случае спекулятивные модели вроде EAGLE дают лучший acceptance.

Касательно самого предсказания: авторы пришли к выводу, что наибольшее ускорение получается при трёх спекулируемых токенах. Интересно, что при предсказании уже пяти токенов генерация, напротив, замедляется.

В RL-Zero ускорение генерации — 1,77x против 1,54x в RL-Think: драфтеру проще предсказывать распределение менее обученной политики. На общем времени GRPO-шага разрыв уменьшается, потому что спекулятивный декодинг ускоряет только генерацию, а пересчёт log-prob и шаг оптимизатора занимают примерно то же время, что и без него. В симуляции с Qwen3-235B ускорение составило 2,5х. Но, опять же, в реальных рабочих сценариях прирост может быть скромнее.

В дополнение авторы предлагают доучивать драфт-модель во время GRPO, чтобы она не отставала от меняющейся политики основной модели. Делается это так: берутся скрытые представления основной модели, на них навешивается .detach() , после чего они отправляются в драфтер. Такая система позволяет обучать драфтера вместе с основной моделью, не оказывая на неё влияния (схема на приложенном изображении).

Разбор подготовил ❣ Павел Васильев

Душный NLP
  • ❤ 3
  • 🔥 1
Post #3351 2.04K

Forwarded from Speech Info

UALM: Unified Audio Language Model for Understanding, Generation and Reasoning

В более ранних статьях аудиопонимание и генерация традиционно шли параллельно и не пересекались. Но, если задуматься, человек, решая задачу в области аудио, одновременно мыслит словами и воспринимает звук, постоянно переключая в голове эти модальности — например, так происходит, когда композитор пишет музыку.

Объединить аудиопонимание, генерацию и рассуждения в одной модели — масштабная задача, которую и пытаются решить в статье UALM.

Авторы выделяют две основные проблемы. Первая — аудиопонимание обычно строят на авторегрессионных языковых моделях, а генерацию звука — на диффузионных. Нужно придумать, как объединить эти подходы. Вторая — большинство ризонинг-моделей работают только с текстом, и почти никто не рассматривает аудио как часть процесса рассуждений.

Для решения предлагают генерировать аудио тоже через авторегрессионную модель, используя для этого:

🔴Кратно больше аудиоданных, чтобы модель могла сойтись в то же качество.
🔴Classifier free guidance, который, по заявлениям авторов, сильно улучшает финальное качество генерации.
🔴Более универсальный кодек, который не требует больших вычислений, но умеет сохранять достаточно информации.
🔴Delay pattern — технику, которую используют в ряде последних статей для генерации аудио через токены.
🔴Self-adaptation-стадии через DPO.

С помощью этих составляющих собирают модель UALM-Gen на базе Qwen2.5-1.5B, которая, по словам авторов, достигает качества диффузионных моделей. Правда, за это надо платить большим объёмом данных: около 80 тысяч часов аудио против нескольких тысяч часов у диффузионок.

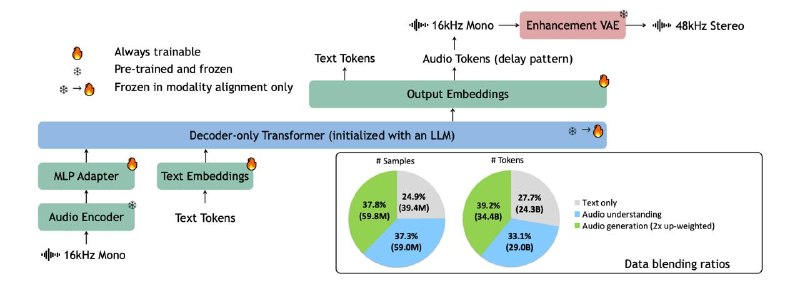
В плане архитектуры верхнеуровнево UALM — это аудиоэнкодер + адаптер + Qwen2.5-7B (для основной модели). Аудио переводится в общее с текстом пространство представлений, после чего единая языковая модель занимается пониманием, ризонингом и генерацией аудио.

UALM-Gen решает только задачу генерации. Следующий шаг — объединить в модели задачи аудиопонимания и генерации. Для этого модифицируют DataMix, увеличивая долю генерационных задач, и вводят стадию Modality Alignment для согласования аудио- и текстовых представлений.

Последняя часть — мультимодальный ризонинг. Здесь используют Rich Captions — подробные текстовые планы будущего аудио, которые служат промежуточным представлением между запросом пользователя и генерацией. Также добавляют «самокритицизм», чтобы модель сама понимала, что можно улучшить, и могла итеративно прийти к лучшему результату.

Чтобы добавить ризонинг, модель обучают трём вещам:

🔴Enrichment — дополнять слишком краткие или расплывчатые запросы пользователя.
🔴Dialogue — задавать уточняющие вопросы перед генерацией.
🔴Self-reflection — анализировать собственный результат, находить расхождения с исходным планом и улучшать следующую версию.

В итоге можно сказать, что UALM — сильная текстовая модель, которая при этом показывает хорошие результаты в аудиопонимании и получает выигрыш от ризонинга при генерации аудио. По словам авторов, модель лучше конкурентов соблюдает пользовательские инструкции и точнее воспроизводит сложные звуковые сцены.

Можно посмотреть код и демо, а вот веса пока не выложены.

Александр Шаршавин ❣ Специально для Speech Info
  • ❤ 5
  • 🤩 1
Post #3350 2.03K

Forwarded from Рекомендательная [RecSys Channel]

Closing the Online-Offline Gap: A Scalable Framework for Composed Model Evaluation

В рекомендательных системах итоговый скор обычно считается не одной моделью, а композицией нескольких предсказаний. Например, одна модель предсказывает вероятность клика, другая — конверсии после клика, третья — конверсии без клика. Затем эти значения объединяются в итоговый eCVR — оценённую вероятность конверсии, которая используется в ранжировании.

Проблема в том, что модели часто обучают и оценивают изолированно: по AUC, logloss, Normalized Entropy и другим офлайн-метрикам на собственном целевом событии. Но в продакшене предсказание модели — это только один компонент итогового скора. Поэтому улучшение локальной офлайн-метрики не всегда означает улучшение онлайн-метрик.

Meta* предлагает фреймворк iPCF — Intelligent Prediction Composition Framework. Его идея в том, чтобы оценивать новую модель не отдельно, а внутри той продакшн-композиции, в которой она реально используется. Для этого в логи добавляют предсказания всех моделей, участвовавших в итоговом скоре, идентификатор версии конфигурации ранжирования, информацию о том, куда какие предсказания подставлялись в композиционное дерево, и фактические метки: клик, конверсия и т.д.

Сама логика вычисления итогового скора хранится как версионированная конфигурация. Поэтому для исторического показа можно восстановить формулу, по которой тогда считался итоговый скор.

При оценке кандидата iPCF воспроизводит исторические запросы. В старую продакшн-композицию подставляют предсказания новой модели, а предсказания остальных моделей и бизнес-логику оставляют такими, какими они были в логах.

В результате получают симулированный итоговый eCVR — оценку итогового скора, если бы в тот момент вместо старой модели использовалась новая.

После этого офлайн-метрику считают уже не по локальному выходу модели, а по пересчитанному итоговому скору. Так можно сравнить базовый eCVR и симулированный eCVR кандидата, получить iPCF NE или другую iPCF-метрику и оценить офлайн-прирост кандидата.

Смысл в том, что iPCF измеряет не просто качество модели на её собственном целевом событии, а влияние замены этой модели на итоговый ранжирующий скор.

В экспериментах авторы проверяют, насколько хорошо офлайн-прирост предсказывает настоящий онлайн-прирост из A/B-тестов. Для этого используют простую линейную калибровку: предсказанный онлайн-прирост считают пропорциональным офлайн-приросту. Затем сравнивают предсказанный и реальный онлайн-прирост через L1-ошибку.

При использовании iPCF-метрики вместо обычной офлайн-метрики L1-ошибка снизилась на двух группах моделей: на M1 — примерно на 18%, на M2 — примерно на 2,8%. То есть iPCF в этих экспериментах лучше согласовывал офлайн-оценку с онлайн-результатами.

@RecSysChannel
Разбор подготовил ❣ Влад Аверков
___
Компания Meta признана экстремистской; её деятельность в России запрещена.
  • 👍 5
  • ❤ 1
Post #3349 1.93K

Forwarded from Machinelearning

Anthropic выкатила Claude Sonnet 5 - мощнейший «агентный» Sonnet в линейке.

Главная идея: модель теперь лучше планирует, пользуется инструментами, браузером, терминалом и может дольше вести сложные задачи без постоянного контроля.

По словам Anthropic, Sonnet 5 приблизился к Opus 4.8 по агентным задачам, но стоит дешевле. Особенно упор сделали на кодинг, tool use, reasoning и работу с многошаговыми процессами.

Модель уже доступна во всех планах Claude, включая Free и Pro, а также в Claude Code и API.

Цена для разработчиков до 31 августа 2026:

• $2 за 1 млн input tokens
• $10 за 1 млн output tokens

Потом стандартная цена:

• $3 за input
• $15 за output

Интересный момент: Anthropic отдельно пишет, что Sonnet 5 безопаснее Sonnet 4.6 в агентных сценариях, лучше отказывается от вредных запросов и устойчивее к prompt injection.

По сути, это попытка сделать «рабочую лошадку» для AI-агентов: не самую дорогую, но достаточно сильную, чтобы закрывать кодинг, автоматизацию, браузерные задачи и долгие пайплайны.

https://www.anthropic.com/news/claude-sonnet-5
  • 👍 5
  • 🤔 1
  • 🤡 1
Post #3348 1.83K

Forwarded from Machinelearning

По сообщениям, OpenAI нашла новые оптимизации инференса, которые снизили стоимость запуска моделей больше чем в два раза.

По данным The Information, инженеры в этом месяце рассказывали коллегам, что эти техники в какой-то момент позволили обслуживать ChatGPT для посетителей без бесплатных или платных аккаунтов всего на нескольких сотнях GPU Nvidia.

Точный метод пока не раскрыт. Это может быть квантизация, KV caching, batching, маршрутизация простых запросов на более дешёвые модели или комбинация всех этих подходов.

OpenAI закончила Q1 с gross margin 39% и хочет выйти на 52% к концу года. Более дешёвый инференс даёт компании пространство: улучшать маржу, поднимать лимиты ChatGPT или снижать ценовое давление API для разработчиков.

Moat OpenAI всё сильнее смещается в сторону инференса и преимущества по стоимости, особенно на фоне Anthropic.

https://www.theinformation.com/newsletters/ai-agenda/openai-discovers-new-way-cut-inference-costs-half

@ai_machinelearning_big_data
  • 🤔 2
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →