


Pandas💂♀️ В основном создание колонок по условию требуется для изменения гранулярности данных, например, вместо того, чтобы отдельно рассматривать пользователей по конкретному возрасту, удобнее сформировать из них смысловые группу: молодые (18-30), средние (31-59) и пожилые(60+).
🏕️ Метод 1:
iterrows() построчно обрабатывает в Data Frame записи и применяет условную логику для создания нового столбца:for index, row in df.iterrows():
if condition:
df.at[index, 'new_column'] = value
else:
df.at[index, 'new_column'] = other_value
👩🎤 apply() в pandas позволяет нам применить функцию по осям (строки, колонки) к Data Frame:def conditional_logic(row):
if condition:
return value
else:
return other_value
df['new_column'] = df.apply(conditional_logic, axis=1)
np.where() обеспечивает векторизованный подход к созданию условного столбца. Мы можем указать условие и присвоить значения на его основе: df['new_column']=np.where(condition, value, other_value)
👍 np.select() позволяет нам создать новый столбец на основе нескольких условий:
conditions = [condition1, condition2, condition3]
choices = [value1, value2, value3]
df['new_column'] = np.select(conditions, choices, default=other_value)
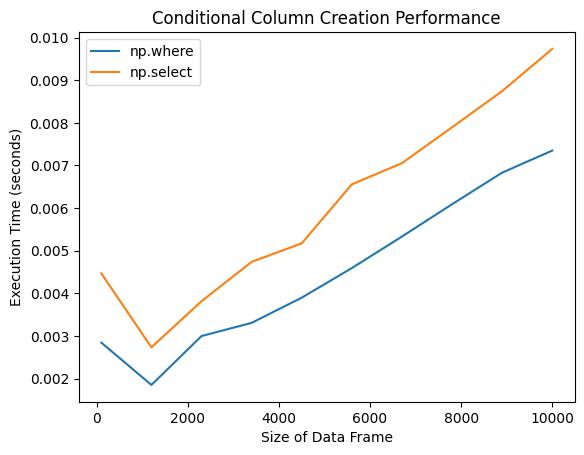
iterrows очевидно занимает последнее место, самый популярный метод apply быстрее примерно в 7 раз при 10 000 строк. В упорной борьбе побеждает np.where, который в 263 раза быстрее, чем iterrows, в 35 раз быстрее apply и всего лишь в 1.3, чем np.select. 🔬 В который раз убеждаемся, что numpy - лидирующая библиотека, когда необходимо добиться максимальной скорости.
✒️ Какие еще применения условного создания колонок Вы знаете? Какой метод используете?
😀 Подписаться
#pandas #numpy #python