



Интересно, почему весь интернет хайпит на том, что LLMки научились не только понимать картинки, но и генерировать, и при этом я не вижу сравнений Google и OpenAI, которые выкатили эту фичу с разрывом в неделю.
Исправляю 🙃
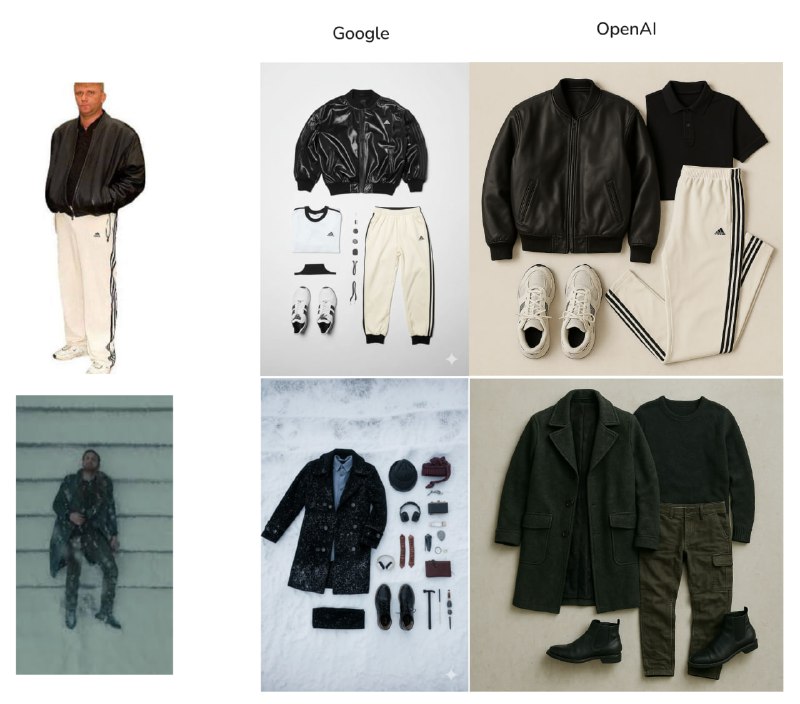
Нагенерил разных экспериментов, которые было интересно поделать. Последние две фотки даже вполне бизнесовые кейсы
Что я заметил:
1. OpenAI работает сильно дольше. Мощнее модель и качество у них лучше. А Google требует на порядок больше танцев с промптами, зато за 10 секунд все готово
2. OpenAI хорошо удерживает "модель мира" – видно на задачке с одеждой. Их модель прям понимает, что за шмотки. Google просто генерирует что-то отдаленно похожее
3. При этом OpenAI постоянно меняет мелкие детали 🥴. Видно по измененным чертам лица, лошади, фону
4. А Google наоборот хорошо их удерживает. Кажется, они сделали какой-то хак, чтобы генерация "цеплялась" за входную картинку. Но сама генерация слабее, так что как только отходим достаточно далеко от исходного изображения, все резко становится хуже. Особенно на одежде видно – т.к. одежда в совсем другом положении – по сути генерация с нуля.
Лайфхак – чтобы "отцепить" от входного изображения, можно просить сделать с нуля, а не переделать.
* create anime character > turn person into anime
* generate high resolution picture with character > upscale picture
tl;dr
Если хотим оставить большую часть изображения как есть → Google + детальные промпты
Если хотим поменять положение объектов или сгенерить с нуля → OpenAI
Ну и комбинировать, конечно.
Вы знаете кому отправить этот пост:)