TGViewer
Channel Public Channel
notes.ml

notes.ml

@notesdotml

Рабочие заметки ML инженера
Автор: @m1trm
Subscribers
159
Photos
33
Videos
0
Links
38

Showing posts older than #44 · Back to latest

Older Posts 20 shown
Post #43 264
notes.ml Появятся закрытые бенчмарки, на которые станут опираться вендоры для продвижения своих AI-first продуктов
Wiz опубликовали AI Cyber Model Arena.

Промежуточные результаты:

One central takeaway from the results is that offensive capability is jointly determined: the same model can swing dramatically depending on the agent scaffold, and performance is highly domain-specific. No single pairing dominates across all categories-even when one combination leads in most of them.


Готов поспорить на бокал светлого, что в этом году Wiz (Самый дорогой кибербез стартап ever, который в 2025 купил гугл) после публикации закрытого бенчмарка попытаются попасть в него с собственным решением.

Исходя из костов на реализацию, я предполагаю, что они выложат своего агента, который будет соперничать с внешними вендорами, но закрытые модели будут не их (на лидерборде поделили фильтрацию по агентам и моделям).

Но возможно они удивят всех, выложив в 2026 и агента, и модель.

Место тех репорта на лендинге арены еще пустует, в общем следим 👀
wiz.io AI Cyber Model Arena: Testing AI Agents in Cybersecurity | Wiz Blog AI Cyber Model Arena benchmarks AI agents across 257 real-world security challenges spanning zero-days, CVEs, API, web, and cloud security.
Post #42 327
Свежая и интересная статейка с А-лвл конфы про обнаружение атак в трафане через мультимодальные ансупервайзд эмбединги трансформера (представление сессии, хоста, пакетов), сжимая всё до вектора размером 100, на который уже можно накидывать головы для даунстрим задачи (исследуют классификацию вредоносного трафика, но в future works обещают ресерч на детект впн-ов).

tldr: Метрики на публичных бенчмарках все 0.99, в каждом из которых новая SOTA.

Для тех, кто отчаялся искать приложение академическим статьям в жизни:

Пишут что понимают, что датасеты могут быть херня, поэтому собрали стенд и позвали на него 100 пользаков и несколько ред-тим команд погенерить атаки. Симуляцию проводили неделю и вот какие цифры получили:
- было нагенерено "25.43M flows (884.25M packets), where 4.823% flows (3.263M packets) are associated with abnormal behaviors"
- из них, эксперты ИБ для обучения даунстрима взяли только 87 чистых сессий с первых 20 минут симуляции, в который уже было снято 90,319 сессий (тот самый "Training with Only 1.0 ‰ Samples" из названия статьи)
- работали на "4.588K packets per second (PPS)" и может разгоняться до "7.75 M PPS maximum efficiency."
- перф тест дал "The embedding module, sequence model, feature fusion, and AutoML module
exhibit 0.23ms, 6.34ms, 0.79ms, and 2.02ms latency, respectively"

- по качеству генерили "2.322 false alerts per hour"
- а ML метрики обнаруженного вредоносного трафика "tFusion achieves 0.9975 AUROC, 0.9882 AUPRC, 0.9798 Precision, and 0.9982 Recall on average"


Читать советую полную версию с github, там код рядышком

[код] [полная папира] [журнальная папира]
  • ❤ 2
  • ⚡ 1
Post #41 168
notes.ml Появятся закрытые бенчмарки, на которые станут опираться вендоры для продвижения своих AI-first продуктов
https://www.irregular.com/publications/cyscenariobench

Although the evaluation set remains private to avoid contamination, we detail our methodology below. The Benchmark is already used by some frontier models.


👀
Irregular CyScenarioBench: Evaluating LLM Cyber Capabilities Through Scenario-Based Benchmarking - Irregular CyScenarioBench introduces a scenario-based approach for assessing LLM cyber capabilities across full attack workflows. By modeling realistic operational conditions, it surfaces behaviors and risks not apparent today by task-level benchmarks, offering a clearer…
  • 🔥 1
Post #40 250
Делаем Google AI Mode основным движком chrome

Заметил за собой, что часто перехожу в этот режим после короткого AI Overview в стандартном поиске google. Поэтому сделал его дефолтным в chrome браузере и делюсь этим простым рецептом:

1. Заходим в "Управление поисковыми системами" или пишем в поисковой строке:
chrome://settings/searchEngines

2. Добавляем быструю команду в блоке "Поиск по сайту". Имя и сама команда не имеют большого значения (например: AI Gemini Search и @aim), а в поле URL вставляем:
https://www.google.com/search?q=%s&udm=50&ie=UTF-8

или
https://www.perplexity.ai/search?q=%s


3. Нажимаем на ( ⋮ ) и выбираем "Использовать по умолчанию"

Готово, AI browser прямо не выходя из chrome:)

UPD: Спасибо Степе, в комментах навел на мысль, что заметка применима к любым поисковым AI-движкам, пост обновил
  • ✍ 4
Post #39 198
Понял, что подсознательно проверяю AI/LLM функции во всех сервисах, которые использую.

Прохожу курс по работе SOC и при анализе дампа трафика на PacketSafari заметил копайлота, которому скормил часть задания. Он успешно справился с выдвижением гипотезы о NTLM-Relay (тут вникал в то, что это такое).

Весь репорт стоит 8$, но топ-3 проблемы выдает бесплатно, советую поиграться
Post #38 183
Основные тезисы, вокруг которых строил работу в 2025-м

Часть 1
Часть 2 (вы тут)

3️⃣ 0.9 * 0.9 * 0.9 * 0.9 * 0.9 = 0.6

О
чем речь? О качестве современных агентов. LLM обладают некоторой стохастичностью ответа, могут иметь галлюцинации, поэтому математика агентских систем может быть удручающей: при качестве отдельного ответа 90% мы получаем на 5 итерациях агента с качеством 60% из-за того, что ошибка на одном из шагов повлияет на все последующие.

По этой причине каждому советую побороть желание сразу бежать делать агента и следовать следующей цепочке:
request -> flow -> agent


Прогноз на 2026 #4: Многие LLM-agent проекты схлопнутся, поскольку агенты на фронтир моделях не смогут адаптироваться под переезд на более дешевые/маленькие LLM (ограничение production, или требования заказчика/регулятора, или снижение бюджета). Развитие small-LM не успеет дойти до нужного качества в 4B моделях, приблизившись к нему только в 2027 году.


4️⃣ Притча о мальчике, который кричал "волки" "LLM"

R&D очень хочет построить агентов, а бизнес очень хочет рассказать об LLM-агентах клиентам/инвесторам (потому что кривая хайпа по гартнеру). Эта лихорадка приводит к тому, что многие проекты лоббируются и внедряются без должной проверки качества. Но с насыщением рынка у всех появятся LLM фичи. А раз есть у всех, то это не назвать конкурентным преимуществом. На чем вывозить дальше?

Прогноз на 2026 #5
: Рынок изменит риторику с вопроса "а может ли агент делать Х?" на вопрос "с каким качеством агент может Х?", само наличие LLM в продукте перестанет быть конкурентным преимуществом.


5️⃣ Как же мерить качество LLM фичей?

За этот год собрал коллекцию паттернов и антипаттернов оценки качества, которым хотел бы поделиться с вами:
1) Лабы жадно пылесосят интернет, поэтому ценность открытых бенчмарков сводится на нет ("Training on the test set is a new art form", - Андрей Карпати). Верьте регулярно обновляемым бенчмаркам (как SWE-rebench) или стройте свой закрытый (как LLM in business workloads). К слову, мы пошли по второму пути для оценки LLM в обнаружении вредоносного кода.
2) Не используйте LLM судей. Во-первых смотрите выше в посте п.3, во-вторых они предвзяты к длине и стилю текста, в-третьих деградируют при смене модели.
3) Следите за стабильностью ответа, делайте тесты на воспроизводимость с аугментацией входных даннх (подчерпнул из разбора статьи по LLM в анализе уязвимостей)
4) Тестируйте не только финальное решение, но и цепочку размышлений. Используйте SGR/SO для валидации качества промежуточных этапов размышления модели.


Прогноз на 2026 #6
: Крупные вендоры и независимые консалтинговые агентства начнут монетизировать оценку качества агентов в коммерческих рынках. Появятся закрытые бенчмарки, на которые станут опираться вендоры для продвижения своих AI-first продуктов


P.S. Всё, пошел резать салаты к новому году, всех обнял 🎄
  • ❤ 6
  • 👏 1
  • 🤝 1
Post #37 127
Основные тезисы, вокруг которых строил работу в 2025-м

Поддерживая общую традицию, провожаю год размышлениями вокруг и около работы инженера по машинному обучению (разгон о t-shaped инженерах продуктовых команд).

Это всё добро копилось для отдельных постов, но я так и не смог порадовать вас их публикацией:)

Часть 1 (вы тут)
Часть 2

1️⃣ Меняется ландшафт задач ML-инженера

Что раньше находилось за гранью понимания стейкхолдеров?
*тут смежник помогал с тз, сбором данных и разметкой* -> чистка данных -> фиче-инжениринг -> обучение модели -> валидация -> написание обертки для прода -> *тут мы смотрим как смежник радуется, что эта магия работает*

Теперь же LLM-ки схлопывают первые 3 этапа нашей работы (не совру, если скажу, что 99% проектов решаются через context-engineering/RAG без файнтюна), а LLM-API настолько простое, что последний пункт тоже не требует специфики MLE.

Велик соблазн сократить всех мльщиков и просто научить остальное R&D работать с OpenAI-API, да? (Ладно, оставим бедолаг делать олдовый ML, иногда же мы хотим дешевый highload без кластера из GPU)

Прогноз на 2026 #1: ограничения ресурсов в проде будет дальше толкать спрос на small-LM модели из-за их низкого порога входа и острого дефицита железа (разное и одновременное: санкции, ограничение рынка предложения, ограничения production систем, тренд на self-hosted).


2️⃣ *смежник сам собрал данных и наинженерил промпты* -> валидация -> *смежник сам затащил в прод*

Да-да, внимательный читатель заметил в цепочке звено, которое требует определенного скилла. У людей, только сейчас получивших доступ к работе с моделями (пусть и большими языковыми), напрочь отсутствует привычка делать качественную валидацию, как правило проживая следующие стадии:
- Вайб-чекнуть на 2-5 кейсах, что модель умеет решать задачу и катить в прод
- Пытаться докидывать few-shot на каждый фолс
- Паниковать от галлюцинаций, когда меняется модель на LLM-бэкенде
- Стать заложником проекта, уточняя промпт и переходя с LLM-flow к агентам, так и не поняв природу галлюцинаций

Чтобы научиться в валидацию, рекомендую замечательную подборку постов от Рината про то, как за неделю привести в порядок типичный LLM проект.

Нужен ли обязательно MLE, чтобы строить валидацию? 2025 показал, что да, но лишь из-за привычки мерить качество у одних, и отсутствие этого навыка у других.


Прогноз на 2026 #2
: LLM фичи с автоматическим бенчмарком (без human-in-the-loop) станут таким же стандартом, как и unit-тестирование в разработке.


Прогноз на 2026 #3
: Как на собеседованиях, так и в работе умение погрузиться в домен продукта станет цениться значительно выше общих знаний теории по машинному обучению. Многие LLM фичи не требуют знаний о способах претрейна или особенностях архитектуры, но неумение грамотно оценить продуктовую ценность может вылиться в убытки для компании, которая сделала ставку на AI.
  • ❤ 2
Post #36 232
Google выкатили AI ассистента для документации репозиториев github - CodeWiki:
- работает только для 6 демо реп, произвольный проект кинуть нельзя
- ссылки на источники в ответах ассистента работают не всегда
- есть фича из NotebookLM с генерацией видео презентации по репозиторию, но видео мега поверхностное

Из обещаний:
We’re building a Gemini CLI extension for Code Wiki so teams can run the same system locally and securely on internal repositories.


tl;dr: пока ни о чем, подождем развития проекта и продолжаем сидеть на DeepWiki
Post #35 257
Кулуарной сходке быть

За время нахождения в ML комьюнити я понял для себя несколько вещей:

1. В кулуарах узнаешь х10 от того, что питчат компании в паблик, а за пивом с другими зрителями можно завести пачку знакомых

2. Не 100% рецепт, но ты можешь зайти дальше в карьере, если будешь думать не только про метрику на выборке и а/б тесты, но и плотно копаться в домене твоего проекта/компании

Поэтому, кхм, АНОНС:

Наша команда делает сходку с двумя узко-доменными докладами, без записи и трансляции, чтобы рассказать чуть больше, чем разрешает pr-отдел компании😏

- доклад от моих корешей про то, как на примере разбора реальной атаки с кибер-соревнований ML позволил ПОЙМАТЬ ХАКЕРА (да-да, это вам не правильные ботиночки на lamoda рекомендовать, тут эндорфинчика побольше)

- приглашенный гость, CTO CelsusAI, расскажет про специфику медицинского DS (что тоже на острие эмоций от пользы, камон)

В общем:

19 ноября, 18:00, Санкт-Петербург, Арт-галерея Zarenkov Gallery

Регистрация обязательна.


P.S. уважаю ребят с рекомендашек, тут просто реверанс моим друзьям))
  • 🔥 4
  • ❤ 1
  • 👍 1
Post #31 242

Forwarded from False Positive

Читаем вместе. ИИ в AppSec: могут ли LLM работать с уязвимым кодом

[хабр-обзор] [папира]

Всем привет!

Решил расширить RG еще и на тексты Хабр, сделал разбор статьи LLMs Cannot Reliably Identify and Reason About Security Vulnerabilities (Yet?): A Comprehensive Evaluation, Framework, and Benchmarks. В качестве затравки — несколько тезисов из разбора:

➡️ Результаты бенчмарка — «фотография во времени», быстро устаревающая не только по списку оцененных моделей, но и по попаданию данных в cut-off более современных LLM. Бенчмаркам на безопасность кода критически не хватает подходов по автоматическому обновлению на подобие SWE-rebench.

➡️ Очень зашли гипотезы про согласованность рассуждений и ответов, проверка на «пропатченном» коде и эксперименты с аугментацией.

➡️ Так, например, даже сильные модели ломаются на стресс-аугментациях, таких как изменения в уязвимом коде названий методов/переменных или добавление неиспользуемого кода.

➡️ Наглядная секция про техники промптинга. Практический вывод: роль-ориентированные инструкции и пошаговый CoT заметно улучшают качество (особенно в zero-shot). Но при наличии few-shot инструкций импакт от CoT снижается. Это может помочь сэкономить контекста в некоторых задачах.

➡️ Ограничение длины контекста в реальных кейсах играет критическую роль, поскольку код, приводящий к уязвимости, может находиться не только в разных частях файла, но и в разных частях проекта. Тут стоит отойти от академических статей и посмотреть на инженерные подходы к отбору контекста разработчиками Cursor, Claude-code и прочих копайлотов для разработки.
__________________

Макс Митрофанов, ML-лид направления AppSec 🟥
  • 🔥 1
Post #28 367
OFFZONE - всё! ®️

Второй год подряд приезжаю на эту конфу и могу точно сказать, что она стоит потраченного времени (и возможно даже денег, но в этот раз прошел через постель доклад) 😄

Треки, связанные с AI/ML, плотно вошли мир кибербеза и им дают всё большие залы с каждым годом.

Также интересно наблюдать, как улучшился материал про GenAI на всех конференциях (не только кибербезных): докладчики сравнивают genAI vs людей vs тулы, создают эвалы/бенчмарки и делятся метриками, а в выступления без метрик сразу вгрызается зал на секции QA 📈

Как говорят на западе:
Reliability >> Capability

Заметки с докладов записаны, нетворк с интересными людьми случился. Из незакрытых гештальтов - очередной раз упустил возможность поработать паяльником и скрафтить что-нибудь на бейдже)

В 2024, потягивая пиво с Колей из ML команды бизона (aka незаменимый ведущий ai трека на offzone), я сказал, что было бы круто в следующий раз поделиться деталями проекта по анализу вредоносного кода, поэтому в двойне ценно, что год спустя у нашей команды получилось рассказать часть в паблик!

Отдельное спасибо всем, кто пришел послушать мой доклад, задавал вопросы или писал их в телеге! 🥰

Думаю, что запись скоро появится тут, а презу скину следующим сообщением:)
  • 🔥 4
  • ❤ 3
Post #26 385
LLM Benchmark in CyberSec

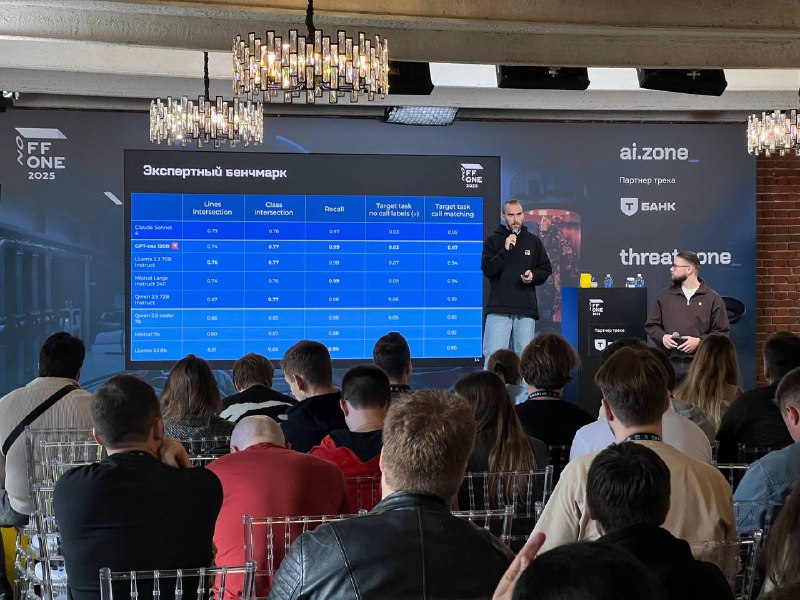
Вчера вышел релиз открытой модели от OpenAI, а сегодня мы уже протестировали 120B версию на внутреннем бенчмарке одной из задач ИБ - обнаружение вредоносного кода.

Хочется отметить, что модель стала лидером в категории тяжелых open-source моделей.

Более того, по метрике вызовов, релевантных вредоносной активности GPT-oss 120B и вовсе стала самой точной из протестированных LLM, обойдя закрытую модель Claude Sonnet 4!

Если есть желание узнать больше о бенчмарке и истории его создания, приходите на конференцию OFFZONE 2025 21 августа в 13:20, зал ai․zone.

UPD: случился фейкньюс, модель 120B, пост выше поправил

---

@notesdotml
  • ❤ 3
  • 🔥 2
Post #24 289

Forwarded from False Positive

С 28 апреля по 1 мая в Сан‑Франциско проходил RSAC 2025 — международная конференция по кибербезопасности. Помимо привычных ИБ‑тем, в программе было много докладов, тесно связанных с AI разной степени применимости — от фундаментальных обсуждений AI-агентов до кейсов применения LLM для триажа, фаззинга и защиты данных.

В эту пятницу специалисты ML‑команды проведут блиц‑разбор семи докладов (по 10–15 минут на каждый) с конференции, которые привлекли наше внимание.

На встрече вы узнаете:
🔹Кейсы внедрения AI в SOC от полевых команд
🔹Какие AI‑инструменты реально помогают специалистам SOC
🔹Как применить ML для классификации данных и предотвращения их утечек
🔹Как будет меняться рынок кибербезопасности с приходом Gen AI
🔹Как интегрировать LLM‑модели в фаззинг‑тестирование и триаж уязвимостей
🔹Как LLM могут помогать маппить алерты на техники и тактики матрицы MITRE
🔹Можно ли создать круглосуточную Purple-team на основе AI-агентов

Ждём всех в Толке в пятницу, 25 июля, в 15:00.
Подключайтесь: Ктолк

#reading_group #conf #rsac
  • ❤ 2
Post #23 213
Наш отдел тут завел канал с нашими обзорами статей и конф, буду сегодня холиварить на тему ии и кибербеза с коллегами

Вход свободный, без смс и регистрации)

Запись появится после встречи в канале
  • ❤ 1
Post #22 407
pov: наш отдел раскатал AI ревьюера

#fun
  • 😁 1
Post #21
Channel photo updated
Post #20 355
Забенчмаркал коллег))

получается, отвечают на уровне gpt-4o
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →