
Недавно нашу статью, которая делает шаг в сторону лучшего понимания этих процессов, Quantifying Logical Consistency in Transformers via Query-Key Alignment приняли на Main Conference в EMNLP, поэтому это хороший повод рассказать о ней немного побольше:)
Reasoning сам по себе — это достаточно большая задача, поэтому мы сосредоточились на ее более простом виде, а именно логическом выводе, подразделе математической логики. Такой подход упрощает анализ: вместо всех возможных сценариев рассуждений мы фокусируемся на конкретных логических подзадачах, которые легко формализовать и контролировать.
⭐️ Что мы сделали
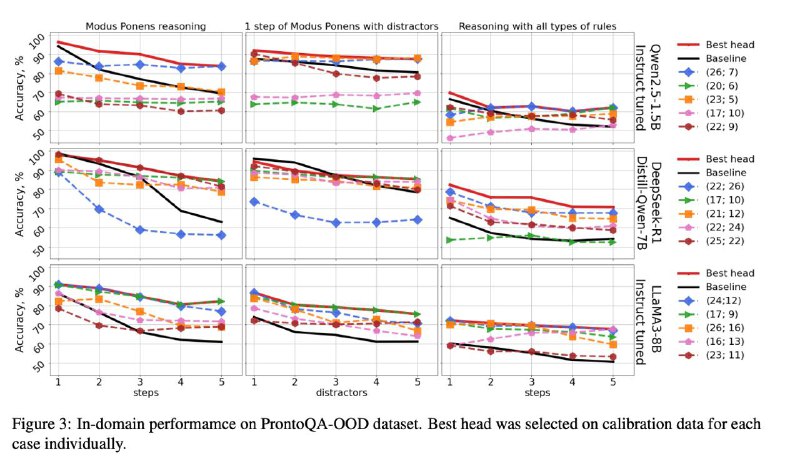
Мы взяли различные типы логических высказываний, например, силлогизмы или модус поненс. Эксперименты проходили в двух форматах:
Базовый вариант: генерировались тексты с прямыми логическими зависимостями.
CONTEXT: If a person uses a fishing rod, they catch fish. Michael uses a fishing rod.
QUESTION: Does Michael catch fish?
Усложненный вариант: в тексты добавлялись «дистракторы» — факты, не связанные с ответом, но способные ввести модель в заблуждение.
Помимо наличия дистракторов, тексты отличались по «сложности», то есть сколько шагов-рассуждений нужно сделать, чтобы дать ответ на вопрос.
Дальше мы анализировали, в каких именно частях модели (мы фокусировались на головах) наиболее ярко проявляется связь между токенами ответа (yes/no, true/false) и самим вопросом через метрику QK-score.
⭐️ QK-score как инструмент анализа
В предыдущей нашей работе мы предложили метрику QK-score: она смотрит на скалярное произведение query-вектор вопроса и key-вектор предполагаемого ответа, показывая, в каком-то смысле, силу их связи. Такая метрика может использоваться сразу несколькими способами:
🔵 как предсказатель ответа (сама по себе),
🔵 как инструмент интерпретации, позволяющий находить «ответственные» головы, которые играют ключевую роль в решении рассматриваемой задачи (так, мы рассматривали выбор ответа из четырех представленных).
Используя QK-score и здесь, мы выделили несколько голов, которые демонстрируют неплохую спосбность делать логический вывод.
⭐️ Что дальше?
Можно ли утверждать, что эти головы «делают» более сложный reasoning? Не обязательно. Но вполне может быть так, что эти два множества голов пересекаются, ведь логические рассуждение — подзадача reasoning. Это открывает путь к следующему шагу: начиная с этих голов, можно изучать, как модель ведёт себя в более сложных сценариях reasoning.