مدل big bird برای زبان فارسی
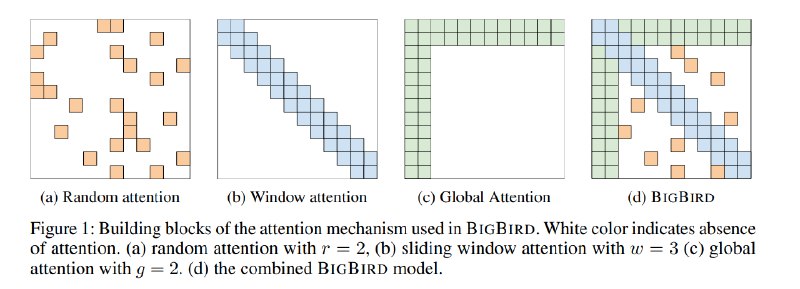
معماری برت با تمامی خوبیهایی که دارد اما یک نقطه ضعف بزرگ دارد که حداکثر رشتههایی با طول ۵۱۲ توکن را میتواند پردازش کند. این محدودیت در واقع ناشی از مرتبه محاسباتی درجه دو مکانیزم توجه بین توکنهای دنباله است (اگر دنباله به طول d باشه، d^2 عمل اتنشن بایستی در داخل آن رخ دهد که خب سنگین است). برای همین بار محاسباتی، چه آموزش و چه تست کردن مدل بر روی دنبالههای بلند عملا ناممکن میشود. این در حالی است که بسیاری از تسکهای پردازش زبان نظیر خلاصهسازی، نیازمند پردازش دنبالههای بسیار طولانیتر از ۵۱۲ توکن هستند. در طی این چند سال اخیر چندین معماری و راهکار جهت حل نیازمندی پردازش دنبالههای بلند خلق و پیشنهاد شدهاند. یکی از این معماریهای پیشنهادی، معماری bigbird است که در آن هر توکن به جای توجه بر تمام توکنها، صرفا به سه مجموعه توکن توجه میکند: توکنهای در همسایگی خود، تعداد اندکی توکن گلوبال و تعدادی توکن رندوم. معماری bigbird با همین ابتکار میتواند دنبالههایی با طول حداکثر ۴۰۹۶ توکن را به خوبی پردازش کند و جزو طلایهداران بعضی وظایف نظیر خلاصه سازی و حتی بعضی مسائل bioای باشد.
حالا آقای ایوبی آمدهاند و اولین مدل فارسی بر پایه bigbird را آموزش دادهاند و در اختیار عموم قرار دادهاند تا راهکاری برای پردازش متون طولانی فارسی باشد. این مدل طبق اذعان ایشان بینقص نیست اما گام اول خوبی جهت تحلیل متنهای بلند در زبان فارسی میتواند باشد. طرز استفاده از این مدل در ریپوی آن آمده است.
لینک ریپو:
https://github.com/sajjjadayobi/ParsBigBird
پ.ن. ۱: میتوانید با استار دادن هم خستگی را از تن توسعهدهنده مدل خارج کنید و هم از تمرکز بر روی پردازش زبان فارسی حمایت کنید. دریغ نفرمایید.
پ.ن. ۲: ریپو یا کد یا مدل یا دیتاست بهدردبخوری داشتید، ندا بدید که بعد از بررسی در کانال قرار بدیم.
#irani
#tool
@nlp_stuff
Post #242
1.97K