مقاله جامع data augmentation در پردازش زبان طبیعی
این مقالهی survey در سیواندیصفحه، دل و رودهی مبحث data augmentation رو ریخته روی داریه.
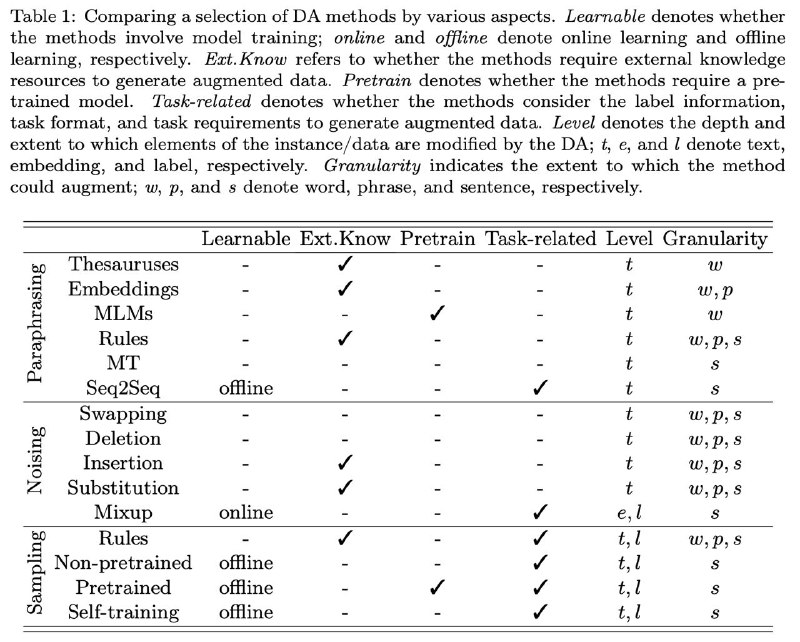
اول اومده روشهای data augmentation در پردازش زبان رو به سه دستهی مدلهای برپایهی Paraphrasing و Noising و Sampling تقسیمبندی کرده و روشهای ارائهشده در هر دسته رو خیلی زیبا و نیکو آورده و با شکل و مثال توضیح داده و از جهات مختلف اونا رو مقایسه کرده. بعد هم اومده اینا رو از منظرهای مختلف شکافته؛ مثلا گفته هر روشی چه هایپرپاارامترهای موثری داره یا هر یک از روشها چه کاربردهایی داره.
و یه حرکت تمیز دیگهای زده و تایملاین مقالات این زمینه رو درست کرده تا بدونید به چه ترتیبی باید بخونید.
خلاصه که زبونبستهها هر چه در توان داشتند مایه گذاشتند و یه مقاله خیلی کامل درست کردند؛ پس بخونید و لذت ببرید.
لینک مقاله:
https://arxiv.org/abs/2110.01852
پ.ن.۱. پنج تا تصاویر ضمیمه شده. ورق بزنید. اگر همه رو نمیبینید، اینجا قرار داده شدند.
پ.ن.۲. اگر کلا نمیدونید داستان چیه، این پست [https://t.me/nlp_stuff/71] رو بخونید.
#read
#paper
@nlp_stuff
Post #234
2.09K