مدلهای زبانی یا موتورهای محاسبه؟
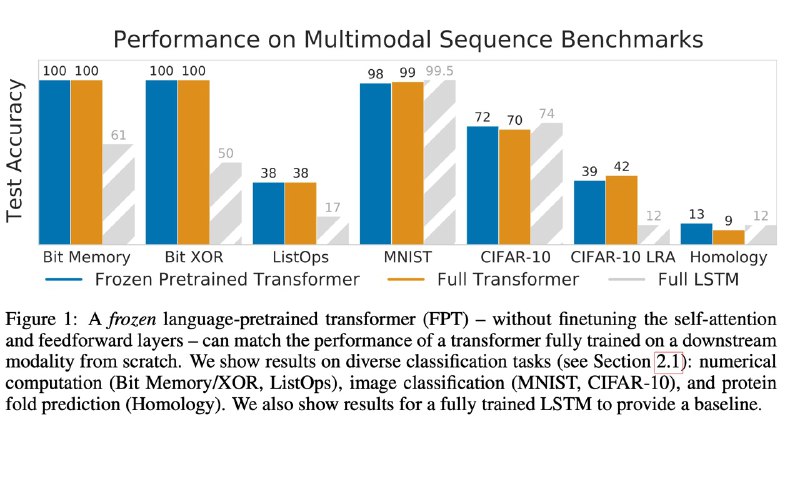
معماری داخلی شبکههای ترنسفورمری را میتوان به سه بخش لایههای امبدینگ، لایههای ترنسفورمری (اتنشن) و لایه خروجی تفکیک کرد. حالا در این مقاله جدید به نام Pretrained Transformers as Universal Computation Engines اومدند و قابلیت تعمیم پذیری شبکههای ازپیشآموزشدیده زبانی روی تسکهای سایر مودالیتیها نظیر تسکهای تصویری (مثل دستهبندی روی cifar) و ریاضی (مثل حساب کردن یک عبارت) تست کردند. چگونه؟ به این نحو که قلب شبکه رو (همون بخشهای اتنشن میانی) فریز کردند و باقی بخشهای مدل رو که صرفا یک درصد از پارامترهای کل مدل هستند، روی تسک هدف فاین تیون کردند و بعد عملکرد این مدلها رو با حالتی که شبکه ترنسفورمری از ابتدا و به صورت خام روی این تسکها آموزش ببینه مقایسه کردند.
نتایج نسبتا جالب توجه هستند، به این صورت که مدلهای فاینتیونشده از مدلهای دسته دوم پا پس نکشیدند و حتی در برخی تسکها به امتیازهای بهتری دست پیدا کردند.
چند آزمایش جالب دیگه انجام دادند؛ مثلا یه بار اون اتنشنهای وسط رو رندوم عدد دادند، فریز کردند و ترین کردند و بعد دیدند جواب بد شده. یا یه بار دیگه جای پیشآموزش روی متن روی تصویر پیشآموزش دادند و دیدند باز هم متن بهتر بوده.
همین نتایج این حدس رو برمیانگیزه که احتمالا مدلهای از ازپیشآموزشدیده زبانی در قسمت لایههای اتنشن خودشون، منطق محاسباتی رو یاد میگیرند که همین بهشون در تسکهای دیگه کمک میکنه و بر همین اساس نام مقاله اینی شده که مشاهده میکنید.
لینک ویدیوی توضیح مقاله:
https://www.youtube.com/watch?v=Elxn8rS88bI&t=1080s
لینک مقاله:
https://arxiv.org/abs/2103.05247
#read
#paper
#watch
@nlp_stuff
Post #148
1.34K