
Claude Sonnet 3.7 вышла и затмила собой все последние релизы
Antropic наконец-то выпустили свою новую модель. Вопреки ожиданиям, она получил номер версии не 4.0, а 3.7.
Claude - это тот редкий случай, когда я иду тестировать новые модели сразу. И главная тому причина - природа компании. Я уже писал, что ребята делают огромную кучу исследований, которые я регулярно использую для самообразования. Компания максимально ответственно подходит к разработке мощного, но при этом этичного ИИ.
Так что же такого в Claude, что это вызвало у меня такое восхищение и кликбейтный заголовок?
Во-первых, Anthropic использовали революционный подход к разработке reasoning (в простонародье “думающих”) моделей. Если у Open AI, Gemini и Deepseek для размышлений используется отдельная модель для этого, то в случае Claude разработчики приводят аналогию с человеческим мозгом, говоря о том, что и для размышлений и для быстрых ответов у нас мозг один. По-сути данный подход аналогичен стратегии промпт-инжиниринга “self-evaluating prompting”. В нем мы даем модели больше времени на конструирование ответа и проверку себя. Также использование одной модели просто удобнее для конечного пользователя. Я уже протестировал Reasoning-режим для генерации планов питания и каллории здесь считаются точнее, чем у конкурентов. А вот с задачкой из поста выше модель не справилась и выдала 17 :) А еще, Claude не скрывает своих “мыслей”. Привет OpenAI с их черными ящиками в моделях o1 и o3.
Во-вторых, при разработке Reasoning-моделей компания работала не над улучшением показателей в математике и Computer Science (в чем модель на голову выше всех), а на выполнении реальных бизнес-задач и следовании инструкциям. Наконец-то этим кто-то занялся!
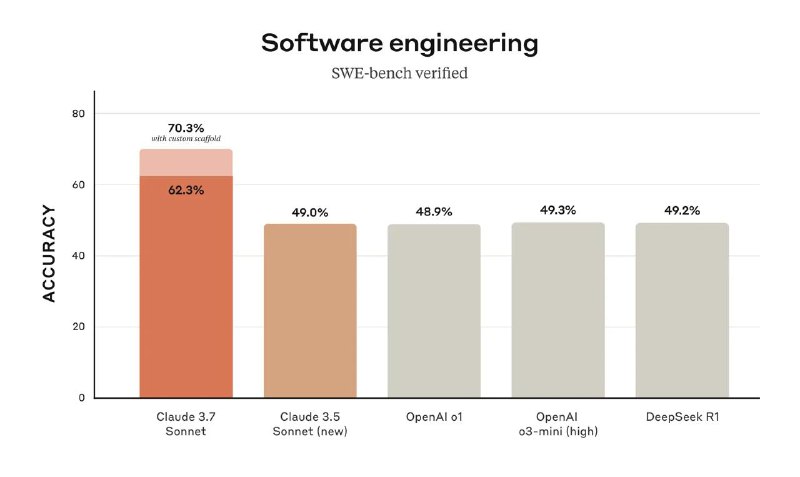
В-третьих, без того крутую производительность в задачах на программирование, прокачали еще сильнее. Прокачали также Visual Reasoning. Проще говоря, теперь с Claude проще писать код непрограммистам. Когда вы кидаете модели скриншот желаемого интерфейса она с большей точностью его воспроизведет. Все еще не замена разработчикам, но для прототипирования в инструментах вроде Bolt и Cursor - идеально. Здесь я также дал модели задачку с мячиком и она ее перевыполнила, добавив счетчики времени и ускорения мячика :)
В общем, по первым впечатлениям и метрикам - кажется, что это лучшая LLM прямо сейчас для выполнения комлексных задач. Планирую исследовать ее и дальше, как самостоятельно, так и в рамках других продуктов
P.S. про подход Antropic к Reasoning-моделям они написали в своей статье
#новости
Post #159
477


- ❤ 6
- 👍 3