TGViewer
Channel Public Channel
🟡NeuroGraph

🟡NeuroGraph

@neyr0graph

Сотрудничество, консультации, обучение: @deebreath

| Midjournеу | Seedance | VEO | Нано Банана| Искусственный интеллект | AI | Генерация фото | Kling AI| Генерация видео | Nano Banana| ИИ | Сгенерировать фото | Krea A
Subscribers
34.4K
Photos
2.6K
Videos
1.3K
Links
1.3K

Showing posts older than #4670 · Back to latest

Older Posts 14 shown
Post #4669 7.52K
НОВОЕ ВИДЕО на моем YouTube канале!

Заранее признателен за ваши лайки, комменты и подписки.

Для вас подарок ниже.

Показываю весь путь проекта: от истории, референсов и таблицы планов до микробитов, точных промптов, генерации, отбора материала и монтажа.

Отдельно разбираю сцену аварии, работу разных крупностей, ошибки модели и объясняю, почему хороший результат почти никогда не собирается из одной генерации.

И подарок для всех: обновлённый skill для создания промптов под Seedance 2.5. Все основные принципы его использования я объясняю в видео.

Skill доступен бесплатно на моём Boosty

Смотрите видео и забирайте инструмент.

Смотреть ЗДЕСЬ
  • 🔥 37
  • ❤‍🔥 7
  • ❤ 5
  • 🤝 5
  • 🤗 1
Post #4667 7.32K
COMFYUI ПОКАЗАЛА WORKFLOW С РАЗДЕЛЬНЫМ КОНТРОЛЕМ ДВИЖЕНИЯ И КАМЕРЫ

ComfyUI - это node-based редактор, в котором можно собирать сложные AI-процессы из отдельных блоков.

Новый workflow соединяет SAM 3D Body, Blender и Seedance 2.5, чтобы отдельно управлять актерским движением, камерой и финальным визуальным стилем.

SAM 3D Body - open-source модель Meta.

Она восстанавливает трехмерную форму и позу человеческого тела по обычному изображению.

В этом процессе ее используют для переноса движения из реальной видеозаписи в 3D-сцену.

ЦЕПОЧКА РАБОТАЕТ ТАК:

• Сначала человек записывает нужное движение на обычную камеру.

• SAM 3D Body переносит положение и движение тела на трехмерную модель.

• Полученная анимация открывается в Blender. Там можно изменить положение виртуальной камеры, ракурс, объектив и траекторию движения независимо от актера.

• Подготовленный результат передается в Seedance 2.5, которая превращает техническую 3D-заготовку в финальную кинематографическую сцену.

Я внимательно посмотрел демонстрацию. Самый важный момент здесь не в генерации, а в разделении контроля.

Движение актера задается реальной записью.

Камера режиссируется отдельно в Blender.

Внешность, окружение и финальный стиль формирует видеомодель.

Это уже больше похоже на нормальный производственный процесс.

Можно сначала поставить мизансцену и камеру, проверить тайминг, а только потом тратить генерации на финальное качество.

Текстовый промпт перестает быть единственным способом управления сценой.

СТОИМОСТЬ

Локальные ComfyUI и SAM 3D Body можно использовать бесплатно на своем компьютере.

Понадобится мощная видеокарта время и знания для настройки.

В Comfy Cloud активная работа GPU тарифицируется по 0,266 кредита в секунду.

Это примерно 16 кредитов за минуту, около $0,08 или 7 рублей. Итог зависит от продолжительности работы workflow.

Запуск Seedance 2.5 оплачивается отдельно как partner node.

Точная стоимость показывается перед генерацией и зависит от длительности видео, разрешения, выбранного режима и количества входных материалов.

Готовые workflow:

SAM 3D Body
https://cloud.comfy.org/?template=utility_sam3d_body

Seedance 2.5
https://cloud.comfy.org/?share=a51863b6a761

На мой взгляд, это один из самых полезных сценариев соединения open-source 3D-инструментов и видеомоделей.

Особенно для сцен, где важны точная пластика персонажа, сложный ракурс и управляемое движение камеры.
  • 🔥 43
  • ❤ 16
  • 👀 3
  • 💔 2
Post #4666 6.11K
H3 Max Live запускает бесконечное видео быстрее реального времени.

H3 Max - ускоренная видеомодель на базе MiniMax H3.

Она создает ролики в 768p по тексту или изображению, поддерживает нативный звук и генерирует короткий клип быстрее его длительности.

Теперь показали H3 Max Live.

Это экспериментальный режим, в котором генерация не заканчивается после одного клипа.

Система продолжает трансляцию на лету, сохраняет связь между сценами и меняет происходящее по командам из чата.

Что показали:

• видео генерируется быстрее реального времени;

• поток может продолжаться без заданного финала;

• модель не сбрасывает контекст после каждого фрагмента;

• команда !prompt меняет сцену за несколько секунд;

• API для Live обещают открыть на следующей неделе.

Я бы пока воспринимал это как технологический превью, а не готовый рабочий инструмент.

Главное здесь не просто скорость.

Модель переходит от генерации отдельных роликов к управляемой генеративной трансляции, которую можно режиссировать прямо во время показа.

Сам Live-режим пока недоступен для обычного запуска. Но стандартная H3 Max уже работает в Weavy AI в двух вариантах.

Текст в видео: скопируйте ЭТУ ссылку и вставьте ее в рабочее пространство Weavy AI.

Изображение в видео: скопируйте ЭТУ ссылку и вставьте ее в рабочее пространство Weavy AI.

У тех, кто работает в Weavy AI , как всегда есть ранний доступ к новым моделям и низкие цены.

На момент моей проверки запуск H3 Max в 768p стоит 10 кредитов, примерно $0,08-0,10 или 7-9 ₽.

Точная сумма в деньгах зависит от тарифа, а стоимость в кредитах видна в узле до запуска.

Для проверенных длительностей 5, 10 и 15 секунд интерфейс показывал одинаковые 10 кредитов.

Цена Live пока не объявлена.

Я думаю, если разработчики удержат непрерывность хотя бы на нескольких минутах без заметного распада персонажей и среды, это уже будет новый формат для интерактивных эфиров, превизов и живой AI-режиссуры.
  • 🔥 32
  • ❤‍🔥 11
  • ❤ 10
  • 🎉 2
Post #4665 6.48K
ЦВЕТОВОЕ РЕШЕНИЕ ДЛЯ ГЕНЕРАТИВНОГО КИНО

Завтра, в воскресенье 30 августа, в 18:00.

Продолжительность 2 часа. Семинар для подписчиков Boosty.

Грейдинг в кино обязателен. Но колорист не придумывает цвет фильма, он доводит решение, принятое до съёмки: цветовой сценарий на препродакшене, ограниченная палитра в декорациях и костюме, свет и фильтрация в камере.

И работает он с материалом, который это выдерживает: RAW или log, 10 и 12 бит, с запасом в тенях и светах.

В генеративной работе площадки нет, весь этот слой переезжает в промпт и референс.

А на выходе модель отдаёт 8 бит на канал в sRGB, без RAW и без log. Это 256 уровней на канал и уже свёрнутая цветовая информация.

Отсюда практический вывод. Тянуть такой файл кривыми почти некуда: тональные переходы рвутся, в тенях лезут бандинг и шум, телесные уходят в сторону.

Перегон в 10 или 12 бит после генерации не спасает, потерянное при кодировании не возвращается.

Поэтому цвет закладывается на входе, а коррекция после только подчищает.

ЧТО ВНУТРИ

☆ Пять базовых цветовых схем. Где каждая сложилась, кто ввёл её в практику, как она влияет на восприятие сцены.

☆ Разбор схем на кадрах из фильмов.

☆ Как считать палитру с референса и описать её точными параметрами: доминанта, комплементарная пара, температура, контраст, распределение цвета по планам.

☆ Как воспроизвести это описание в сгенерированном изображении.

☆ Как перенести палитру в видео референсом и удержать её промптом по всей длине ролика.

☆ Полный порядок работы: настроение сцены, цветовое решение, кадр, видео.

✓ Через 2 часа у вас будет пять рабочих схем и порядок, по которому цвет в ролике ставится решением, а не перебором генераций

Присоединяйтесь!
  • ❤ 14
  • ❤‍🔥 6
  • 🤔 1
Post #4664 6.42K
Ребята, есть кто живет во Въетнаме? Как там с погодой в декабре-январе? Есть мысли пожить в это время там.
  • ❤ 3
  • 😎 2
Post #4663 7.29K
Друзья! Всем хороших выходных! 🤘
  • 🔥 96
  • ❤ 23
  • 😎 5
Post #4662 6.58K
Подборка свежих материалов за неделю на Boosty

1. Whip-Pan в AI-видео.

Приём Whip-Pan (резкое панорамирование со смазом) нужен для бесшовного переключения внимания между объектами и смены планов в динамичных сценах - погонях, драках или хоррорах - без монтажных склеек и с сохранением единого пространства.

Я показал и рассказал, из каких элементов состоит структура этого эффекта, в каких жанрах его лучше применять, а также как правильно составить промпт для нейросетей, детально прописав причину поворота, направление, характер смаза и финальную точку фиксации камеры для сохранения эффекта единого непрерывного кадра.

2. Запись мастер-класса для подписчиков «На связи с Нейрографом» и «AI Режиссер» от 23 августа. Мизансцена и блокинг. Часть 4.

Финальная встреча посвящена полному циклу создания сложной экшен-сцены: от режиссерского планирования мизансцены и правил склеек до генерации видео в SeaDance 2.5 и чистового монтажа в DaVinci Resolve.

Вы научитесь выстраивать безупречный съемочный пайплайн с разбивкой на микробиты, грамотно обходить генеративные артефакты и профессионально собирать динамичный экшен по движению с опорой на классическую кинотеорию.

3. Ваше искусство не обязано ждать разрешения.

Почему некоторым страшно показывать работы, созданные с AI - да и вообще любые свои работы?

За этим страхом часто стоят боязнь критики, стыд, перфекционизм и сомнения в собственном авторстве.

А использование AI добавляет ещё один вопрос: «Имею ли я право называть эту работу своей?»

В новой статье разбираю, откуда берётся этот страх и как начать показывать свои работы, даже если сомнения всё ещё остаются.

4. Регулярно пополняемые коды стилей для Midjourney.
  • 🔥 9
  • ❤ 4
  • 🤝 4
  • 🤔 2
  • 🤗 2
Post #4661 6.76K
Midjourney выпустила обновление V8.2 Edit: редактирование изображений по тексту

Midjourney - сервис и семейство собственных моделей для генерации изображений.

Он особенно силен в художественной стилистике, композиции, атмосфере и работе с визуальными референсами.

Теперь Midjourney открыла массовое тестирование первой модели редактирования для V8.2.

Изображение можно загрузить в Editor и дальше описывать нужные изменения обычными словами, почти как в чате.

ЧТО УМЕЕТ V8.2 EDIT

• Редактировать изображение по текстовой инструкции.

• Использовать до четырех изображений одновременно. Этот механизм заменяет прежний omni-reference.

• Менять только выбранную область через inpainting.

• Расширять изображение за исходные границы через outpainting.

• Работать с персонализацией, moodboards и style references.

Запустить модель можно несколькими способами:

прикрепить изображения к промпту, открыть Edit в просмотрщике, загрузить картинку во вкладке Editor или использовать команду --edit с URL в Discord.

Я посмотрел первые демонстрации.

Самый интересный момент здесь не отдельное удаление объекта, а возможность вести несколько последовательных правок внутри одного редактора.

Midjourney постепенно становится не только генератором, но и средой для итеративной работы с изображением.

СТОИМОСТЬ

Отдельная цена за один запуск V8.2 Edit не опубликована.

Модель работает внутри подписки Midjourney и расходует доступное GPU-время.

Минимальная подписка стоит $10 в месяц, это примерно 860 ₽. В нее входит 200 минут Fast GPU Time.

Сколько именно минут спишет конкретная правка, заранее не фиксируется: расход зависит от числа запусков, вариантов и повторных изменений.

Пока это первая тестовая версия.

Сама команда предупреждает, что сложные случаи еще могут работать нестабильно.

Поэтому я бы уже пробовал ее для поиска вариантов.

Официальный анонс:
https://updates.midjourney.com/edit-model-for-v8/

Тарифы:
https://docs.midjourney.com/hc/en-us/articles/27870484040333-Comparing-Midjourney-Plans
  • 🔥 12
  • ❤ 9
  • 🎉 1
Post #4660 5.98K
Google выпустила обновление Gemini Omni 1.1 Flash: продление видео и 4K

Gemini Omni Flash - видеомодель Google для генерации и редактирования роликов по тексту, изображениям и исходному видео.

Ее главная особенность в том, что модель можно последовательно просить изменить сцену обычными словами, сохраняя нужные элементы.

Теперь вышла стабильная версия Gemini Omni 1.1 Flash. Это уже не preview, а GA-релиз для Gemini API и Google AI Studio.

ЧТО ДОБАВИЛИ

• Продление готового видео. Модель генерирует продолжение сцены блоками по 10 секунд, общая длительность может доходить до 40 секунд.

• Первый и последний кадр. Можно загрузить две картинки и построить управляемый переход между ними.

• Разрешение 360p, 720p, 1080p и 4K. Важно: 1080p и 4K получаются через апскейл, это не нативная генерация в таком разрешении.

• Генерация из текста и изображения, reference-to-video, редактирование и extension в одной модели.

• Нативный звук и ролики длительностью от 3 до 10 секунд за одну генерацию.

Для меня самое важное здесь не 4K. Гораздо полезнее возможность продолжить сцену и задать первый и последний кадр.

Это уже похоже на управляемую работу с эпизодом, а не на бесконечное получение случайных восьмисекундных дублей.

СТОИМОСТЬ

Google пока не опубликовала отдельный тариф именно для стабильной Gemini Omni 1.1 Flash.

Для предыдущей preview-версии официальный ориентир составлял около $0,10 за секунду видео в 720p.

По этому ориентиру:

• 5 секунд: около $0,50, или 43 ₽
• 10 секунд: около $1, или 86 ₽

Это именно ориентир, а не подтвержденная цена нового GA-endpoint.

Отдельные цены для 360p, 1080p и 4K на официальной странице пока не указаны, поэтому придумывать их я не буду.

На мой взгляд, обновление действительно сильное.

Но финальный вывод о стабильности extension и сохранении персонажей я бы делал только после серии собственных тестов, особенно на длинных сценах.

Официальная документация:
https://ai.google.dev/gemini-api/docs/omni
https://ai.google.dev/gemini-api/docs/changelog
  • 🔥 28
  • ❤ 20
Post #4659 5.71K
Google выпустила Gemini 3.5 Transcribe: умная расшифровка речи в 85+ языках

Gemini 3.5 Transcribe - новая специализированная модель Google для перевода речи из аудио в текст.

Она подходит для интервью, подкастов, звонков, лекций, субтитров и живой расшифровки в реальном времени.

Google выпустила две версии:

• gemini-3.5-transcribe для готовых аудиофайлов

• gemini-3.5-transcribe-live для потоковой расшифровки через WebSocket

Что умеет модель:

• автоматически определяет речь в 85+ языках и их региональных вариантах

• понимает переключение между языками внутри одной фразы

• разделяет реплики до 8 спикеров, но распознавание трех и более пока считается экспериментальным

• ставит временные метки вплоть до отдельных слов

• принимает словарь до 1000 терминов, имен и названий; Google советует ограничиваться примерно 100 самыми важными

• поддерживает режим verbatim с дословной записью и режим smart с удалением слов-паразитов, повторов и самокоррекций

Есть важное ограничение. Smart-режим нельзя одновременно использовать с разделением спикеров и временными метками.

Обычный запрос принимает до часа аудио, а с диаризацией или метками лимит снижается до 30 минут.

Цена зависит от длительности записи и выбранного режима:

Записанное аудио, примерно $0,005 за минуту:

• 10 минут: $0,05, около 4 рублей
• 30 минут: $0,15, около 13 рублей
• 60 минут: $0,30, около 25 рублей

Live-расшифровка, примерно $0,009 за минуту:

• 10 минут: $0,09, около 8 рублей
• 30 минут: $0,27, около 23 рублей
• 60 минут: $0,54, около 46 рублей

Бесплатный уровень тоже есть.

Платная цена складывается из обработки входящего аудио и генерации текстового результата.

Я думаю, самое полезное здесь сочетание низкой цены, словаря терминов и двух режимов выдачи.

Для интервью я бы выбирал verbatim с разделением спикеров, а для публикации конспекта использовал smart, чтобы сразу получить более чистый текст.
  • 🔥 24
  • ❤ 11
  • 🤔 5
  • 🥰 3
  • 👀 3
Post #4657 6.37K
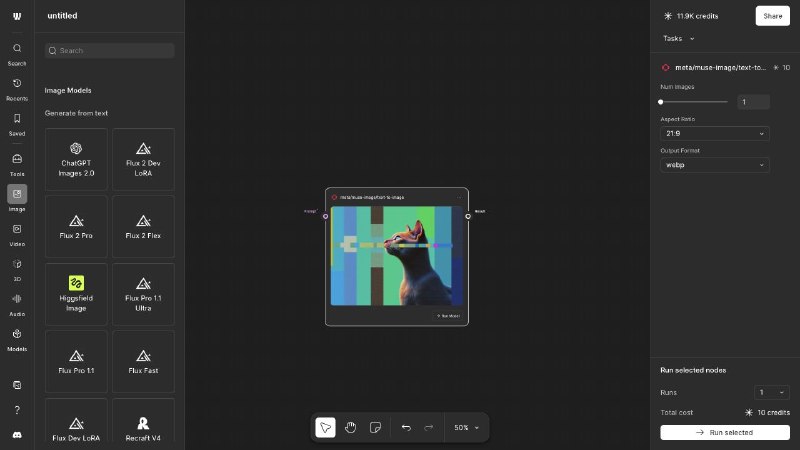
Meta Muse Image стала доступна в Weavy AI: генерация и точное редактирование

Meta Muse Image - первая модель генерации изображений от Meta Superintelligence Labs.

Она создает изображения по тексту, редактирует готовые кадры и собирает одну сцену из нескольких референсов.

Главное отличие от обычных генераторов в том, что Muse Image работает как агент.

Модель сначала планирует композицию, может использовать поиск и код, оценивает промежуточный результат и сама исправляет ошибки до финальной выдачи.

Что умеет модель:

• генерация изображений по текстовому описанию

• точечное редактирование без полной пересборки кадра

• композиция из нескольких референсов: люди, предметы, одежда, стиль и окружение

• последовательные правки в несколько шагов

• самостоятельное уточнение результата

• работа с текстом, диаграммами и QR-кодами внутри изображения

У тех, кто работает в Weavy AI, как всегда есть ранний доступ к новым моделям и низкие цены.

Чтобы добавить Muse Image на борд, вставьте ЭТУ ссылку для генерации или ЭТУ для редактирования. После вставки в Weavy откроется отдельный узел модели.

Я проверил оба узла в Weavy.

В конфигурации с одним результатом цена одинаковая:

• генерация: 10 кредитов за запуск
• редактирование: 10 кредитов за запуск

В деньгах это примерно $0,08-0,10, или около 7-8 рублей за один запуск.

Пять запусков обойдутся в 50 кредитов, десять запусков в 100 кредитов.

Итоговая стоимость формируется прежде всего количеством запусков.

По описанию и официальным примерам самое интересное здесь не просто качество картинки, а способность модели удерживать сложный бриф и самостоятельно доводить композицию.

Я бы в первую очередь проверял ее на постерах, инфографике, точных правках и сборке сцены из нескольких референсов.
  • 🔥 20
  • ❤ 6
  • 🤔 3
Post #4656 4.95K
RECRAFT V4: ОБНОВЛЕНИЕ МОДЕЛЕЙ С ПЕРЕНОСОМ СТИЛЯ ПО РЕФЕРЕНСАМ

Recraft - это не просто AI-сервис для создания графики.

Это полноценная дизайн-платформа и разработчик собственной линейки генеративных моделей Recraft.

Они специализируются на профессиональной графике: композиции, типографике, растровых изображениях и редактируемых SVG-векторах.

В Recraft Studio также доступны модели других разработчиков.

У собственных моделей Recraft V4 появилось обновление Styles.

Теперь они умеют собирать пользовательский визуальный стиль по референсам и повторно использовать его в серии генераций.

Это нужно, когда изображения должны выглядеть как части одной системы, а не как случайные результаты одной модели.

Модель принимает от 1 до 10 референсов.

Я вижу здесь два полезных режима совпадения:

• Precise старается максимально точно удерживать стиль исходных изображений

• Flexible сохраняет визуальное направление, но оставляет модели больше свободы

Созданный стиль можно сохранить как Style ID и повторно использовать в следующих генерациях.

Поддерживаются обычные изображения и полноценные SVG-векторы, а также режимы Standard и Pro.

У тех, кто работает в Weavy AI, как всегда есть ранний доступ к новым моделям и низкие цены.

Чтобы добавить Recraft V4 Styles на борд и создать растровое изображение по референсам, скопируйте ЭТУ ссылку и вставьте ее в рабочее пространство Weavy AI .

Уже внутри Weavy AI автоматически появится готовый узел модели.

Для SVG скопируйте отдельную ссылку для векторного узла.

СТОИМОСТЬ В WEAVY AI

Я проверил все шесть новых узлов Recraft V4 Styles.

На момент проверки каждый показывает 10 кредитов за один запуск, включая Standard, Pro, raster, vector и создание Style ID.

Если передать референсы непосредственно в узел генерации, один результат стоит 10 кредитов.

Если сначала создать и сохранить Style ID, первый цикл обойдется в 20 кредитов: 10 за создание стиля и 10 за генерацию.

Каждое следующее изображение с готовым Style ID стоит еще 10 кредитов.

В деньгах 10 кредитов составляют примерно $0,08-0,10, то есть около 7-8 рублей по сегодняшнему курсу.

Первый цикл с отдельным созданием Style ID стоит примерно $0,17-0,20, или около 14-17 рублей.

Главное здесь не просто перенос цвета или общей атмосферы.

Я бы использовал обновление для серийных задач:

один раз собрал визуальный язык проекта, сохранил его и дальше выпускаю в одной стилистике иллюстрации, постеры, элементы интерфейса и векторную графику.

Для одиночной генерации отдельный Style ID мне кажется лишним, а для кампании или постоянного бренда это уже полезный рабочий инструмент.
  • ❤ 20
  • 🔥 18
  • 🎉 5
  • 🤔 3
Post #4652 7.02K
Код стиля для Midjourney

--chaos 10 --ar 2:3 --exp 25 --sref 3132806997::3 1452889217::3 185162328::2 1887555320 --raw --stylize 120 --hd --profile vkh6bgf 3cbss4y lt7etf6

Постоянно пополняемая коллекци кодов для MJ на Boosty
  • ⚡ 19
  • 🔥 17
  • ❤ 5
  • 🤯 3
  • 👌 3
  • ❤‍🔥 1
  • 🤔 1
Post #4650 5.73K
Vidu обновила Q3 Mix: точный липсинк, голосовые референсы и длинные сцены

Vidu Q3 Mix - модель генерации видео по референсам.

Важное уточнение: сама Q3 Mix существовала и раньше.

Сейчас Vidu представила крупное обновление модели и заявляет, что переработала четыре ключевых направления.

ЧТО ОБНОВИЛИ

• Покадровый липсинк и использование голоса как референса.

• Сцены до 15 секунд одним непрерывным дублем с полноценными движениями камеры.

• Более жёсткая фиксация внешности персонажа между планами и более чистый звук.

• Микромимика, переходы между эмоциями и более точное выполнение сложных промптов.

Модель работает в режиме reference-to-video.

В официальный API можно передать от 1 до 7 изображений одного или нескольких персонажей, описать сцену и получить ролик с синхронно созданным звуком.

Доступны 720p и 1080p, максимальная длительность в документации API составляет 16 секунд.

Главное здесь не отдельная красивая генерация, а возможность собирать более длинную сцену с актёрским действием.

Персонаж должен не просто сохранять лицо, а двигаться, менять эмоцию, говорить и оставаться узнаваемым при смене ракурса.

То есть речь уже идет о микро-мимике и актерской игре.

СТОИМОСТЬ ЧЕРЕЗ ОФИЦИАЛЬНЫЙ API VIDU

Цена зависит от длительности и разрешения:

• 720p: 24 кредита или $0,12 за секунду
• 1080p: 29 кредитов или $0,145 за секунду

Примерный расчёт:

• 5 секунд: $0,60 / 51 ₽ в 720p; $0,73 / 61 ₽ в 1080p
• 10 секунд: $1,20 / 101 ₽; $1,45 / 122 ₽
• 15 секунд: $1,80 / 152 ₽; $2,18 / 184 ₽
• 16 секунд: $1,92 / 162 ₽; $2,32 / 196 ₽

Расчёт в рублях сделан по курсу 84,4635 ₽ за доллар.

Off-peak режим для Q3 Mix пока не поддерживается.

У Vidu получается интересная ставка: не максимальное количество входных материалов, а более управляемая игра персонажа внутри одного законченного кадра.

Если липсинк, голос и микромимика действительно будут стабильно работать вместе, модель может быть полезна для коротких диалоговых сцен, рекламы и сериализованного контента.

Официальная документация:
https://platform.vidu.com/docs/reference-to-video
https://platform.vidu.com/docs/pricing
  • 🔥 26
  • 👌 7
  • ❤ 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →