Когда прикручиваешь к ИИ-агенту интернет, внезапно выясняется, что "дать ему погуглить" это вообще не одно действие.
Сначала поиск. Потом надо сходить на найденные страницы, вытащить из них текст, выкинуть HTML-мусор, порезать всё на логические куски, выбрать наиболее подходящие и только потом скормить модели. Причём если просто пихать ей страницы целиком, контекст начинает жрать токены как не в себя.
В Yandex Search API для этого запустили Smart Snippets.
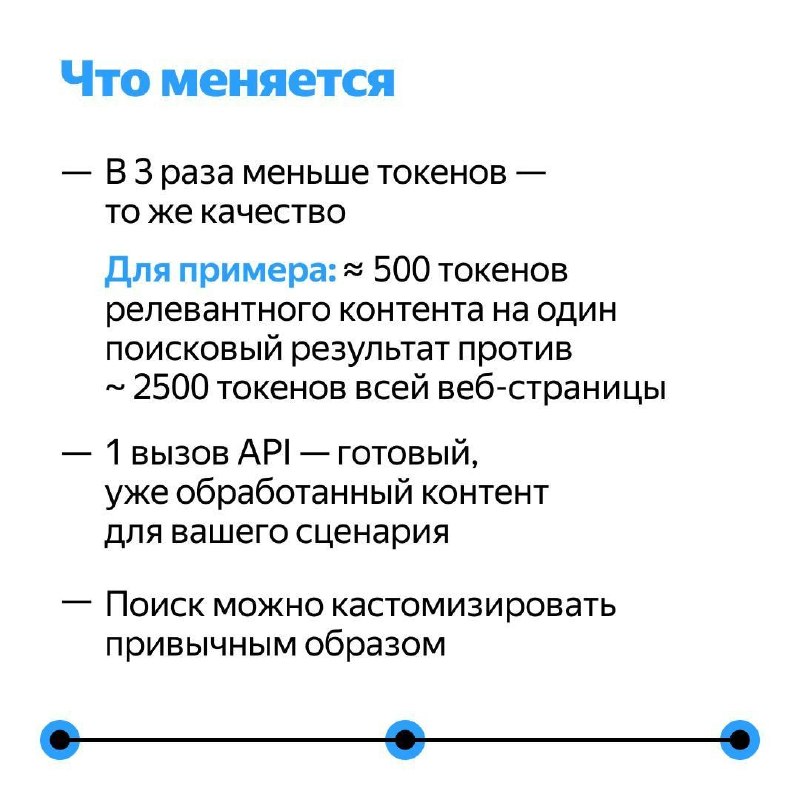
Суть проста: вместо целой веб-страницы API возвращает нужные под конкретный запрос фрагменты (примерно по 500 токенов каждый). Плюс цитаты и ссылки на источники. Поиск и подготовка такого контекста происходят за один вызов API.
Важно: это не ещё одна нейронка, которая сама сочиняет финальный ответ. Smart Snippets только находят и отбирают нужное из каждой страницы, а дальше эти куски уже получает ваша LLM.
По данным Yandex Cloud, такой подход позволяет тратить на веб-контекст до 3 раз меньше токенов при том же качестве ответа. А значит, если у вас агент постоянно лазит в интернет, меньше становится не только контекст, но и счёт за использование модели.
Короче, поиск и уже готовый под LLM контекст в одном вызове — вместо того, чтобы сначала искать, откуда вообще брать выдачу, а потом городить вокруг неё обвязку.
Свяжитесь с экспертом, чтобы протестировать
Post #7777
5.83K