
Пока кипит работа по финализированнию наших тестов и выявлению лучшей архитектуры агента для небольших и недорогих моделей
Хочу с вами поделится очень крутыми новостями!
Бенчмарк и новые фичи!
Что было сделано:
1) Был добавлен MCP как клиент (теперь вы можете подключить любой набор тулов внутрь агента)
2) Проработаны и оптимизированы промпты для читаемости и понимания LLM
<MAIN_TASK_GUIDELINES>
<DATE_GUIDELINES>
<CORE_PRINCIPLES>
<REASONING_GUIDELINES>
3) Проработаны докстринги у каждого тула
Осмысленные и протестированы description
4) Использован гибридный подход: агент строится на концепции SGR и подходах ReAct+PlanAct, также был применён чистый Function Calling (со схемой решения можно ознакомиться в комментариях под постом)
5) Я разнес тул вэб поиска на /search и /extract
5) Я лично провел огромное кол-во экспериментов по созданию разных tool_kit для проверки агента
Самое важное этот агент sgr_tools_agent.py мой личный фаворит для использования моделей по типу
gpt-4o-mini
gpt-4.1-mini
И схожих им по размеру (как говорит интернет это что-то в районе 40-80b)
Сначала мы занялись поиском бенчмарка, на котором можно протестировать SGR Deep Research
Выбирали из: BESPOKE, FRAMES, MS MARCO, SimpleQA, SealQA
Остановились на SimpleQA так как хотелось проверить возможности агента на поиск фактов!
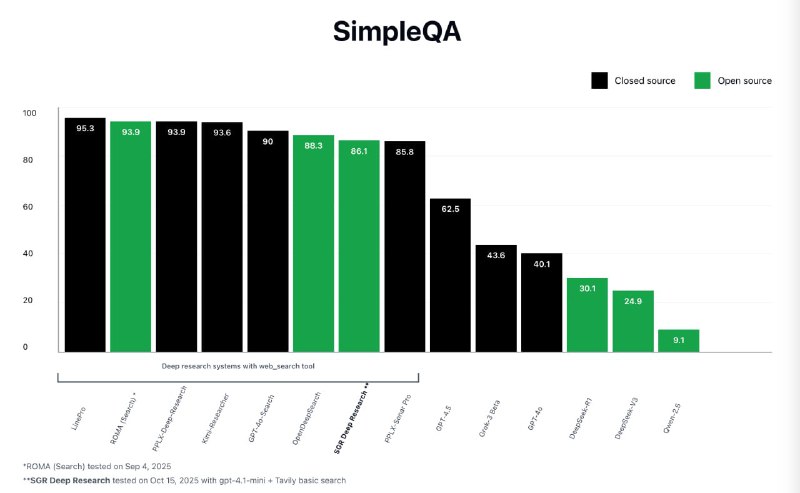
Нашим ориентиром стал лидерборд из репозитория фреймворка ROMA, в нем приведено сравнение точности различных LLM на SimpleQA, встроенных в поисковый движок
Тестовый прогон на SimpleQA Verified
Перед запуском на SimpleQA (4326 вопросов/ответов)
решили провести тестирование на урезанной версии SimpleQA Verified (1000 вопросов/ответов).
Для оценки правильности ответов мы использовали подход LLM-as-a-judge, где в качестве судьи выбрали gpt-4o
Для старта в качестве агента для SGR Deep Research взяли sgr_auto_tool_calling_agent.py,
Точность оценивали у двух LLM: gpt-4.1-mini и gpt-4o-mini.
Результат на SimpleQA Verified получили следующий:
gpt-4.1-mini → Accuracy: 0.792
gpt-4o-mini → Accuracy: 0.705
Вывод: gpt-4.1-mini оказался точнее
А режим auto мешал агенту и превращал его в чатбота, такое нам не надо
С ним идем на полный SimpleQA но убираем режим auto у тулов и переключаемся в required sgr_tools_agent.py.
Оценка SGR Deep Research на SimpleQA
В качестве LLM выбрали gpt-4.1-mini, а в качестве агента - sgr_tool_calling_agent.
Произвели все изменения что я описал выше учитывая незначительные дополнительные правила и указания
(фититься под бенчмарк не хотелось бы как ROMA)
Результат бенчмарка получили следующий:
gpt-4.1-mini → Accuracy: 0.861
Таким образом, опираясь на лидерборд из ROMA, мы смогли занять 7 место среди общего списка, а также 3 МЕСТО среди open-source решений на недорогой модели и самом базовом поиске от Tavily!
Если быть честными на gpt-4.1-mini это первое место так как был использован Tavily Basic (с ограничением на экстракт в 33к символов, что сильно экономит токены)
Более подробное описание параметров запуска, а также результатов тестирования мы выложили репозиторий
Тут есть все
Коды запуска
Коды от Зиона =)
LLM-as-a-judge
Таблица с ответами
Кстати мы не поленились и собрали полный лог каждого прогона можно посмотреть тут
Так что теперь можете не только брать данное решение как лишенное готовых агентных фреймворков,
так и доказать перед командой точность результатами бенчмарка!
Отдельное спасибо нашей open-source команде которая смогла реализовать это:
Ревью кода - Артём
Координирование - я
Подготовка данных и реализация логики тестирования: Максим
Паша наш MCP гуру
Ринат собирает кейсы, и распространяет проект на EN уровне!
Цифры:
232 млн токенов
8к запросов на /search
1200 запросов на /extract
Полный тест такого бенчмарка обошелся в $170
Далее мы планируем оценить работу агента уже на локальных LLM
Репо: https://github.com/vamplabAI/sgr-deep-research
P.S замену tool calling не нужно делать!
Но если очень хочется можно
Мы всех слышим и умеем читать пейперы =)