TGViewer
Channel Public Channel
Модель предскажет

Модель предскажет

@modprod

Канал от практиков в Data Science для тех, кто хочет доводить свои модели до продакшена.

Ведёт команда Симулейтив: @simulative_official
Subscribers
390
Photos
42
Videos
1
Links
43

Showing posts older than #55 · Back to latest

Older Posts 15 shown
Post #54 397
Лучший совет для начинающих — начните 😄 Но с чего начать, когда вокруг столько информации?

Привет! На связи Мария Жарова, ментор курсов «ML-инженер» и «Дата-сайентист» 👋🏻

Хоть Data Science и относительно молодое направление, по нему уже успело накопиться ооочень много ресурсов и литературы. Собрала для вас 3 книги, которые хорошо подойдут на старте — без перегруза и с понятной логикой роста.

📕 Луис Серра «Грокаем машинное обучение»

Это одна из самых дружелюбных книг для входа в тему: здесь нет ощущения, что тебя сразу бросили в линейную алгебру или матанализ и сказали «разбирайся». В книге огромное множество интуитивных объяснений, которые отвечают на большую часть вопросов:

➖ Что такое модель и почему она «учится»;
➖ Что значит ошибка и качество;
➖ Зачем делить данные на train/test;
➖ И почему модели иногда «переучиваются».

Издание довольно новое (2024 года), и закрывает весь стек классического ML.

📖 Ссылка на PDF


📗 Джейк ВандерПлас «Python для сложных задач»

Это отличное практическое дополнение к теории. Несмотря на устрашающее название, в книге понятно и на примерах объясняются все базовые инструменты и библиотеки дата-сайентиста: NumPy, Pandas, визуализация и базовый ML через sklearn.

Хоть DS и считается исследовательско-математическим направлением, все идеи и алгоритмы реализуются через Python, поэтому его знание необходимо.

📖 Ссылка на PDF


📘 В. Савельев «Статистика и котики»

Если первые две книги дают понимание машинного обучения и практики, то эта очень мягко вводит в статистическое мышление. В книге удивительно просто объясняются сложные статистические явления — без перегруза и без ощущения, что ты снова на парах в университете 😄

Можно наконец-то осознать:

➖ Почему маленькие выборки могут легко вводить в заблуждение;
➖ Почему любые «примерные оценки» всегда с погрешностью и почему это нормально;
➖ И как перестать воспринимать цифры как что-то точное, а начать видеть в них неопределённость.

И всё это через простые, жизненные примеры.

📖 Ссылка на PDF


В итоге получается очень комфортная траектория:
➡️ «Грокаем» — чтобы понять основы ML;
➡️ Python ВандерПласа — чтобы начать делать руками;
➡️ «Статистика и котики» — чтобы научиться мыслить аналитически.

На такую базу можно уже «наращивать» более сложный материал.

Сохраняйте, чтобы не потерять ❤️
  • ❤ 5
  • 👍 3
  • 🔥 3
Post #53 328
Полезные инструменты и библиотеки для MLOps

Привет! На связи Мария Жарова, ментор курсов «ML-инженер» и «Дата-сайентист» 👋🏻

Когда впервые сталкиваешься с MLOps, бывает сложно понять, для чего нужно такое множество инструментов и почему production не может без них жить.

Чтобы понять важность MLOps-инструментов, давайте разберём типичный ML-пайплайн по шагам.

1️⃣ Сначала вы обучаете модель и начинаете экспериментировать: пробуете разные признаки, гиперпараметры, алгоритмы. Довольно быстро становится неудобно хранить результаты «вручную» — в блокнотах, Excel или названиях файлов вроде final_model_v2_last_really_last 😁

И как раз для этого существуют трекеры экспериментов: MLflow, Weights & Biases, ClearML! Они автоматически сохраняют параметры запуска, метрики, версии датасетов, модели, графики обучения и артефакты. Благодаря им потом можно нормально сравнивать эксперименты и наглядно видеть, почему одна версия модели сработала лучше другой.


2️⃣ Теперь представим, что ваша модель оказалась успешной, и её нужно выкатить в production — к примеру, рекомендательную систему. Что это значит? Как минимум то, что пользователи теперь должны регулярно получать актуальные рекомендации от вашей модели — а для этого её нужно регулярно перезапускать.

Если взять типичный пайплайн, то скорее всего, он будет состоять из нескольких частей: выгрузить свежие данные, подготовить датасет, обучить модель, провалидировать качество, сохранить артефакты, залить новые предсказания в базу или обновить сервис. И всё это должно происходить строго по порядку.

Делать такое руками каждый день довольно быстро становится невозможно. Особенно если пайплайнов несколько, а задач десятки…

К счастью, для этого существуют оркестраторы: Airflow, Prefect, Luigi. Они позволяют описывать ML-процессы как последовательность задач и автоматически запускать их по расписанию. Плюс они умеют отслеживать статус задач, самостоятельно перезапускать упавшие этапы, хранить логи и строить зависимости между шагами пайплайна. По сути это инструмент для автоматизации и управления сложными процессами.


3️⃣ Также при выкатке в прод почти все сталкиваются с проблемой: «локально всё работает, а на сервере внезапно нет».

Причины могут быть разные — например, другая версия Python, не та версия библиотеки, отсутствует нужный пакет, или модель вообще ведёт себя по-другому из-за окружения.

Чтобы проект запускался одинаково на любой машине, используют Docker: он позволяет упаковать приложение вместе со всеми зависимостями, библиотеками и настройками в отдельный контейнер.


Благодаря этому можно один раз собрать окружение и потом запускать его где угодно:
локально, на сервере, в облаке или у другого разработчика в команде. Концепция Docker уже давно стала стандартом для ML, да и в принципе в разработке.

4️⃣ А уже после выкатки модели обычно хочется понимать, не упал ли сервис, не начала ли модель отвечать слишком медленно, не закончилась ли память, не выросла ли нагрузка на сервер.

Для ответа на эти вопросы обычно используют связку Prometheus + Grafana. Prometheus — это система сбора метрик, она регулярно ходит в сервисы и собирает техническую информацию: нагрузку CPU, использование памяти, время ответа, количество запросов, ошибки и другие показатели. А Grafana — это инструмент для визуализации этих данных. В ней можно подключать разные источники данных и через UI собирать дашборды с графиками, таблицами и мониторингом сервисов.


5️⃣ А когда ML-систем становится много — появляются Kubernetes, feature store, CI/CD и другие инфраструктурные инструменты. Но это уже следующий уровень зрелости проекта.

Так что каждый инструмент MLOps решает вполне конкретную практическую проблему, с которой рано или поздно сталкивается любая ML-команда.

Сохраняйте, чтобы не потерять ❤️
  • ❤ 5
  • 👍 4
  • 🔥 3
Post #52 250
Модель предскажет Привет! Снова на связи Мария Жарова, ментор курсов «ML-инженер» и «Дата-сайентист» 👋🏻 Сегодня вечером снова приду на эфир — разберём, как выглядит подготовка датасетов в реальных проектах и пошагово пройдём по базовой «рутине» дата-сайентиста: 1️⃣ Дубликаты…
Мария Жарова на связи ❤️

Спешу сообщить, что запись стрима про ML-модели уже на канале! Смотрите там, где удобно:
➡️ YouTube
➡️ VK Видео

⭐️ Кстати, уже в пятницу завершается набор на обучение на курсы «ML-инженер» и «Дата-сайентист», где я выступаю ментором. Присоединяйтесь к курсу и учитесь строить эффективные ML-модели от создания до продакшена!
  • ❤ 5
  • 👍 3
  • 🔥 3
Post #50 284
Привет! Снова на связи Мария Жарова, ментор курсов «ML-инженер» и «Дата-сайентист» 👋🏻

Сегодня вечером снова приду на эфир — разберём, как выглядит подготовка датасетов в реальных проектах и пошагово пройдём по базовой «рутине» дата-сайентиста:

1️⃣ Дубликаты, пропуски, выбросы — что с ними делать на практике;
2️⃣ Подготовка признаков для модели — кодирование и масштабирование;
3️⃣ Частые ошибки — утечки данных, мультиколлинеарность, нестабильность и другие вещи, которые тихо ломают качество модели.

📆 20 мая, 18:00 МСК, онлайн
❗️ Ссылку на трансляцию пришлём за час до начала!
  • ❤ 4
  • 👍 3
  • 🔥 2
Post #49 253
Почему опытные ML-инженеры не начинают сразу с нейросетей?

Привет! На связи Мария Жарова, ментор курсов «ML-инженер» и «Дата-сайентист» 👋🏻

Один из самых полезных лайфхаков в ML, который сильно помогает в реальных проектах:

📌 Никогда не начинайте решение задачи сразу со сложной модели.


Даже если очень хочется сразу обучить трансформер, или SOTA из последней статьи, или огромный ансамбль. На практике важно всегда начинать с baseline — возможно, уже его будет достаточно для первичного решения запроса бизнеса.

Как обычно выглядит работа над новым проектом:

1️⃣ Сперва постройте максимально простую модель — например, регрессию или дерево решений. Главное — без сложных пайплайнов и многочасового тюнинга гиперпараметров.

Почему это важно? Дело в том, что baseline быстро покажет, есть ли вообще полезный сигнал в данных и насколько задача решаема. Если простейшая модель выдаёт плохой результат — это повод поискать другой датасет или обогатить имеющийся дополнительными признаками.

2️⃣ Анализируйте не только итоговую метрику, но и ошибки модели на отдельных примерах непосредственно — очень часто это помогает разгадать загадку, что происходит на самом деле. Вот несколько типичных примеров:

➖ модель ошибается только на редких объектах ⇒ вероятен дисбаланс классов;
➖ качество резко падает на новых данных ⇒ распределения в обучающих и свежих продовых данных отличаются.

А если построить график зависимости loss/метрики по итерациям обучения, можно быстрее заметить проблемы в процессе обучения:
➖ если loss «застыл» ⇒ модель почти не учится, можно попробовать поменять что-нибудь в алгоритме оптимизации;
➖ если видите сильные скачки ⇒ learning rate может быть слишком большим;
➖ ну и если loss на валидации начал расти ⇒ типичный сигнал переобучения.

3️⃣ Не тратьте время на подбор гиперпараметров без нормальной валидации. Очень частая ошибка новичков — часами подбирать их, когда проблема вообще в другом.

Обычно в задачах качество сильнее растёт от хороших признаков и очистки данных, корректной валидации, устранения мультиколлинеарности, шума и утечек данных. А вот когда эти проблемы решены, можно заняться более «косметическими» улучшениями.

4️⃣ И только когда все простейшие пути решения задачи тщательно проработаны, можно приступать к более сложным моделям.

Нейросети и сложные ансамбли действительно могут дать сильный прирост, но только если данные гарантированно качественные и определены слабые места, в которых baseline-модель не справляется.


Так что не бросайтесь сразу в SOTA и долгие эксперименты — часто бизнесу вполне хватает простой модели, если она даёт нормальное качество, быстро работает и не требует недель экспериментов ради +0.001 к метрике. В насущных задачах важна не только скорость работы модели, но и скорость её разработки тоже 😁

Ставьте ❤️, если хотите больше постов с лайфхаками!
  • 🔥 4
  • ❤ 3
  • 👍 2
Post #47 233
Привет! На связи Мария Жарова, ментор курсов «ML-инженер» и «Дата-сайентист» 👋🏻

Сегодня вечером веду вебинар о том, чем Data Science отличается от Machine и Deep Learning — через сравнение на реальной задаче.

Возьмём датасет и обучим две модели: сначала классическим алгоритмом, затем простой нейросетью. Сравним качество, разберём принцип работы и посмотрим, что окажется лучше и при каких условиях.

Что вы узнаете из вебинара?
➡️ Разберётесь, что стоит за аббревиатурами AI, ML, DL и DS и как эти роли соотносятся на практике;
➡️ Узнаете, в каких задачах хватает классического ML, а где без нейросетей не обойтись;
➡️ Увидите, как обучают модель и как оценивают её качество — на конкретном примере с кодом;
➡️ Получите представление о стеке инструментов DS, ML и DL-инженера: что нужно знать и откуда начинать.

📆 18 мая, 19:00 МСК, онлайн
❗️ Ссылку на трансляцию пришлём за час до начала!
  • 👍 9
  • ❤ 4
  • 🔥 2
Post #46 266
Привет! На связи Наталия Воронова, руководитель направления анализа данных в сфере машинного обучения в IT-компании BIV 👋🏻

Хочу разобрать кейс из практики про построение системы на базе LAM + LLM + ML. Это хороший пример того, почему «просто подключить LLM» почти никогда не работает в реальных задачах.

Задача — автоматизировать принятие решений в маркетинге. Что нужно было уметь системе: анализировать профиль клиента, учитывать поведение и историю, оценивать риск и выбирать оптимальное действие (канал / оффер / момент).

На старте была гипотеза: «давайте возьмём LLM и дадим ему всё это решать».

Что произошло? LLM действительно мог анализировать текст, обобщать информацию и генерировать рекомендации. Но решения были нестабильными, не учитывались численные ограничения и невозможно контролировать результат.

И главное — LLM не оптимизирует целевую функцию бизнеса. LLM отвечает на вопрос: «Что выглядит разумно?» А система должна отвечать: «Что максимизирует результат при ограничениях?». Это разные задачи.

Что сделали? Перешли от «одной модели» к агентной архитектуре.

Мы разделили логику на компоненты:

1️⃣ ML-блок (предиктивный слой) считает вероятности и оценки: P(response), P(churn), Expected value и риск. Это числовая основа.

2️⃣ LLM-блок (интерпретация и логика) отвечает за объяснение, работу с текстом, генерацию гипотез и гибкую логику, которую сложно зашить в код.

3️⃣ LAM / агентный слой (оркестрация) — ключевая часть системы. Он управляет последовательностью действий, вызывает нужные модели, учитывает ограничения и принимает итоговое решение. По сути, это decision engine.

Как выглядит поток?
➖ Агент получает задачу;
➖ Запрашивает ML-оценки;
➖ Передаёт контекст в LLM;
➖ Применяет бизнес-ограничения;
➖ Выбирает действие.

Почему это работает? ML даёт точные оценки, LLM даёт гибкость, агент даёт контроль. По отдельности этого недостаточно.

Если вы строите систему на LLM, задайте себе вопрос, где у вас находится контроль решения? Если ответ «внутри LLM», это почти всегда проблема.
  • ❤ 5
  • 👍 4
  • 🔥 4
Post #45 285
Какие библиотеки и фреймворки должен знать ML/DS в 2026 году?

Привет! На связи Мария Жарова, ментор курсов «ML-инженер» и «Дата-сайентист» 👋🏻

Если Вы только входите в ML/DS, очень легко попасть в ловушку: пытаться выучить «все библиотеки мира» — на практике это почти никогда не нужно. Гораздо важнее понимать, какие инструменты закрывают базовый рабочий цикл: подготовку данных, обучение моделей, эксперименты и доведение решения до продукта.

Вот список того, что в 2026 году реально стоит знать ML/DS-специалисту, чтобы уверенно решать задачи и подходить под основные требования в вакансиях 👇

💻 NumPy + SciPy

Это две библиотеки для численных вычислений и базовой статистики.

NumPy часто используется при обработке Big Data — он особенно полезен, когда данных реально много, и базовые питоновские конструкции типа циклов или встроенных списков не справляются либо работают непомерно долго.

SciPy содержит в себе больше готовых реализаций математических функций — в особенности, для статистики, тестирования гипотез и проверки распределений.

💻 Pandas, а лучше Polars!

Pandas — устоявшийся стандарт для работы с табличными данными, и до сих пор он используется в подавляющем большинстве компаний. Однако в 2026 году важно смотреть шире: к сожалению, Pandas ограничен тем, что не способен без дополнительных приёмов обрабатывать данные паралелльно + не поддерживает режим «ленивой» обработки для экономии памяти.

Поэтому в задачах, где размер таблиц исчисляется более чем десятками миллионов строк, наилучшим выбором будет библиотека Polars! Её синтаксис очень похож на Pandas, но работает она гораздо быстрее и эффективнее.

Так что на 2026 ориентир такой: уверенно знать Pandas и постепенно смотреть в сторону Polars как более производительной альтернативы.

💻 Scikit-learn

Это всё ещё главный и незаменимый must-have для классического ML. Здесь огромное количество возможностей и готовых функций для построения baseline-моделей, train/test split, кросс-валидации и оформления пайплайнов, стандартизирующих препроцессинг.
Если вы хорошо знаете scikit-learn, то уже умеете собирать половину типовых ML-решений.

💻 PyTorch

А это необходимый выбор, если работаете с нейросетями, NLP, CV или современными deep learning-задачами.

PyTorch важен не только сам по себе, но и потому, что вокруг него строится огромная экосистема: обучение, fine-tuning, кастомные модели, исследовательские эксперименты. А вот не менее известный TensorFlow для работы с нейросетями последнее время уходит на второй план.

💻 XGBoost / LightGBM / CatBoost

Это не просто «ещё один sklearn» — это очень мощный класс моделей для табличных данных. Даже в вакансиях очень часто можно видеть отдельные пункты в требованиях про знание этих библиотек.

В бизнес-задачах они часто дают отличный результат, при этом архитектурно являются бустингами — то есть не требуют много ресурсов на обучение + имеют полезные расширения для отбора признаков, поддерживают кастомные функции потерь и разноплановые задачи.

Так что если работаете с табличными данными — эти «три кита» современных бустингов всегда должны быть в арсенале.

💻 Hugging Face Transformers

Если имеете дело с LLM, NLP, CV и в принципе дообучением готовых нейросетей, без этой экосистемы в 2026-м тяжело.

HF нужна, чтобы использовать предобученные модели, быстро их дообучать на своих данных, удобно работать с готовыми токенизаторами, датасетами и не писать всё с нуля
Сегодня это одна из самых простых «дверей» в прикладной DL — в особенности, NLP и LLM.

Итог такой: в 2026 году сильный ML/DS-специалист — это не тот, кто знает сотню библиотек, а тот, кто уверенно закрывает полный цикл: данные → baseline → эксперименты → и продакшен (про него ещё поговорим!).


Сохраняйте как ориентир, чтобы не учить лишнего! И ставьте 🔥, если хотите такой же пост про инструменты production для DS.
  • 🔥 9
  • ❤ 6
  • ✍ 3
Post #39 274
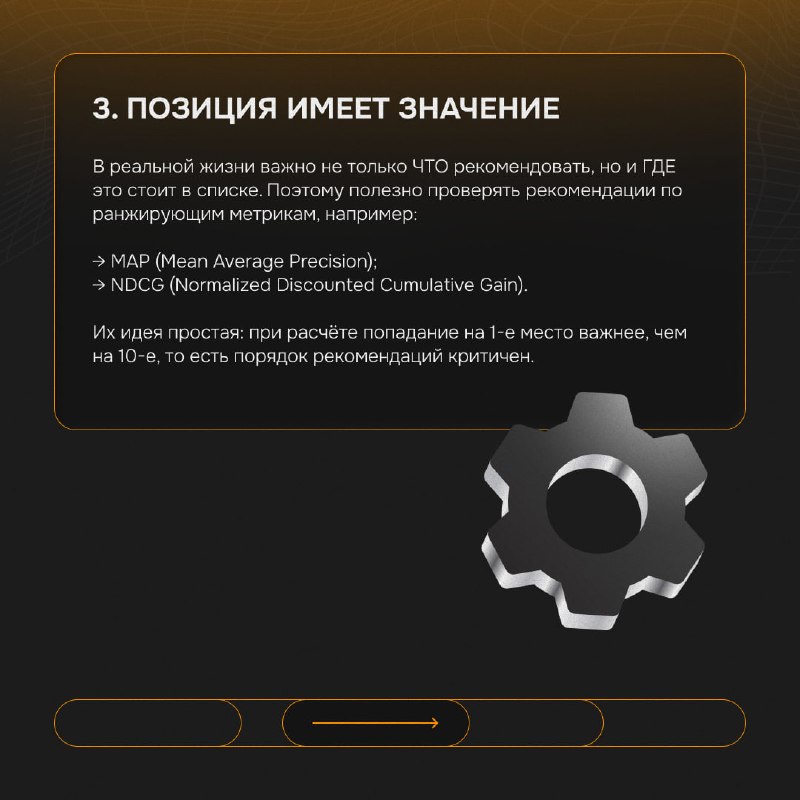
Как правильно выбрать метрику для рекомендательных систем

Привет! На связи Мария Жарова, ментор курсов «ML-инженер» и «Дата-сайентист» 👋🏻

Часто кажется, что рекомендательные системы строятся как обычный ML-пайплайн: собрать данные, обучить модели, оценить их точность, выбрать наилучшую — и всё. Но на деле при построении рекомендаций может возникнуть масса коварных проблем — к счастью, их можно попытаться отследить раньше, чем они поедут на прод, если правильно выбрать метрику!

Разберем несколько самых полезных — от простейших до более нетривиальных 👆🏻

Сохраняйте, если строите рекомендации!
  • ❤ 8
  • 👍 4
  • 🔥 4
Post #38 273
Почему diffusion-модели стали «рабочей лошадкой» для ML-инженера

Привет! На связи Кристина Желтова, директор по разработке моделей в Газпромбанке и преподаватель курса «ML-инженер» 👋🏻

Когда люди впервые слышат про генеративные diffusion-модели, обычно фокус сразу уходит в сторону сложной теории и их устройства: шум, шаги денойзинга, латентные пространства и так далее, но если посмотреть на тему со стороны инженерии, можно заметить, что подобные модели стали популярными во многом благодаря своей экосистеме и простоте использования. Если вам нужен генеративный пайплайн, необязательно погружаться в сложную математику моделей — достаточно разобраться с рабочим стеком и начать творить.

В инженерной практике почти не выигрывают технологии, которые в теории очень мощные, но не имеют хороших инженерных имплементаций — и diffusion-модели это подтверждают. На практике это означает, что не нужно каждый раз собирать всё с нуля — есть готовые предобученные модели, понятные пайплайны, модульные компоненты, которые можно менять под задачу.

Для старта своего первого проекта с генеративными моделями достаточно проделать несколько простых шагов:

1️⃣ Понять, какую задачу вы хотите решить — например, text-to-image (создать картинку по текстовому описанию), image-to-image (преобразовать существующее изображение в новое), inpainting (изменить или дорисовать только выбранную область изображения).

2️⃣ Выберите самый близкий готовый pipeline — готовый предобученный пайплайн будет разумным и простым бейзлайном. Подобрать модель под задачу можно в Hugging Face Hub, а пример для быстрого старта посмотреть здесь.

3️⃣ Соберите минимальный набор реальных примеров вашей задачи. Даже если вы начинаете с готовой предобученной модели, вам нужно хотя бы небольшое количество данных для проверки качества модели.

4️⃣ На первом этапе стоит проверить, какого качества можно добиться только настройкой промптов и параметров инференса. Если модель в целом работает, но плохо понимает ваш стиль, объект или предметную область, тогда уже есть смысл думать о дообучении.

5️⃣ Если всё-таки нужно дообучение, начните с LoRA — максимально эффективный по ресурсам и оптимальный по итоговому качеству метод. Пример с дообучением через LoRA можно посмотреть в документации.

6️⃣ После оптимизации качества можно перейти к оптимизации скорости работы и подготовке к эффективному инференсу.

7️⃣ И, наконец, для полной инженерной зрелости, к развёртыванию.

Итого, diffusion-модели сегодня не только про вау-эффект и красивые демо, но во многом про зрелую экосистему, в которой можно быстро собрать и аккуратно адаптировать решение под свои данные и быстро довести всё до прода.

Если вы хотите не просто запускать готовые пайплайны, а научиться самостоятельно строить, оптимизировать и внедрять такие решения в продакшен, приходите на курс «ML-инженер». Вместе мы пройдём полный путь инженерной работы с моделями, включая диффузионные, и вы сможете уверенно решать реальные бизнес-задачи.


🧡 Все детали и программа ждут вас по ссылке: simulative.ru/ml-engineer
  • ❤ 4
  • 🔥 4
  • 👍 2
Post #37 202
Модель стала точнее, но бизнес начал терять деньги

Привет! На связи Наталия Воронова, спикер курса «Дата-сайентист» 👋🏻

Разберу кейс, который часто выглядит как успех в ML, но заканчивается проблемами для бизнеса.

🟠 Ситуация

Задача — предсказание отклика клиентов на маркетинговую кампанию.

Мы обучили модель (градиентный бустинг), оптимизировали ROC-AUC и провалидировали. По метрикам — ROC-AUC вырос, и precision/recall лучше бейзлайна. Модель запускают в прод и используют для таргетинга.

Через несколько недель конверсия вроде норм, кампания работает, но прибыль падает. При этом модель формально лучше, отклики есть и ошибок нет.

🟠 В чём проблема

Оптимизировали не ту метрику. Модель училась предсказывать, кто с большей вероятностью откликнется, но бизнесу нужно было выяснить, кто принесёт деньги.

Модель начала выбирать пользователей, которые и так склонны к покупке, а также клиентов с низким чеком и аудиторию с высоким шансом отклика, но низкой ценностью.

В итоге мы тратили бюджет на тех, кто либо купил бы и без нас, либо приносил мало денег.

🟠 Где здесь ошибка?

ROC-AUC — это инструмент ранжирования. Но он не учитывает стоимость контакта, выручку и LTV. Модель правильная с точки зрения ML, но неправильная с точки зрения бизнеса.

🟠 Что мы сделали?

Переформулировали задачу. Вместо P (response) начали оптимизировать ожидаемую прибыль (expected profit).

Для каждого клиента считали:
Expected Profit = P(response) × Revenue − Cost,
где:
— Revenue — ожидаемый доход;
— Cost — стоимость контакта / акции.


Модель начала выбирать клиентов с более высоким чеком, сегменты с лучшим LTV и аудиторию, где есть реальный uplift.

Результат: меньше охват, ниже «сырая» конверсия, НО выше прибыль и эффективнее бюджет.

🟠 Почему это важно

Это типичная ошибка: оптимизируют ML-метрику и игнорируют бизнес-метрику. Особенно это встречается часто в маркетинге, churn, рекомендациях или кредитных решениях.

Если ваша метрика не связана с деньгами, вы не управляете результатом. ML-модель должна оптимизировать не accuracy / ROC-AUC, а экономический эффект.


Вы когда-нибудь сталкивались с ситуацией, когда модель лучше по метрикам, но хуже для бизнеса? Пишите в комментариях 👇🏻
  • ❤ 3
  • 👍 3
  • 🔥 3
Post #36 881
Как автоматически находить ошибки в разметке и чистить датасеты

Привет! На связи Мария Жарова, ML-инженер в команде рекомендаций в Wildberries и ментор курса «Инженер машинного обучения» 👋🏻

Если вы когда-нибудь обучали модели, то знаете: качество данных почти всегда важнее самой модели. Неверная разметка, дубликаты, пропуски, дрейф — всё это незаметно «ломает» метрики и приводит к странным предсказаниям.

Хорошая новость — часть этих проблем можно находить автоматически!

Для этого есть библиотека Cleanlab — инструмент для анализа качества данных и поиска скрытых ошибок в датасетах 🧹

Что умеет этот инструмент:

🟠 Находить потенциально неверно размеченные объекты и оценивать «уверенность» в разметке;
🟠 Искать шумные классы и пересечения между ними;
🟠 Выявлять дубликаты и аномалии;
🟠 Анализировать пропуски и проблемы в признаках;
🟠 Проверять дрейф данных между выборками.

А также Cleanlab полностью совместим со sklearn «из коробки» и умеет работать поверх любой модели.

Как это работает?

Cleanlab использует вероятностные предсказания модели, чтобы оценить, насколько разметка согласуется с паттернами в данных. Если модель стабильно «не согласна» с label’ом, объект помечается как подозрительный. Это особенно полезно для:

🟠 больших датасетов с ручной разметкой, особенно при крауд-сорсинге;
🟠 CV / NLP-задач;
🟠 пользовательских событий (где много шума).

Быстрый старт

Установка:

pip install cleanlab


Пример №1 — поиск ошибок разметки для классификации:

# ищем подозрительно размеченные объекты
label_issues = find_label_issues(
labels=y_train,
pred_probs=pred_probs
)


На выходе получаем строки датасета, где разметка, вероятно, ошибочная — их можно перепроверить вручную, удалить или переразметить.

Пример №2 — автоматическая очистка датасета:

from cleanlab.classification import CleanLearning

cl = CleanLearning(model)
cl.fit(X_train, y_train)

# уже очищенное обучение
preds = cl.predict(X_test)


Также среди возможностей библиотеки — оценка качества разметки по классам (можно понять, какие классы путают чаще всего), а также работа с текстами и изображениями — достаточно подать эмбеддинги или вероятности любой модели.

Быстрые ссылки
➡️ Официальная документация
➡️ Страничка на PyPI с примерами

Ставьте ❤️, если было полезно — и сохраняйте, чтобы протестировать на своих датасетах!
  • ❤ 8
  • 👍 6
  • 🔥 3
Post #35 206
Отбор признаков в машинном обучении

Привет! На связи Кристина Желтова, директор по разработке моделей в Газпромбанке и преподаватель курса «Инженер машинного обучения» 👋🏻

Представьте, что вы обучаете ML-модель на датасете из 50-ти признаков с точностью 87%. Добавили еще 20 признаков и качество упало до 83% — разве больше данных не значит лучше? Нет, если данные некачественные. Чем больше бесполезных признаков, тем быстрее модель переобучается и хуже обобщается на новые данные.

В этой ситуации на помощь приходит отбор признаков (feature selection) — одна из самых недооценённых техник классического ML. Во многих моделях есть «встроенные» способы отбора признаков — например, для случайного леса можно оценить важности признаков простым способом за 30 секунд:

from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import make_classification

X, y = make_classification(n_samples=1000, n_features=50, n_informative=10, random_state=42)

# Обучили модель
rf = RandomForestClassifier(n_estimators=100, random_state=42)
rf.fit(X, y)

# Посмотрели важность признаков
importances = rf.feature_importances_
top_features = sorted(range(len(importances)), key=lambda i: importances[i], reverse=True)[:10]
print(f"Топ-10 признаков: {top_features}")


Почему это работает? Потому что случайный лес рассчитывает, насколько каждый признак уменьшает ошибку на каждом шаге построения каждого дерева решений. Если признак не помогает, он не будет использоваться часто.


Однако этот метод не лишён недостатков, поэтому на практике есть большое количество алгоритмов отбора признаков, которые можно разделить на три группы:

1️⃣ Filter-методы (фильтруем признаки по статистике)

Это самый быстрый способ. Мы смотрим на каждый признак отдельно без построения модели: например, удаляем признаки с низкой дисперсией (по сути делаем предположение, что раз они не очень разнообразны, то и не очень полезны).

from sklearn.feature_selection import VarianceThreshold

selector = VarianceThreshold(threshold=0.01)
X_filtered = selector.fit_transform(X)


Отличный вариант на случай, если у вас очень много признаков и нужно быстро сократить их количество.

2️⃣ Wrapper-методы (обёртки)

Более медленные, но умные методы — тренируем модель много раз, удаляя или добавляя признаки.

from sklearn.feature_selection import RFE
from sklearn.linear_model import LogisticRegression

# RFE (recursive feature elimination): обучаем модель, удаляем худший признак, повторяем
estimator = LogisticRegression(random_state=42, max_iter=1000)
rfe = RFE(estimator, n_features_to_select=10, step=1)
X_rfe = rfe.fit_transform(X, y)

print(f"Выбранные признаки: {rfe.support_}")


Отличный баланс скорости и качества, когда признаков не слишком много, и есть время подождать.

3️⃣ Embedded-методы (встроенные в модель)

Как раз к ним относятся feature_importances_ из случайного леса. Быстро, но зависит от конкретной модели.

Эти методы в совокупности помогут вам отобрать лучшие признаки для своих моделей и быстро улучшить качество.

Ставьте 🔥, если интересно!
  • 🔥 10
  • ❤ 2
  • 👍 2
  • ❤‍🔥 1
Post #34 191
🔔 Напоминание: через пару часов начинаем вебинар о data science

О чём будем говорить:
🟠 Кто такой Data Scientist и как различать DS/ML/DL/AI (и зачем это знать);
🟠 Почему машинное обучение не всегда лучше аналитики, но без него не обойтись;
🟠 Откуда такой спрос на DS и какие задачи бизнес готов за это платить;
🟠 Какие требования к junior DS сейчас на рынке;
🟠 А главное — на практике: построим модели оттока клиентов банка, сравним подходы и разберём ключевые факторы.

➡️ Зарегистрироваться
  • 👍 5
  • ❤ 4
  • 🔥 3
Post #33 203
Я расскажу всё, что нужно знать о профессии Data Scientist

Привет! На связи Мария Жарова, ML-инженер в команде рекомендаций Wildberries и ментор курса «Дата-сайентист» 👋🏻

Часто новички путаются: DS, ML, DL, AI — это одно и то же? Когда вообще нужно машинное обучение, а когда хватает обычной аналитики? И что реально спрашивают на собеседованиях у джуниоров?

На вебинаре мы не просто поговорим о теории, но и займёмся практикой. Возьмём данные о клиентах банка и вместе построим модели для прогнозирования оттока. Сравним разные алгоритмы, посмотрим на метрики качества и интерпретируемость, разберём, какие факторы влияют на уход клиентов и как их отследить.

Расскажу вам:
🟠 Кто такой Data Scientist и как различать DS/ML/DL/AI (и зачем это знать);
🟠 Почему машинное обучение не всегда лучше аналитики, но без него не обойтись;
🟠 Откуда такой спрос на DS и какие задачи бизнес готов за это платить;
🟠 Какие требования к junior DS сейчас на рынке;
🟠 А главное — на практике: построим модели оттока клиентов банка, сравним подходы и разберём ключевые факторы.

❗️ Встречаемся 13 апреля в 19:00 МСК

Подключайтесь к эфиру — я отвечу на ваши вопросы про карьеру в DS, машинное обучение и реальные кейсы из индустрии (и немного про работу в Wildberries, Альфа Банке и Сбере, если спросите 😁).


➡️ Зарегистрироваться
  • ❤ 6
  • 👍 3
  • 🔥 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →