TGViewer
Channel Public Channel
StarRocks and modern data stack

StarRocks and modern data stack

@modern_data_stack

Будни современного стека для работы с данными с позиции платформенного инженера: StarRocks, Vertica, Hadoop & Spark, половинка k8s с щепоткой golang.
Не единым гп и скалой жив рынок :)

@barloc
https://t.me/dbt_users
Subscribers
541
Photos
106
Videos
0
Links
88
Recent Posts 20 shown
Post #154 265
За долгом всегда придут

Где-то в прошлой до-ии жизни я написал негативную статью на хабре про Redpanda. Недавно на нее прилетел комментарий и я очень удивился, что статьи читают. И уже после нее на смартдате ребята из Авито рассказали как она классно работает (на выделенном железе и nvme ssd дисках, ну еще бы не работать...)

К чему это? Причина, по которой у StarRocks нестабильная потоковая запись в таблицы найдена окончательно.
И похоже я опять прошелся по тем же самым граблям :(

Нас подвели 2 вещи: попытка завести основной marts слой на вьюхах и неверный выбор дисковой подсистемы для кластера.

1. Откуда view? Попытка склеить факты между собой либо склеить медленные факты с nrt фактами. В итоге StarRocks как попало делает pushdown в таблицы из вью, и достаточно часто на нагрузке не делает его вовсе. То есть запросто вместо чтения только последней партиции мы получаем фулскан чисто из-за ошибки оптимизатора.
2. Напомню, что в документации планирования кластера рекомендуются SSD диски ораниченного размера. Но мы исходили из того, что есть - пачка разделов с схд.

Что получилось: у нас идет постоянный стриминг данных (от 1 до 10 тысяч событий в секунду). И тут прилетает фулскан гигиабайт на 600-700, а иногда они вовсе стоят в обновлении раз в 1-10 минут. IO на схд говорит - вы че там, двинулись? И в это время мы получаем еще удар на запись/чтение стриминга через механизм enable_persistent_index (это относительно свежая фича, при которой индексы вместо памяти хранятся на диске в RocksDB - что надежнее, но и затратнее).
В итоге: кластер забил дисковую очередь чтениями, а запись в это время просто стоит. Никаким образом потоки или приоритеты разрулить нельзя. Память относительно свободна, процессор не утилизируется.
Быстрая победа: этап безконтрольного выполнения запросов на кластере закончился - на все ресурсные группы былы выставлены ограничения как по размеру сканов, так и размеру самих запросов.
Медленная победа: надо покупать ssd (впрочем, на дворе 26 год - давно пора).

В чем плюсы то? На картинке поставил разницу в задержке воспроизведения CDC в Vertica и StarRocks - получается выигрыш x2.
Post #153 534
DE, AI и та самая демократизация данных

Мне кажется, что 80% успеха команд данных в современном AI мире строится на тех же самых скучных инструментах, которые используются более 5 последних лет. Не надо внедрять никаких супер-пупер RAG, автономных агентов, строить вики на векторных связях, городить единые хранилища контекста всея компания.

Поворот в сознании случился в момент внедрения nao и попытках построить RAG поверх dbt и QlikSense - эти процессы просто встали из-за нехватки ресурсов. Ситуация представляется патовой - без предоставления прямого доступа команды инженеров умирают под текучкой, но и текучка не может выпустить инженеров предоставить нужные инструменты.

Значит что? Значит надо строить обвязку ровно вокруг используемых инженерами инструментов :)

С какими вопросами приходят в команды у нас? - Где лежит... Как считается... В каком борде можно посмотреть... Чтобы дать хорошее качество без догадок мы должны дать перевод бизнес языка на технический (название метрики в то, как она считается), показать где лежат нужные для расчета или селекта данные (описание таблиц и их связей), дать возможность выполнить запрос на корректном диалекте с нужными доступами. Отдельно идут BI системы, в которых традиционно хрен знает как искать нужную информацию, а значит мы должны подсказать где лежит любая метрика, разрез, борд с нужным описанием.

Выходит стандартная архитектура - любой интерфейс доступа со стороны иишки (mcp, api+tool, skill), который умеет качественный поиск с бизнес ранжированием поверх рабочих интерфейсов - dbt (у нас в нем хранится не только мета таблиц, но и описание метрик - о чем мы рассказывали на митапе еще года 3 или 4 назад) и самого QlikSense. Любое изменение порождает перестройку индекса, работает в автоматическом режиме, никаких дополнительных затрат - сервисы кушают по 50-60 мегабайт памяти для хранения и поиска всей меты со скоростью в милисекунды.

А дальше работа инженеров данных становится куда более критичной - описание нужно полное и актуальное, все должно работать как часы, безопасность должна быть безопасной (теперь если есть доступ человека к данным - значит данные уже утекли в claude, grok, ваш любимый роутер), скорость поставки должна сильно сократиться. То, чем мы занимались раньше столько лет становится еще более критичным - перед инженерами исчезает прослойка, которая могла сыграть амортизатором в каких то вещах.

PS А nao теперь в итоге поднимается на связке этих mcp без всяких проблем - 0 затрат и внимания.

PPS Опять выводы похожи с прошлым постом. Раньше сторонние коробки решали проблемы интерфейсом, который теперь стал не нужен. Какая разница как рисуется lineage в каталоге данных - нам нужна информация из него.
  • ❤ 3
Post #152 643
Выбор CDC сделан

Нам очень хотелось сделать CDC из наших MySQL в Hadoop вместо StarRocks: это сильно уменьшает стоимость хранения, это убирает затраты ресурсов из дорогого места выполнения запросов в дешевое место технических джобов и больших серверов, это убирает лишние копии данных.

Не вышло. Не вышло как хотели.

Apache Paimon + Flink. Связка работает и вроде как работает неплохо. К сожалению доклад на смартдату сорвался :(
Какие минусы: реализация в кубе - отстрел своих ног, снятие начального снепшота - проще застрелиться на бд большого размера, отсутствие вообще любого решения для non-pk таблиц. И самое главное - жаба жрет память ведрами, проигрыш современным нативным решениям такой, что даже нет смысла туда смотреть. Это гигабайты-десятки гигабайт против десятков и сотен мегабайт.
Проблема сверок, проблема мониторинга.
Проблема скорости внедрения (тут очень субьективная штука), но 8 месяцев заняло обстучать грабли у одного человека.

Оставили работать на 2 достаточно больших базах данных, чтобы посмотреть стоимость поддержки.

Итоговое решение (которое изначально не хотелось делать): допилили свой репликатор для Vertica, теперь он вставляет данные в StarRocks, и он же снимает дампы для флинка и восстанавливает их в Paimon 😂

Upsert здесь неплохо выручает, в итоге даже с реализацией транзакций в 3.5 ветке все работает достаточно стабильно.

Потребление памяти в районе 40-50 мегабайт на сам сервис, ну и компакшн в ср выдает цифры в десятки/сотни мегабайт. Даже на дампе и импорте начального снепшота потребление не больше 100 мегабайт для любого размера таблиц и скорость на порядок выше флинка.

Время реализации: около полутора недель активного написания кода + неделя отладки.

Так как написано на golang, то в к8с встало как родное.

PS можно много выводов сделать, но основной для меня - AI позволяет не бояться делать такие штуки и при наличии мозга получается очень адекватно реальности. Когда-нибудь мы донесем репликатор до опенсорса, но мне кажется что быстрее MySQL вымрет в округе :)
  • 🔥 8
  • 👍 2
Post #151 1.28K
Какой-то микс нынче в дата мире происходит

Сократят ли кожаных в пользу AI? Я тут погуглил. Мне кажется, что эти 2 компании умеют пользоваться иишкой как никто другой. Ну и чего, сократили там кого-нибудь? :)

С другой стороны не пользоваться сейчас таким инструментом кажется довольно глупой идеей. Не знаю как у вас, у нас в командах данных текучки более 50 процентов. Я больше 10 лет пишу код, около 5 лет в текущей компании. Писать очередной оператор в эйрфлоу, объяснять зафиксированные метрики в дбт в очередной раз? Увольте пусть ии ответит за меня.

И вот эта история с данными, мне кажется, подводит отделы данных к решению такой задачки, как создание "единого хранилища контекста", а моем понимании ai платформы в компании. Что все понимают под этими словами (и понимают ли) - большой вопрос. Есть ли какие-то устоявшиеся шаблоны или хотя бы примеры - нет. Можно ли угадать, куда пойдет развитие иишки - нет.

Именно поэтому это довольно клевая задача :)

Похоже, что StarRocks будет все меньше (хотя мы его и опробовали как хранилище векторов, и у меня для него лежит написание нативного CDC на гошке в беклоге), а больше будет всего подряд про современную техничку в офисе данных во всех ее ипостасях. Потому что никто не рассказаывает про графы для dbt, платформы агентов, тлен векторизации и как подсадить хотя бы 100 человек на свои скилы (оказалось, что писать mcp на гошке - кайф) :)

PS кстати dbx - тормозная штука с глюками интерфейса. И да, это тот момент, когда даже гуй на жабе быстрее.
  • ❤ 6
  • 🤷‍♂ 1
  • 🤔 1
Post #150 1.71K
DBX

Так ли уж много надо для счастья на сегодняшний день? Полный бак бензина, хороший велик и... Чтобы хоть одна sql-ide показывала миллисекунды для datetime колонок в StarRocks!

Я очень люблю сообщества и неформальное общение. Там порой случайно можно узнать что-то интересное, способное поменять твои привычки в работе и сделать картинку вокруг чуточку лучше.

И вот недавно думали тряхнуть стариной и провести новый DBT митап с Алмазом, и он случайно обронил в разговоре dbx. Выглядит интересно, пошел смотреть что это такое.

Да, вся IDE поместилась в 15 мегабайт с поддержкой почти всех бд, которые сейчас есть на рынке. Но эти 15 мегабайт, конечно же, не включают в себя JDBC драйвера для вертики или хайва, например. А вот StarRocks включен в поставку по умолчанию. И то, с чем не справились ни JB с их убер зоопарком, ни DBeaver с аналогом - вот на скриншоте сверху.

А еще в DBX на маке работает cmd+enter для выполнения запросов, что благополучно сломали уже год как в DBeaver.

А еще там есть MCP для всех ваших коннектов и готовое how-to интеграция с курсором и клодом (и остальными). Который впрочем не работает на маках с арм :)

И еще рендеринг тупит и если быстро листать виртуальные столы - то видишь белый экран примерно пару секунд после перехода.

Но ладно, за миллисекунды и хоткеи все можно простить. Теперь это мой топчик. Спасибо, Алмаз :)
  • 🔥 9
  • 👍 2
  • 😁 2
Post #149 715
Обновки подъехали

Абсолютно случайно в ln увидел, что в SQLMesh завезли поддержку StarRocks. Здорово, что у кого-то это первый публичный pr и сразу такого размера :)

И вот сейчас вроде интересно попробовать - наконец-то у нас в обойме появилась хотя бы одна бд, которая поддерживается. Но с другой стороны - что SQLMesh, что DBT теперь принадлежат Fivetran с каким-то мрачным будущим. Да еще вот только что я делал CI в DBT для мультикаталогов в StarRocks и вот сильно не уверен, что это реально повторить в SQLMesh.

И есть подозрение, что ко всему этому мы начнем распиливать активно единый проект на много проектов.

Есть у кого опыт, стоит ли пробовать?
  • ❤ 3
  • 🔥 3
  • 👍 1
Post #148 3.15K
ИИшные будни и полный пятничный сумбур

Сегодня подводили итоги квартала и все команды дата офиса сейчас пишут контекст для своих помощников. И вот нонсенс - чем лучше ваша слоенная архитектура и чем больше у нее документации, тем сложнее ее запихать в RAG и тем хуже на ней работают модели. Спасибо умным людям (привет, Венера), которые начали подробно описывать метрики в компании в маркдауне в репке dbt еще в 22 году - это самый простой и потрясающий буст по контексту для простых потребителей. Но вернемся к тому, почему вроде работали,а получилась шляпа. Самый простой способ убедиться в этом без построениях всяких специальных рагов - поставить nao.

Кто не слышал про эту штуку (как я, например, и спасибо большое просвещающим коллегам) - это по сути самая простая обертка для агента, нацеленная на работу с dwh. С одной стороны вы подключаете любую модель (Claude, ChatGPT, локальные модели), с другой стороны у вас веб чат с аутентификацией и авторизацией, а посередине репа с текстовыми файлами контекста. На первом запуске, когда мы подключили локальную модельку я был в диком восторге - ответ получил за секунды и вроде похож на верный. Правда на следующий день мы выяснили, что он был полностью выдуманным и ни один запрос в бд не был сделан :) Но в общем и целом после тюнинга получается достаточно удобно.

Так вот, в эту репку можно прямо ссылкой отгрузить dbt проект. Плюс еще сам nao собирает мету со всех подключенных бд на этапе init. И потом с этой горой информационного мусоры мы пытаемся взлететь, а размер контекста у локальных моделей сильно отстает от лидеров рынка - будет сплошной мусор.

Решить этой штукой мне хотелось вечную боль команд данных - выгрузки. И все бы ничего, но в коробке такого функционала нет :) Отвечать на вопросы с цифрами может, графики рисовать умеет, но csv выплюнуть - не сделали. У нас в планах на следующий квартал реализовать и пушнуть в апстрим. Еще коллега впрягся и добавил туда поддержку StarRocks :)

А что по остальным командам? BI и их ужасные системы из большой тройки. Самая большая проблема там - найти интересующую тебя информацию. Даже если приложение имеет описание, надо его еще найти, посмотреть есть ли там нужные разрезы и метрики. Решение - RAG. Чуете чем пахнет? Дата говернансом, дада, тем самым. Когда-то внедряли каталоги данных за миллион денег, которые сами по себе не могут решить никаких проблем. Так вот описание нужно, а каталоги - нет. И сам по себе офис данных сейчас по сути становится держателем контекста информации всей компании, мне так кажется.
  • 🔥 10
  • ❤ 1
Post #147 605
Ограничения архитектуры

Вчера абсолютно случайно набрел на выступление Виктора из Авито про стабильность платформы данных. Именно тот момент, когда получаешь интересный доклад на неожиданной площадке. И почему так важно выбирать площадку под доклад для получения нужной аудитории. Мне доклад понравился: решение проблем не заменой системы, а выстраиванием хорошего стека вокруг нее. Напоминаю, что тайминг этого доклада попадает с отказом от вертики и миграцией на трино, и тут причин еще больше набросали.

Так вот про архитектуру. Vertica при всех своих недостатках - шикарная база. Она очень удачно использует свою архитектуру и много где снимает головную боль с конечного пользователя. Например, та самая история про внутреннюю репликацию данных. Выставили вы степень репликации и знаете, что у вас отказоустойчивость -1 нода (или -2, если вы богатый буратино) - все как в ГП. StarRocks же предлагает на замену историю про таблеты (выше уже рассказывал про них).

И что в итоге? Мы словили проблему мелких файлов, столько известную в хадупе, на нашем кластере StarRocks. 180 тысяч таблетов на 6 нод. Вам может показаться, что это не так и много - но наш любимый стриминг впал в полный неадекват. Постоянные спайки на графиках отзывчивости, зависания потоков, 99 перцентиль ушел за пределы минуты. И это при свободном процессоре и свободной памяти. Все метрики на компакшне на графиках тоже особо не показательны - десятки и сотни мегабайт потребления.

Надо думать СВОЕЙ ГОЛОВОЙ при создании таблиц и всегда-всегда задавать количество бакетов. И не стоит мелочиться с партициями. Если нам прямо говорят, что таблет должен быть от 1 до 10 гигабайт, то так и надо делать.

Уменьшили количество таблетов в 6 раз, почти везде перешли на годовые партиции, количество бакетов чаще всего от 1 до 3. И только на больших таблицах оставили 6. Как итог - график выправился, работать стало стабильнее. Начал завидовать ребятам с дата лейками, насколько понимаю там эта ситуация обыграна лучше.

На всякий случай, картинка выше - про внутренние таблицы SR. У нас к этому еще около 10к таблиц из хадупа, ну и пара тысяч из mysql источников.

А чего так долго не был?

Каждый раз, когда увеличивается зона ответственности, наступает период адаптации. Команд стало больше - справляться трудно. Интересно когда наступает предел, когда кукуха начинает уезжать.

С другой стороны, буст от иишки очень сильно виден почти у всех. Не думаю, что команды и дальше будут расти по головам. Чото много мыслей на эту тему, но история все рассудит.

А дальше у нас будет пост про CI для StarRocks, к которому подключены десятки внешних каталогов. Хотел этот доклад на смартдату донести, но видимо придется где-то в сторонке сделать.
  • 🔥 6
  • ❤ 4
  • 👍 2
Post #146 1.38K
✨ 2 апреля в Москве на Data Summit от DIS Group выступят коллеги из StarRocks

💼 спикеры расскажут о следующих аспектах развития StarRocks:
🔹 применении ИИ‑агентов в StarRocks;
🔹 повышении скорости аналитики в реальном времени — том самом «молниеносном» быстродействии системы;
🔹 roadmap продукта, включая новости о материализованных представлениях и их субсекундных обновлениях;
🔹 улучшениях в механизмах кэширования и оптимизаторах;
🔹 работе с операциями UPSERT и MERGE;
🔹 поддержке рекурсивных CTE‑операций;
🔹 расширении возможностей UDF в SQL;
🔹 алгоритмах распределения данных в таблетах на основе интервалов значений.

📅 Ещё есть время зарегистрироваться на мероприятие: можно выбрать желаемый формат участия — онлайн или офлайн.

🚀 2 апреля — отличная возможность узнать о новинках и перспективах StarRocks из первых рук. Рекомендуем обратить внимание на это событие!
  • 👍 6
  • ❤ 4
Post #144 841
А теперь мероприятие номер 2. Если кто хочет пообщаться с разработчиками StarRocks лично :) А таких я видел.
Post #143 1.36K
Сегодня день анонсов разных мероприятий по StarRocks, которые пройдут уже вот-вот.

Буквально вчера в канале спрашивали про работу iceberg через StarRocks на S3 от Selectel.

И вот тут есть что послушать (но не уверен про S3):

вебинар СР ТЕХ х Selectel 31 марта в 12:00.
Расскажем про результат прогона StarRocks на TPC-DS в облаке: от 3 узлов до 111, от 100 ГБ до 10 ТБ. Реальное поведение СУБД с графиками, цифрами и инженерными выводами.
Регистрация на вебинар: https://selectel.ru/blog/events/analytics-database/
  • ❤ 6
  • 🔥 3
  • 👍 2
Post #141 1.13K
ODBC и Qlik Sense

Почти во всех своих выступлениях я топил за то, что на StarRocks легко мигрировать за счет стандартных MySQL драйверов. Все системы подключили, формально все работало хорошо с хорошими размерами данных. Но мы начали массово переносить приложения в клике на данные из ср и получили непонятные проблемы :(

Загрузка данных возвращает пустой датасет - 0 строк. Запрос проходит успешно, на стороне клика ошибок нет. На стороне ср запрос завершился ошибкой, но ни текста, ни кода ошибки нет. При этом мы сейчас работаем с данными из хадупа, и ср тут служит лишь интерфейсом к нему - это породило определенные гипотезы на проверку.

* попали на обновление данные через спарк (нет, не попали)
* не обновилась мета файлов в StarRocks и запросы падают по причине несуществующих файлов (нет, обновилась. вплоть до того что пробовали втыкать перед загрузкой refresh external table и select limit 1 - данные есть и читаются)
* косяк с ODBC драйвером: начали с самого последнего 9+, потом нашел статью от CelerData по подключению PowerBI и там указана 8.0.23 (нет, не помогло)
* попытка перейти на Mysql Enterprise Edition драйвер, который предоставляет сам Qlik Sense (нет, StarRocks с ним не совместим)

Бродил по ишью в гитхабе и наткнулся на мнение интерна, что StarRocks вообще не очень хорошо поддерживает именно ODBC драйвер.

И самое интересное, что в нашем случае проблемы как таковой нет - у нас обновление приложений запускается через сторонний оркестратор (airflow) и ретрай всегда заканчивается успехом. И затронуты не все прилы.

Нипанятна :(
  • ❤ 5
  • 😁 5
  • 😱 5
Post #140 804
Любовь к переопределению стандартных настроек

Не знаю с чем связано непреодолимое желание определить свои настройки и забивать на стандартные практики в индустрии. Дам два примера:

* Apache Paimon и его ишью. Кратко: ваши желания в hdfs-site.xml - это ваши проблемы, а писать файлы мы всегда будем с фактором репликации 1. Доросли до версии 1.3, но исправление есть только в мастере.
* dbt-starrocks и его настройки адаптера по умолчанию. Что вы там на уровне кластера задали - ваши проблемы, все новые модели мы будем сохранять с фактором репликации 1.

Очень-очень сильно такие вещи вымораживают, когда ты однажды остаешься без данных из-за мигнувшей ноды.
  • 👍 4
  • ❤ 2
  • 🌚 1
Post #139 1.71K
Вот такой подарок привезли :)

Интересная штука. Я все гадал, что же может весить почти 2 килограмма :)
  • 🏆 25
  • 🔥 9
  • 👍 7
  • ❤ 6
Post #138 827
DE больше не нужны

Последнюю неделю все чаты обсуждают пост Димы Аношина про то, как злые бриксы выпиливают возможности ковыряться в техничке дата инженерам.

Но для меня история с обязанностями де остается не очень понятной, и скорее всего виной всему наши (да и не только наши) бигтехи. На рынке сейчас есть только одна возможность выжить - очень быстро доставлять. Доставлять фичи, доставлять решения, зарезать неверные решения (если мы говорим про аналитику). А теперь смотрим на картинку выше - сколько времени займет доставка из этого классного кружка? :)

Начиная с какого-то уровня люди внутри компании (заказчики, бизнес) становятся более требовательными к качеству продуктов (визуал бордов, скорость и надежность поставки) - и вот появляется история с специализацией. На картинке не хватает еще BI инженера с BI аналитиком :)

Скорость доставки снижается, часть проблем утопает на стыках специалистов, но все становится красиво и качественно.

И вот тут каждая компания начинает ловить баланс - сколько кого им надо, в зависимости от потребностей, баланса, эго руководителей.

Дальше я вижу проблему в триаде аналитик данных - аналитик-инженер - инженер данных. Эти три роли примерно про одно и тоже, но стоят последовательно на спектре задач от технички до бизнеса. И при этом имеют два ограничения - домен данных и отсутствие масштабирования результатов труда. То есть в голову больше ограниченного объема бизнеса не получить, и витринки под каждого заказчика становятся все глубже и детальней. Техничка для инженеров не является никаким ограничением - ну камон, научиться использовать партиции в спарке, джойнить по ключам в постгрессе, использовать файнал в кликхаузе, ну не большая же наука?

Заканчивая мысль, рынок будет стремиться сократить ТТМ аналитических решений за счет сдвига людей в сторону бизнеса, что и приводит к смерти профессии инженера данных.

Ну а если хочется остаться в техничке - это путь в платформенные команды или чистую разработку (как те же мл-ребята).

PS перечитал и увидел, что не раскрыл историю с бигтехами. Быть повелителями yml != инженером данных. Очень странно слышать про то, как угнетающе писать ямлы в Т, озоне и еще где-то, но при этом не мочь сказать ни слова про бизнес домен, в котором работаешь. В чем тогда состоит работа? Быть живым курсором?..

PPS никогда не работал в бигтехах :) и вообще сегодня пятница
  • 🤔 6
  • 👍 4
  • ❤ 3
  • 🔥 2
Post #137 1.9K
Pythonic Cursor и литература

Когда-то в очень далекой галакти.. просто очень давно (лет 6-7 назад) я попал на собеседование на инженера данных в VK. Это было время, когда у них внутри никто и подумать не мог про яндекс балалайки, все мучали... рассказывали про свою самописную бд и свой PHP. И буквально за пару недель до собеса вышла статья про то, как они написали свой rate limiter для вставки данных в Clickhouse. И вот весь час собеседования мой интервьювер пытался выжать из меня идеальную реализацию лимитера на python (сразу скажу, что безуспешно :). И вот именно с тех пор я понял, что, во-первых, такие штуки не так просты, и ,во-вторых, не надо изобретать велосипеды и стоит брать уже готовые библиотеки для вашего языка.

Перемещаемся в наше время. Мне для какой-то очень простой апишки надо ограничить отправку данных в нее с нашей стороны - то есть добавить этот самый rate limiter. Скучная работа - добавить зависимостей, поменять 1 строчку в коде и накинуть тестов. А что у нас есть для скучной работы? Cursor! Хей, Cursor, добавь rate limiter вот тут для requests.post с ограничением в 100 запросов в секунду и сделай под этот функционал тестов. Было странно видеть, что в этом же файле появился новый класс с своей самописной реализацией лимитера (да еще и бажной). Если кто не знает, то есть обертка requests-ratelimiter, с которой вместо Session из requests просто используем LimiterSession. Поправили и забыли.

Но вот что кажется забавным - в python и правда очень любят писать свои велосипеды. Язык настолько простой, то прямо располагает к этому. Зачем читать чужую библиотеку, когда я и сам могу написать не хуже (вспоминая собес, ну, после 5 итерации наверное). Если llm натренирована на той куче кода в гитхабе, то и выдает она вполне Pythonic решение :)

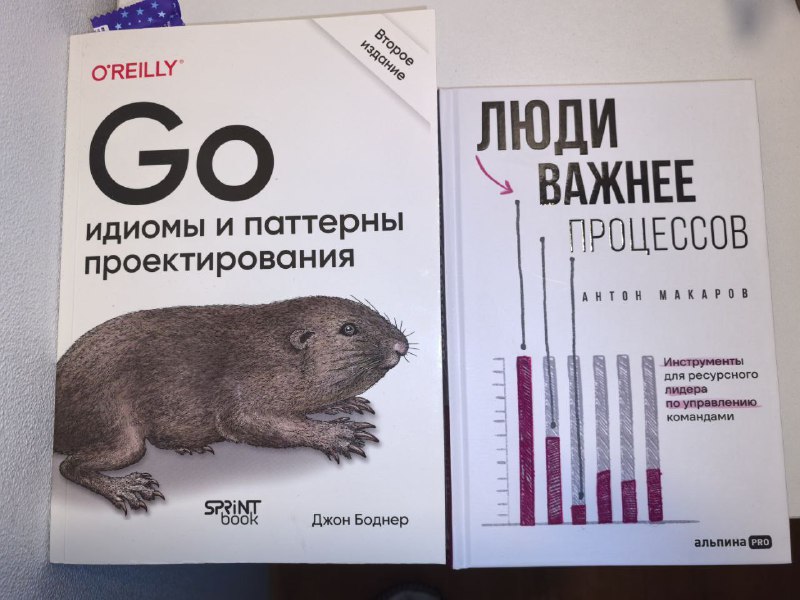
А к чему это фото, подумаете вы? Просто для прочистки мозгов и улучшения вашего python кода очень советую почитать (а может даже и пописать) код на golang. Мне коллега как-то сказал, что мой код на python теперь напоминает гошку - и в принципе, я это считаю за комплимент :)

А у вас на прикроватной тумбочке что есть интересного? :)
  • ❤ 4
  • 👍 4
Post #136 3.01K
Снаряд два раза в одну воронку не падает

Интересно, что у архитектора данных вышел цикл постов о том, почему стоит ехать в облако. А тем временем в нашей вселенной идет все ускоряющийся цикл ухода от облачной инфраструктуры во внутреннюю платформу данных чисто на реализовавшихся рисках (деньги смысла считать даже нет, стоимость рисков с лихвой покрывает всё).

Про что речь? В своем докладе что на смартдате, что в остальных местах я рассказывал про блокировку аккаунта в Google BigQuery в прошлом году на время уточнения данных, и заняло это 3 недели. Что случилось 2 недели назад? Да, аккаунт опять заблокировали, опять уточнение, ну а работа - потерпите, чай не сахарные. И следом уже вчера заблокировали целый пул ip адресов европейских цодов из стран вокруг РФ - запрет на использование api своих сервисов (BQ, GCP). То есть ты находишься не в РФ, платишь не с РФ, но никого не волнует.

Итого последние 3 недели мы перевозим проекты в StarRocks днем и ночью. Но почему-то получилось, что вместо расчета их там все заехало в Spark. Причина достаточно простая - наши эксперименты с бигквери проходили на проектах малого размера, почти все модели в dbt считались на table материализации. Spark такие штуки раскладывает примерно за 10-15 секунд на витринку, нагружать же mpp бд такого рода нагрузкой кажется напрасной затеей. Ведь в чем всегда была притензия к данным в хадупе - медленное чтение, а вот витринки собираются порой быстрее вертики (да что там, кликхауз у меня тоже получалось когда-то в телекоме обогнать). В итоге пользователи, биай и сервисы читают и делают эдхоки через StarRocks, а счет идет в кластере хадупа - все по заветам современных историй лейкхаузов, правда без перекладывания данных в слой доступа.

Ну а какие выводы можно сделать за эти 2 недели? А вот такие:
* перевозить витрины можно очень быстро
* сверять результаты между системами - чудовищная по трудоемкости операция
* витрины начинают разбегаться между системами буквально на следующей недели после переноса - надо или следить, или очень быстро ехать

Даже если функции выглядят в двух системах похоже (именуются одинаково), то совсем не факт что их аргументы или возвращаемые результаты будут идентичными. И поверх накладывается проблема вскрывания ошибок во время написания витрин в исходной системе, когда мы вынуждены или переносить расчет данных и найденную ошибку, либо мы теряем возможность построчной сверки :(

Вообщем печаль, беда и разорение. Если кто знает уже готовый тулсет для сверки таблиц построчно-поколоночно на спарке - напишите в комментарии, пожалуйста. Написать свой вроде несложно, но вдруг древние уже учли все проблемы. Почему spark? Потому что можно в нем внутри сравнивать разные системы без материализации и копирования данных, а еще легко сделать select sha1(*) from...
  • ❤ 10
Post #135 1.02K
Презентация прошла неуспешно - Apache Paimon

Первый блин вышел комом - данные стали занимать в 2 раза больше места, чем в чистом паркете. И запросы стали выполняться в 2-4 раза медленнее, чем на чистом паркете. А запрос на удаление занимает столько же времени, сколько пересоздать партицию целиком. Речь про спарк, если что, до СР еще не дошли.

Похоже так просто его не взять :)
  • 😱 6
  • ❤ 5
  • ✍ 2
Post #134 1.18K
Русскоязычный рынок признан перспективным

1 пост назад я скидывал вакансию на чемпиона от мира StarRocks, и это было признанием, что компания готова вкладывать в развитие своего продукта на нашем рынке. А теперь можно поделиться каналом официального представителя, которого можно будет мучить и спрашивать "почему так?...", да еще немножко управлять ожиданиями - https://t.me/starrocks_selena

И сразу же хороший пост про роадмап на этот год, который я тоже хотел сделать.
Это что же, можно теперь расслабиться и доставать ведерко с попкорном?.. Мечты, мечты :)
  • ❤ 2
Older posts →

About this channel

How can I read @modern_data_stack without a Telegram account?
TGViewer shows the public web preview Telegram publishes for StarRocks and modern data stack: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does StarRocks and modern data stack have?
StarRocks and modern data stack (@modern_data_stack) has 541 subscribers on Telegram, refreshed roughly every 30 minutes.
Does StarRocks and modern data stack know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →