
В итоге родился пакет ollama_embedder — CLI-инструмент на Dart для создания векторных представлений текста с помощью локального Ollama-сервера.
✨ Что умеет:
🔹 Генерирует эмбеддинги для файлов и целых директорий (рекурсивно).
🔹 Работает с локальным Ollama — проверяет установку, доступность сервера и наличие модели. Для векторизации по умолчанию использует модель nomic-embed-text.
🔹 Два режима предобработки: technical — сохраняет код как есть и textual — фокусируется на тексте, код заменяется на [CODE].
🔹 Умная очистка — удаляет HTML-шум, cookie-баннеры, навигацию, футеры, эмодзи.
🔹 Умное разбиение на чанки:
• Автоматически определяет оптимальный размер (до 1500 символов)
• Создает перекрытия между чанками (200 символов) для сохранения контекста (как же я задолбался это делать 🤯)
• Документы до 3000 символов остаются одним чанком
• Разбиение по границам параграфов, предложений и слов
• Автоматическая маркировка секций (intro, code, lists, urls, auto)
🔹 Надежные запросы — автоматические повторы при ошибках Ollama
🔹 Гибкая настройка — URL сервера, модель, таймауты, размер файлов, пути ввода/вывода
🔹 Структурированный итоговый JSON — готов для векторных БД и RAG-систем
🔹 Покрытие тестами — 78% покрытия кода
Пилил все выходные, но в итоге добился классной подготовки текста и кода для векторизации и, собственно, саму векторизацию.
Так что, если кому интересно про векторизацию данных, ставьте лайк, запилю видео, как оно работает.
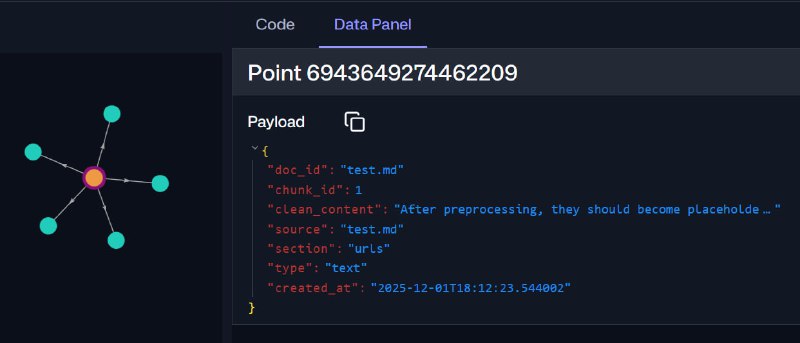
Итоговый point в Qdrant на скрине...
Пример чанка:
[
  {
    "doc_id": "source/test.md",
    "chunk_id": 0,
    "clean_content": "Cleaned single-line chunk text without line breaks...",
    "vector": [0.123, 0.456, "..."],
    "metadata": {
      "source": "source/test.md",
      "section": "full_doc",
      "type": "text",
      "created_at": "2025-01-01T12:00:00.000Z"
    }
  }
]