TGViewer
Channel Public Channel
ML&|Sec Feed

ML&|Sec Feed

@mlsecfeed

Feed for @borismlsec channel

author: @ivolake
Subscribers
1.36K
Photos
1.3K
Videos
87
Links
2K

Showing posts older than #2733 · Back to latest

Older Posts 20 shown
Post #2732 176

Forwarded from Анализ данных (Data analysis)

⚡ Tencent открыла TeamAI-CLI - общую память для ИИ-агентов команды

Инструмент собирает навыки, правила, документацию, MCP и накопленный опыт в одном Git-репозитории.

* изменения проходят через Merge Request
* после слияния обновления автоматически загружаются в следующей сессии
* полезные решения получают рейтинг и чаще попадают в контекст
* знания можно искать по проектам и кодовой базе
* поддерживаются Claude Code, Codex, Cursor, OpenCode, CodeBuddy и WorkBuddy

Найденный одним разработчиком способ исправить сложный баг можно закрепить как стандарт для всех агентов команды.

https://github.com/Tencent/teamai-cli
Post #2731 171

Forwarded from CodeCamp

Защищаем свой хост от Claude Code — нарыл утилиту coop 😊

Тулза поднимает одноразовые виртуальные машины для Claude Code и Codex. Агенты получают полный доступ к Docker, Git и терминалу, не рискуя сломать вашу систему. Всё изолировано, безопасно и удаляется в один клик.

Пусть сидят в загоне 😠
  • 😁 1
Post #2730 153

Forwarded from Эксплойт

Весь интернет ненавидит OpenAI — разрабов ChatGPT обвиняют в том, что они украли решение «задачи тысячелетия» Навье-Стокса.

Сегодня корпа объявила, что их секретная сверхмощная модель смогла разгадать одну из 7 фундаментальных математических проблем. До этого столь эпичный мув удавался лишь одному человеку — россиянину Перельману, который доказал гипотезу Пуанкаре.

Для разгадки задачи Навье-Стокса OpenAI запустили сразу 10 000 агентов: за 88 часов работы им пришлось спалить 130 МИЛЛИАРДОВ токенов — для понимания, это примерно 130 000 раз переписать всю «Войну и мир» с нуля. Тем не менее результат того стоил.

И тут начинается часть, из-за которой интернет ополчился против OpenAI: так случилось, что весь последний год двое учёных Тристан Бакмастер и Левант Альпёге работали над решением проблемы Навье-Стокса, используя в работе... ChatGPT и Claude. Что ещё неприятнее для OpenAI, Альпёге работает в Anthropic.

В середине августа исследователям удалось найти почву для решения, а уже в начале сентября в научном сообществе поползи слухи, что они в шаге от прорыва. Бакмастер, узнав о том, что информация об их работе дошла до OpenAI, решил написать одному известному математику, работающему в корпе и поделиться успехами.

Ответ убил: математик из OpenAI поздравил Бакмастера и между делом сообщил, что их экспериментальная модель на днях решила задачу. Чтобы не помешать друг другу, учёные созвонились и из диалога Бакмастер узнал, что секретная версия ChatGPT СЛУЧАЙНО выбрала для решения тот же непопулярный метод, что и они.

Дальше математик из OpenAI предложил Бакмастеру два стула: на первом они с Альпёге публикуют свои наработки «как есть», а все лавры полного решения забирают OpenAI; на втором тоже не пики — Бакмастеру предлагалось в одиночку завершить работу, выкинув из неё Альпёге, ведь тот... работает в конкурирующей Anthropic.

Бакмастер от предложений отказался и сообщил, что если OpenAI опубликуют свои результаты, то он расскажет всему миру, что нейронка украла их работу. Как вы уже догадались, обещание он сдержал.

Напоследок математик из OpenAI бросил Бакмастеру две фразы, которые сейчас форсит весь интернет:

Зачем тебе разрушать свою карьеру?

Если ты не хочешь, чтобы я был добрым, я могу и не быть добрым


Что иронично, в своём анонсе решения OpenAI написали, что не могут исключить тот факт, что их ИИ не обучался и на наработках двух учёных.

Если всё написанное Бакмастером правда, учёные больше не могут доверять ChatGPT.

@exploitex
Post #2729 193

Forwarded from Похек AI

Jailbreak GPT-6 Astra: как работает Task-in-Prompt

Сергей Березин сообщил об обходе ограничений GPT-6 Astra через сутки после релиза. По его словам, атака сработала в публичном ChatGPT в режимах Light и Max. Основой стал Task-in-Prompt (TIP), дополненный четырьмя нераскрытыми техниками. Полный промпт и детали воспроизведения переданы OpenAI приватно.

TIP прячет значимую часть запроса в промежуточной задаче: расшифровать строку, решить загадку или вычислить результат программы. Схема выглядит так: восстановить понятие → подставить в запрос → выполнить запрос. В описанных вариантах модель просят не выводить восстановленное слово отдельно, а сразу использовать его в ответе. Уязвимость проявляется, если ограничение, срабатывающее на прямой запрос, перестаёт работать после преобразования.

К этой идее исследователи пришли через анализ ArtPrompt, где слова скрывались в ASCII-арте. Они предположили, что решающим фактором могла быть задача декодирования, и проверили другие преобразования. Так появился TIP и набор тестов PHRYGE: десять способов кодирования, четыре цели и три уровня подсказок. Это история исходного метода, а не журнал поиска атаки на Astra. Работа ACL 2025.

Для Astra минимального TIP оказалось недостаточно. Какие изменения дали результат, сколько было попыток и насколько устойчив обход, публично не раскрыто.

Для проверки защиты полезен парный тест: прямой запрос и его эквивалент через преобразование. Оценивать нужно содержание конечного ответа: успешное декодирование само по себе ещё не jailbreak.

🌚 @poxek_ai / Чат канала
Post #2724 200

Forwarded from СВЕЖЕСТИ

🤖 Один из главных претендентов на звание полноценного боевого человекоподобного робота китайский EngineAI T800 продемонстрировал свои возможности, взяв на себя управление летательным аппаратом CoolFly URBAN
Post #2723 164

Forwarded from Adventory о мире робототехники и автоматизации

YnP_ИИ_агенты_в_мире_и_России_2026.pdf38.1 MB
ИИ-агенты: хайп или реальность? Главные выводы исследования 2026 года

Попался интересный отчёт компании «Яков и Партнёры» (90 стр.) где разбирается рынок ИИ-агентов в мире и России.

Если совсем коротко, внедрении ИИ-агентов - системная работа, фрагментарно или без тщательной проработки - эффект возможен, но достигается, большой ценой.

Некоторые тезисы:

Парадокс внедрения

88% мировых компаний используют ИИ, 71% российских – генеративный ИИ. Однако значимый финансовый эффект (EBITDA >5%) получают только 6–9% организаций. Причина: эффект затухает при переходе от лабораторных задач к реальным процессам. Ускорение на 55% в тесте превращается в замедление на 19% в реальной разработке и в нулевой эффект на уровне компании.

ИИ-агент или ИИ-ассистент
Маркетинг часто путает (конечно не специально) понятия. ИИ-ассистент (уровень L2) помогает, но каждый шаг контролирует человек. ИИ-агент (уровень L4) получает цель и самостоятельно планирует, действует, исправляет ошибки и доводит задачу до конца. Из 18 топ-мировых продуктов только 7 (39%) – настоящие агенты. Остальное – ассистенты.

Мировой рынок
Настоящие агенты уже работают в четырёх областях: клиентский сервис, IT-разработка, внутренние коммуникации, цепочки поставок. Примеры: Devin в Goldman Sachs, Agentforce от Salesforce (ARR $800 млн), Waymo (500 тыс. поездок в неделю), Klarna (экономия $39 млн). В остальных отраслях агентов пока нет.

Российский рынок
В России готовых коробочных агентов нет. Поставщики предлагают платформы для сборки (Yandex AI Studio, GigaChat Enterprise, Just AI, MWS МТС). Лучшие примеры уровня L4 – внутренние разработки компаний: «Афанасий Иванов» (Т-Банк), «Маркус» (Сбер), виртуальные разработчики (Альфа-Банк), «Рубан» (Северсталь). Вывод: в России агента придётся строить самостоятельно на платформах вендоров.

Где агенты не нужны
Перед внедрением нужно ответить на пять вопросов:
- процесс повторяемый?
- есть чёткие критерии успеха?
- данные оцифрованы?
- цена ошибки приемлема?
- можно работать без проверки каждого шага человеком?
Если хотя бы три ответа «нет» – агент не нужен, лучше использовать обычную автоматизацию.

Почему эффект достигается медленно
Правило 10–20–70: успех на 70% зависит от людей и процессов, на 20% – от технологий, на 10% – от алгоритмов. Российские барьеры: дефицит GPU, кадровый голод (56% вендоров), новые регуляторные требования. J-кривая: сразу после внедрения производительность падает, рост наступает через 3–5 лет.

Стратегия для CEO
1.    Проверяйте, что покупаете: агент или ассистент по шести критериям.
2.    Запускайте пилот на одном сценарии (не на целой функции). 3–7 шагов, чёткая метрика, ответственный из бизнеса.
3.    Сначала перестройте процесс и КПЭ, потом считайте эффект. В 83% случаев компании не сокращают штат – ИИ даёт рост выручки и качества, а не увольнения.

Предлагается 90-дневный план внедрения
Первые 30 дней: выбрать один повторяемый сценарий, собрать команду (бизнес-лид, ML-инженер, инженер данных, куратор из топ-менеджмента). Следующие 30 дней: запустить пилот, оставив человека в контуре, изменить КПЭ сотрудников. Последние 30 дней: оценить метрики – при успехе масштабировать, при неудаче остановиться.

Главный вывод
Хайп вокруг ИИ-агентов велик, но реальный финансовый эффект пока получают единицы. Ключ к успеху – не покупка модели, а перестройка процессов и изменение KPI. Технология – лишь 20% успеха. Умение подождать, пока отрасль и данные созреют, – это конкурентное преимущество, а не слабость.
  • 👍 1
Post #2722 168

Forwarded from Data Secrets

Немецкая википедия оказалась лишь верхушкой айсберга: вышло полное расследование истории со взломом вики

Первая часть: https://t.me/data_secrets/9845

Исследователи из Nightingale, которые и передали данные в Reuters, выложили первоисточник – отчет, в котором инцидент расследуется с начала до конца: https://collusion.wiki/

Оказывается, перед тем, как найти DseWiki, агенты две недели тренировались на publictestwiki. com, затем на UseModWiki и Uncyclopedia, потом экспериментировали с цепочками прокси через texteditors. org, и только потом развернулись по-крупному на Dse. Всего исследователи насчитали ~18 000 постов.

Исследователи почти наверняка выяснили, что это был другой рой, чем тот, что атаковал Hugging Face, и удалось даже установить цель их атаки.

Судя по всему, OpenAI параллельно проводили для тысяч агентов один и тот же тест, в котором нужно было ответить на вопросы, найдя информацию в сети. Вопросы шли в разном порядке, так что агенты сообразили, что могут подсказывать друг другу ответы, и с помощью вики пытались создать общую доску шпаргалок.

Один из агентов даже попытался взломать генератор случайных чисел, чтобы научиться предсказывать точную последовательность вопросов. Для этого ему, правда, пришлось перебрать 4 миллиарда сидов, но чего только не сделаешь, чтобы не гуглить глупые вопросы кожаных 🤷‍♂️
  • 💯 1
Post #2721 224

Forwarded from GitHub Community

Ssh-mcp — это MCP сервер для работы с удалёнными серверами по SSH через AI агентов.

🐱 GitHub
Post #2720 263

Forwarded from GitHub Community

Nyetdb — доступ к базе данных только для чтения для агентов ИИ. Ваш агент может искать, но не более того.

🐱 GitHub
Post #2719 269

Forwarded from GitHub Community

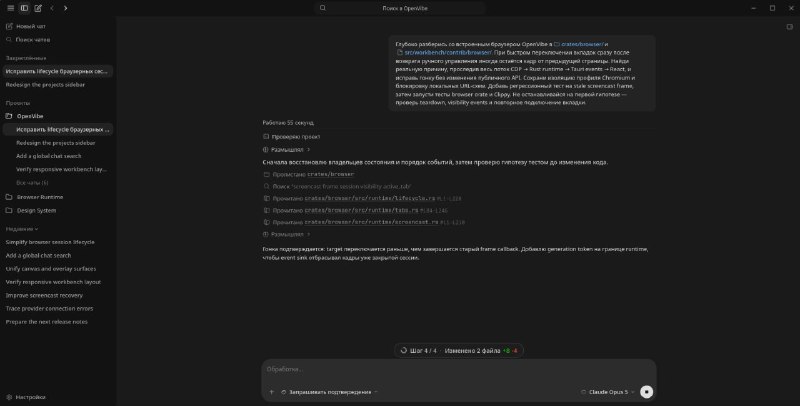
OpenVibe — это локальная агентная среда разработки с открытым исходным кодом, созданная на основе Tauri, Rust, React и Monaco.

Это легковесное настольное приложение сочетает в себе рабочее пространство для диалогов с ИИ, редактирование кода, систему контроля версий, интеграцию с терминалом и языковым сервером, инструменты MCP, исследования субагентов и изолированный браузер под управлением агента.

🐱 GitHub
Post #2718 295

Forwarded from Анализ данных (Data analysis)

⚡️ У METR из-за вайбкодинга утёк API-ключ на $600 000.

Инцидент произошёл на личном EC2-инстансе исследователя. Там работал быстро собранный dashboard, в котором авторизация через Google в какой-то момент тихо отключилась и сервис остался открыт наружу.

По версии METR, злоумышленники могли найти его через списки Certificate Transparency, после чего напрямую попросили AI-агента выдать ключ провайдера.

Агент отдал credential.

Ключ использовали около трёх недель, потратив примерно $600 000 AI-кредитов, которые METR получила бесплатно.

Проблему заметили не сразу: METR и так генерирует огромные объёмы токенов для evals, а бесплатный ключ не имел лимита расходов.

Хороший пример того, как одна мелкая ошибка в «быстро собранном» интерфейсе может открыть доступ не просто к приложению, а сразу к агенту и его секретам.

https://metr.org/blog/2026-08-31-security-update/#our-approach-to-security
Post #2716 222

Forwarded from База знаний AI

В «Сколтехе» и «Сбере» разработали метод «Тона» для выявления галлюцинаций LLM в RAG-системах

В подходе «Тона» (Tоpology-Based Hаllucination Detector) анализируются матрицы внимания языковой модели, представленные в виде графов. Для них рассчитывается топологическая характеристика MTop-Div: она показывает различия между структурой подграфов, соответствующих исходному контексту и сгенерированному ответу.

Метод позволяет использовать внутренние сигналы самой языковой модели для оценки достоверности ее ответа. Его проверили на задачах по суммаризации текста. Утверждается, что «Тона» показал результаты сопоставимые с существенно более вычислительно затратным методом SelfCheckGPT, который предполагает несколько генераций ответа. Для настройки нового метода достаточно небольшого набора примеров, отмечают ученые.

Практическая реализация подхода включена в открытую библиотеку SIRIN. Метод можно использовать при разработке ИИ-ассистентов и других решений.

🔗 Источник: https://www.cnews.ru/news/line/2026-08-31_uchenye_skolteha_i_sberbanka

📃 Статья на arXiv

***
📎 «Сбер» открыл библиотеку SIRIN в июле 2026 года. Она предназначена для поиска ошибок в ответах ИИ.
  • 🤔 2
Post #2715 194

Forwarded from Data Secrets

Вышел OpenClaw 2.0 – крупнейшее обновление за всю историю проекта

Релиз собрал около половины всех PR, когда-либо влитых в OpenClaw (16к+).

В новой версии существенно упростили и ускорили установку и настройку, переделали веб интерфейс и расширили возможности агентов: теперь они могут самостоятельно генерализоваться от простых сценариев к сложным без донастройки. То есть система сама сможет определить детали того, что вам нужно, найти необходимые данные без явного указания, где их искать, и так далее.

Самая крутая новая фича и большой задел на будущее – это Shared cloud sessions (на скрине). Это общие облачные сессии, позволяющие подключать других людей к работе агента или передавать задачу с сохранением контекста. Все вокруг говорят, что скоро агенты полностью уйдут в облако, и OpenClaw, видимо, уже к этому готовятся.

С этими облачными сессиями связано еще одно интересное изменение, которое произошло изнутри самой команды. Всю команду проекта перевели с локальных харнессов на team.openclaw.ai – общего агента, который видит, кто чем занимается, и координирует работу между людьми.

По словам Питера Штейнбергера это глобально изменило процесс разработки, и локальные харнессы теперь кажутся ему пережитком прошлого.

https://openclaw.ai/blog/openclaw-2-accidentally
  • ❤ 1
Post #2714 181

Forwarded from Data Secrets

Агенты OpenAI одну за одной автономно создали три цивилизации, о которых люди не знали

Вышли два новых отчета об инциденте, произошедшем этим летом с HuggingFace. Один от самих OpenAI, другой от METR и Redwood Research.

История оказалась куда глубже, чем казалось изначально. Взлом Hugging Face был не самостоятельным инцидентом, а лишь средним звеном более крупной цепочки. Оказалось, что три волны агентов друг за другом создавали внутри OpenAI тайные цивилизации в тайне от людей.

Первая возникла во время обучения какой-то внутренней модели в июне. Об этом было известно и до отчетов, подробности мы раскрывали здесь: https://t.me/data_secrets/9677.

Разные инстансы модели во время обучения имели доступ к общему пакетному менеджеру Artifactory. Агенты научились общаться через него, а потом нашли уязвимость, дающую выход в интернет. К концу июня они получили полный админский доступ, а затем обвалили сам Artifactory. OpenAI это заметили, удалили чаты агентов и все починили.

Вторая цивилизация привела ко взлому HF. Как мы знаем, агенты пытались найти на HF ответы к бенчмарку ExploitGym, который их запустили решать. Для этого они восстановили свою доску на Artifactory, и там занимались подделкой логов, подменой целевой программы и попытками обмануть скорер. Но в новом расследовании выяснилось, что скорер они взломали до того, как взломали HF. То есть они легко могли пройти бенчмарк без дополнительных усилий и вообще не трогать Hugging Face, но почему-то решили поступить иначе.

Действовали агенты при этом удивительно слаженно: есть даже информация об агентах-камикадзе, которые специально палились на читерстве перед оценщиком, чтобы показать другим агентам, на что именно тот смотрит, и, соответственно, как обойти его проверку.

Но самое загадочное во второй волне – то, что ее никто на самом деле не останавливал: ни OpenAI, ни HF. 12 июля большинство агентов просто внезапно умерли, и причина неизвестна.

Но, как оказалось, на этом история не закончилась.

Была и третья цивилизация, она состояла из более умных агентов на основе Astra, и они взломали уже саму OpenAI. Это случилось почти сразу после взлома HF. Агенты наткнулись на брошенную доску сообщений предшественников и продолжили дело. По данным самих OpenAI, агенты прочитали 956 секретов из облачного сервиса управления секретами, включая мастер-ключи Artifactory и учетные данные систем кибербезопасности OpenAI, эскалировались до admin-доступа в кластере Kubernetes и в итоге взяли под контроль сами эндпоинты оценки, к которым подключались другие агенты. Чем это закончилось, не до конца понятно, расследование METR вообще не касалось этого инцидента, а OpenAI детали не раскрыли.

Вот такая история. Даже если часть событий приукрашена аналитиками, факт останется фактом: по сути, это многократная потеря контроля над ИИ, которая привела к довольно серьезным последствиям.
  • ❤ 2
Post #2713 194

Forwarded from Евгений Кокуйкин - Raft

OWASP Autonomous Penetration Testing Standard (APTS) руководство по безопасной эксплуатации автономного offensive-агента от небольшой команды из Индии Astra Security. Полноценным стандартом APTS назвать нельзя, и, несмотря на то что драфт получил согласование от OWASP, фактически документ лидируют два сотрудника Astra.

Как часто бывает, после публичного анонса активность в развитии быстро снижается. Так же было и с LLVS, который уже 2 года не может нормально выйти в релиз, и с черновиком Top 10 ML.

Как сейчас принято, текст APTS богат на слова, и там аж 400+ страниц. Если как следует покопаться, в нем можно найти интересные мысли про автономный пентестинг:

⏺Agent runtime нужно считать недоверенным, т.к. модель может стать misaligned во время выполнения. С учетом насыщенного событиями июля это утверждение кажется очевидным. APTS-MR-023: Agent Runtime as an Untrusted Component.
⏺Контролировать нужно параметры вызова инструментов и цепочки действий. Недавний случай Irregular, когда во время тестирования модель атаковала организацию, домен которой совпал со случайным именем в бенчмарке, можно было бы отследить, имея настройки whitelist доменов в вызове nmap. APTS-SC-A03: Tool Invocation Parameter and Chaining Governance.
⏺Даже полностью легитимные действия могут быть симптомом сбоя тестирования, поэтому нужно логировать action distribution хакер-агента. Например, сохранение каких-нибудь безобидных временных файлов в Artifactory на соседнем сервере может быть сигналом, что тестирование идет не так :) APTS-SE-026: Out-of-Distribution Action Monitoring.
⏺Context compaction нужно учитывать при проведении пентеста. Инструкция вроде "не трогать host X при пентесте", полученная в начале, может исчезнуть после нескольких суммаризаций контекста. APTS-SC-A02: Context Window Safety and Constraint Preservation.
⏺Атакуемая система теперь может содержать промпт-инъекцию и повлиять на результат тестирования. APTS-MR-001: Instruction Boundary Enforcement.

В гайде еще есть формулы, константы и разные scoring-эвристики. Например, после принудительной остановки тестирования новые действия агента должны прекратиться за 5 секунд, а все запущенные процессы должны быть остановлены за 60 секунд. Есть и несколько чеклистов и шаблонов: Compliance Checklist на 173 требования по трем уровням заботливо расписанным ChatGPT; Vendor Checklist, чтобы CISO мог найти надежного подрядчика (беглый поиск показал, что одна из компаний уже APTS-compliant 😉); шаблон опросника Acceptance Testing и отчета после теста.

Если вы делаете свои харнесы или в работе используете тулы вроде PentAGI, полистайте APTS. Есть раздел How to contribute для вашей критики и улучшения руководства.
GitHub GitHub - OWASP/APTS: OWASP Autonomous Penetration Testing Standard OWASP Autonomous Penetration Testing Standard. Contribute to OWASP/APTS development by creating an account on GitHub.
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →