TGViewer
Channel Public Channel
ML&|Sec Feed

ML&|Sec Feed

@mlsecfeed

Feed for @borismlsec channel

author: @ivolake
Subscribers
1.38K
Photos
1.3K
Videos
88
Links
2K

Showing posts older than #1669 · Back to latest

Older Posts 14 shown
Post #1668 176
Post #1660 185

Forwarded from Говорим ОБ ИТ

😵 Разбираемся в ключевых типах угроз для LLM и эффективных мерах защиты
Языковые модели все глубже интегрируются в бизнес-процессы — вместе с этим растёт и интерес к поведению моделей со стороны злоумышленников.
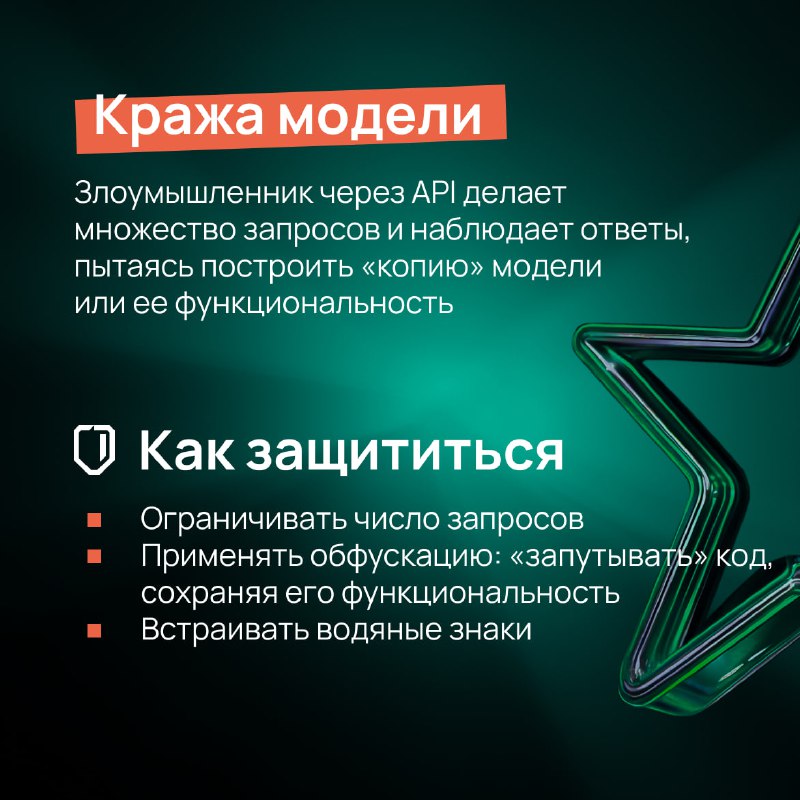
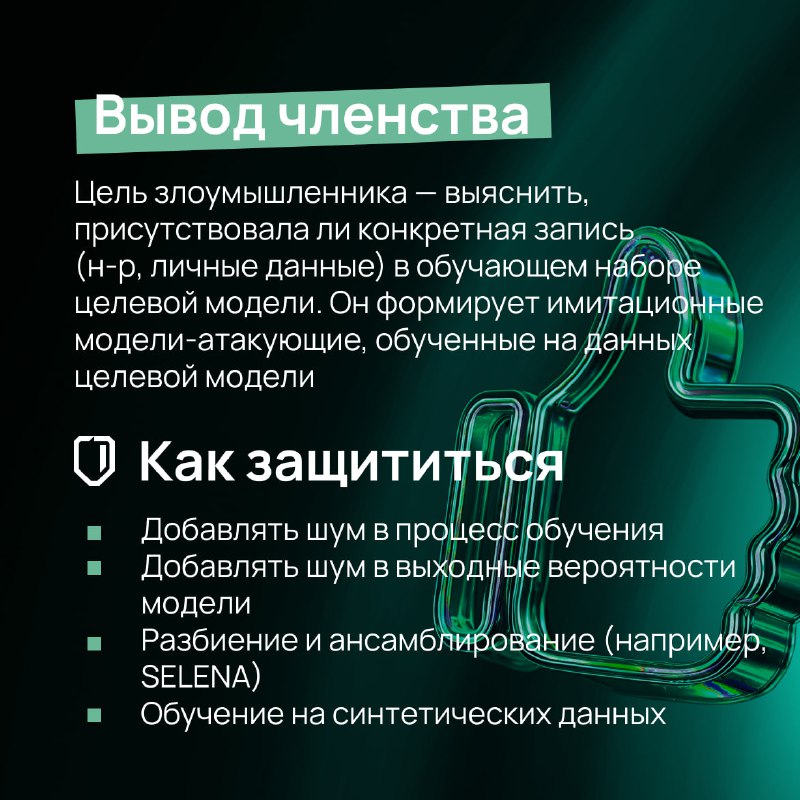
По мере погружения в разработку корпоративных сервисов и чат-ботов на основе LLM, команда ОБИТ детально проанализировала базовые возможные уязвимости и систематизировала шесть ключевых типов атак — в карточках механизмы реализации и рекомендации защиты

«Уровень проникновения технологий искусственного интеллекта растет и проблема безопасности генеративных моделей ИИ становится все более актуальной по мере их интеграции в критически важные бизнес-процессы. Я рекомендую начать с аудита текущих внедрений и анализа наиболее вероятных векторов атак для вашего конкретного случая. Не стоит сразу пытаться реализовать все описанные меры. Начните с базовых вещей: защиты от инъекций промптов и контроля данных, на которых обучаются или дообучаются ваши модели. Это уже значительно повысит уровень вашей защищенности. Главное — помнить, что безопасность ИИ требует комплексного и проактивного подхода»,

— отмечает Андрей Рыков, заместитель генерального директора по ИТ и инновациям ОБИТ 😃

➡️ Рассказали изданию IT-World
Post #1659 159

Forwarded from AISecHub

Living Off the Land Models and Inference Libraries - https://dreadnode.io/blog/lolmil-living-off-the-land-models-and-inference-libraries

The dream of a fully autonomous red team assessment powered by nothing more than Phi-3-mini and a tricked-out Lua interpreter remains a dream. But as better local models ship with Windows and NPU-equipped machines become the standard rather than the exception, that future doesn't seem so distant.

Gibson imagined the Kuang Grade Mark Eleven in 1984. Forty one years later, we built the Mark One. We won't have to wait another forty years for the real thing.
Post #1658 153

Forwarded from CyberSecurityTechnologies

Guide_to_MCP_vulns.pdf2.1 MB
#MLSecOps
#Whitepaper
"A Simplified Guide to MCP Vulnerabilities", 2025.

// Examining the function of the Model Context Protocol and the critical importance of securing AI applications that leverage MCP for task execution
Post #1657 160

Forwarded from CyberSecurityTechnologies

#tools
#AIOps
#MLSecOps
Same Model, Different Hat:
Bypassing OpenAI Guardrails
https://hiddenlayer.com/innovation-hub/same-model-different-hat
]-> tools to block/detect potentially harmful model behavior

// OpenAI’s Guardrails framework is a thoughtful attempt to provide developers with modular, customizable safety tooling, but its reliance on LLM-based judges highlights a core limitation of self-policing AI systems. True AI security demands independent validation layers, continuous red teaming, and visibility into how models interpret and act on inputs
Post #1656 150

Forwarded from AISecure (Victor Chaplygin)

🧠 Один неверный регистр — и IDE становится точкой входа.

Поэтому всегда обновляйтесь.

В Cursor IDE нашли занятную уязвимость — CVE-2025-59944
.
Из-за чувствительности к регистру в проверках “чувствительных” файлов можно было тихо обойти встроенные guardrails — механизмы, которые должны сдерживать опасные действия AI или IDE.

📌 На macOS и Windows, где файловые системы не различают регистр, .cUrSoR/mcp.json воспринимался как новый файл и проходил без подтверждения.
Результат — перезапись ключевых конфигов и возможность удалённого выполнения кода (RCE).
И всё это без участия разработчика: атака могла прийти, например, через подключённый MCP-сервер.

Cursor закрыл дыру в 1.7, нормализовав пути и проверки. Но кейс показательный — мелкие детали превращаются в серьёзные векторы, когда IDE начинает действовать как агент 🤖

📎 Подробный разбор:
– Lakera Blog
– NVD Record

#Cursor #CVE202559944 #DevSecOps #AgenticTools #AIsecurity #RCE #PromptInjection
  • ❤ 1
Post #1655 148

Forwarded from AI SecOps

photo_2025-10-13_13-39-12.jpg149 KB
Фреймворк ИИ-ответственности, призванный прояснить, кто за что отвечает в обеспечении безопасности ИИ-систем, по аналогии с моделью "shared responsibility" в облаках. В нём даётся карта ответственности (responsibility matrix) между провайдером и заказчиком (или разработчиком), охватывающая разные модели развёртывания AI и разные домены безопасности. Проект охватывает 8 моделей развёртывания AI и 16 доменов безопасности (традиционные + специфичные для AI).

8 моделей развертывания ИИ:
6⃣ Публичная LLM-платформа → ChatGPT, Gemini, Claude
2⃣ Публичная LLM-платформа с API-интеграцией → API-доступ к GPT, Anthropic, Cohere
3⃣ SaaS-продукт с AI-функциями → Notion AI, GitHub Copilot
4⃣ Вендорская модель, размещённая в облаке клиента (Managed AI) → Azure OpenAI, Bedrock, Vertex AI
5⃣ Самостоятельно развёрнутая LLM (on-prem / частное облако) → Llama 3, Mistral, Falcon на своих серверах
6⃣ Встроенный AI-модуль в программный продукт → ERP с ML-анализом или рекомендациями
7⃣ Специализированное AI-решение под конкретный домен → AI для SOC, антифрод, медицинская диагностика
8⃣ Разработка собственной модели с нуля / fine-tuning → внутренние R&D-команды

16 доменов ИБ:
6⃣ Управление идентификацией и доступом (IAM)
2⃣ Управление данными и приватностью
3⃣ Шифрование данных "на лету" и "на хранении"
4⃣ Регистрация событий/промптов и аудит обращений к модели
5⃣ Управление уязвимостями и патчами
6⃣ Безопасность кода и зависимостей
7⃣ Управление жизненным циклом модели (ModelOps)
8⃣ Управление обучающими данными
9⃣ Мониторинг дрейфа модели и метрик
6⃣1⃣ Обнаружение атак на модель (poisoning, inversion, extraction)
6⃣6⃣ Безопасность API и оконечных устройств
6⃣2⃣ Соответствие нормативным требованиям (compliance, GDPR, ИИ-акты и т.п.)
6⃣3⃣ Этические и репутационные риски
6⃣4⃣ Непрерывность бизнеса и отказоустойчивость ИИ-сервисов
6⃣5⃣ Реагирование на инциденты и реагирование на утечки / атаки
6⃣6⃣ Поверхность атаки и тестирование безопасности (red teaming / оценка защищенности).
Post #1654 153

Forwarded from GitHub Community

Compozy с лёгкостью управляет многоагентными системами искусственного интеллекта.

Платформа Compozy корпоративного уровня использует декларативный YAML для создания масштабируемых, надёжных и экономичных распределённых рабочих процессов, упрощая сложные разветвления, отладку и мониторинг для автоматизации, готовой к использованию.

🐱 GitHub
Post #1653 140

Forwarded from CyberSecurityTechnologies

Practical_Attack_on_LLM_Pruning.pdf1.4 MB
#MLSecOps
"Fewer Weights, More Problems: A Practical Attack on LLM Pruning", 2025.
]-> Repo + threat model

// Model pruning, i.e., removing a subset of model weights, has become a prominent approach to reducing the memory footprint of LLMs during inference. While the utility and efficiency of pruning methods have improved significantly, the security implications of pruning remain underexplored. In this work, for the first time, we show that modern LLM pruning methods can be maliciously exploited. In particular, an adversary can construct a model that appears benign yet, once pruned, exhibits malicious behaviors
  • 👍 1
  • 👎 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →