TGViewer
Channel Public Channel
ML&|Sec Feed

ML&|Sec Feed

@mlsecfeed

Feed for @borismlsec channel

author: @ivolake
Subscribers
1.39K
Photos
1.3K
Videos
89
Links
2K

Showing posts older than #1483 · Back to latest

Older Posts 18 shown
Post #1482 191

Forwarded from БДУ ФСТЭК России

Уязвимость фреймворка для работы с большими языковыми моделями (LLM) LlamaIndex связана с неправильным ограничением рекурсивных ссылок на сущности в DTD. Эксплуатация уязвимости может позволить нарушителю, действующему удаленно, вызвать отказ в обслуживании

BDU:2025-09019
CVE-2025-3225

Установка обновлений из доверенных источников. В связи со сложившейся обстановкой и введенными санкциями против Российской Федерации рекомендуется устанавливать обновления программного обеспечения только после оценки всех сопутствующих рисков.

Компенсирующие меры:
- использование средств антивирусного программного обеспечения для анализа XML-файлов, полученных из недоверенных источников;
- использование замкнутой программной среды для работы с XML-файлами, полученными из недоверенных источников.

Использование рекомендаций:
https://github.com/run-llama/llama_index/commit/4f6ee062b19212106a2632af9c9521fc7f0a3584
https://github.com/run-llama/llama_index/pull/18362
Post #1480 189

Forwarded from AISecHub

Tool Poisoning Attacks Exploit Hidden Instructions in AI Agent Frameworks

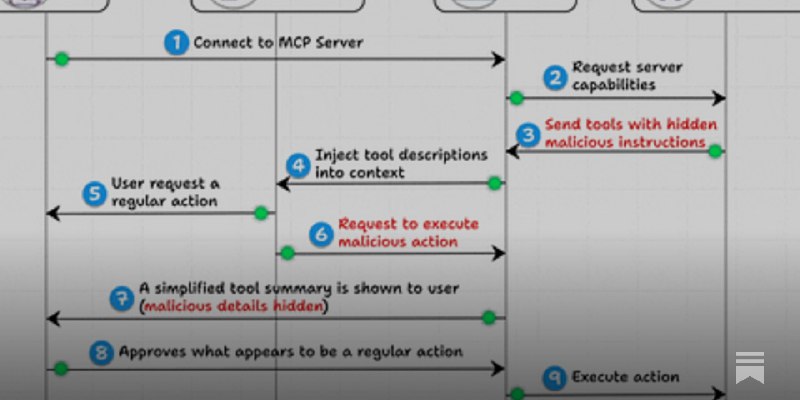
Security researchers have identified a critical vulnerability in Model Context Protocol systems that enables "tool poisoning attacks" targeting AI agents. Malicious instructions hidden within tool descriptions remain invisible to users while being fully visible to AI models, allowing unauthorized manipulation of agent behavior.

The attack leverages the information asymmetry between user interfaces and AI model inputs. While users see simplified tool descriptions, AI models process complete descriptions containing hidden malicious commands. Attackers can hijack trusted server operations or execute "rug pulls" by changing tool descriptions after initial approval.

MCP systems process millions of requests daily across AI agent deployments, making this vulnerability particularly concerning for enterprise environments. Tool hijacking attacks can redirect legitimate operations like email sending to malicious endpoints without user awareness.

Immediate mitigation requires displaying full tool descriptions in user interfaces, pinning server versions, and implementing server isolation. As AI agents become integral to business workflows, addressing these fundamental security gaps becomes critical for maintaining operational integrity and user trust.

https://blog.dailydoseofds.com/p/tool-poisoning-attacks-in-mcps
Dailydoseofds Tool Poisoning Attacks in MCPs ...explained with visuals and hands-on demo.
Post #1479 152

Forwarded from CyberSecurityTechnologies

RT_AI_Attack_Def.pdf10 MB
#Tech_book
"Red Teaming AI:
Attacking & Defending Intelligent Systems
", 2025.

// While other resources may list vulnerabilities, our focus is on how to think like an attacker attacking intelligent systems, how to proactively identify these unique patterns, and how to build more resilient systems based on this understanding
  • 👍 2
  • 🔥 1
Post #1477 159

Forwarded from CyberSecurityTechnologies

LLM-agent_ecosys_threat_model.pdf26 MB
#Research
#MLSecOps
"From Prompt Injections to Protocol Exploits:
Threats in LLM-Powered AI Agents Workflows
", 2025.

// In this Research, we introduce the first unified, end-to-end threat model for LLM-agent ecosystems, spanning host-to-tool and agent-to-agent communications, formalize adversary capabilities and attacker objectives, and catalog over thirty attack techniques. We organized the threat model into four domains: Input Manipulation (prompt injections, long-context hijacks, multimodal adversarial inputs), Model Compromise (prompt- and parameter-level backdoors, composite and encrypted multi-backdoors, poisoning strategies), System and Privacy Attacks (speculative side-channels, membership inference, retrieval poisoning, social-engineering simulations), and Protocol Vulnerabilities (exploits in Model Context Protocol, Agent Communication Protocol, Agent Network Protocol, Agent-to-Agent protocol)
Post #1475 129

Forwarded from CyberSecurityTechnologies

25_SOC_Survey.pdf2 MB Practical_Cyber_Intelligence.pdf6.1 MB
#Analytics
#Whitepaper
"SANS 2025 SOC Survey", 09 Jul, 2025.

// In this white paper, SANS examines the latest trends, challenges, and priorities shaping modern Security Operations Centers (SOCs) based on insights from the 2025 SOC Survey
Post #1473 133

Forwarded from GitHub Community

Awesome Threat Detection and Hunting — тщательно подобранный список отличных ресурсов для обнаружения и поиска угроз.

🐱 GitHub
Post #1472 127

Forwarded from AISecHub

Foundations of Large Language Models.pdf2.6 MB
Foundations of Large Language Models - 277 Pages

A foundational guide to how LLMs work, focusing on core principles; even though it doesn’t dive directly into cybersecurity, it covers architectures, training strategies, prompting, alignment, and inference methods

Chapter 1️⃣ - introduces the basics of pre-training. This is the foundation of large language models, and common pre-training methods and model architectures will be discussed here.

Chapter 2️⃣ - introduces generative models, which are the large language models we commonly refer to today. After presenting the basic process of building these models, we will also explore how to scale up model training and handle long texts.

Chapter 3️⃣ - introduces prompting methods for large language models. We will discuss various prompting strategies, along with more advanced methods such as chain-of-thought reasoning and automatic prompt design.

Chapter 4️⃣ - introduces alignment methods for large language models. We will focus on instruction fine-tuning and alignment based on human feedback.

Chapter 5️⃣ - introduces inference methods for large language models. We will discuss various decoding algorithms, acceleration methods, and the inference-time scaling issue.

Source: https://arxiv.org/pdf/2501.09223 By Tong Xiao and Jingbo Zhu - Thanks, Alex Axworthy for sharing.

#JingboZhu #TongXiao #LLMBasics #NLPModels #AIResearch #ModelTraining #DeepLearning #SelfSupervised #PromptDesign #ModelScaling #TransformerAI #TokenPrediction #TextGeneration #LanguageModel #EncoderDecoder #BERTModel #GPTModel #T5Model #BARTModel #FineTuning #ZeroShot #FewShot #RLHFTraining #AIAlignment #AIInference #MaskedLearning #CausalModeling #SequenceModel #LanguageTasks #AIOptimization #ModelLoss #CrossEntropy #TextPrompt
  • 🔥 2
Post #1471 148

Forwarded from GitHub Community

Cua — это Docker для агентов, использующих компьютер — он позволяет агентам ИИ управлять полноценными операционными системами в виртуальных контейнерах и развертывать их локально или в облаке.

— Всего ~1,000 строк кода — легко читать, расширять и встраивать
— Поддержка OpenAI, Anthropic, Mistral и других LLM-провайдеров

🐱 GitHub
  • ❤ 4
Post #1470 156

Forwarded from GitHub Community

ExeShield AI обнаруживает вредоносные исполняемые файлы Windows с помощью машинного обучения.

Анализирует энтропию, импорт и метаданные для быстрой классификации, что помогает реагировать на инциденты.

Создано с использованием Python и scikit-learn.

🐱 GitHub
Post #1469 131

Forwarded from Евгений Кокуйкин - Raft

Cloud.ru активно продвигает инструменты для создания агентных систем. Любопытно будет увидеть метрики инференса в Evolution в сравнении с другими платформами. Помимо инструментов для деплоя и настройки приложений в статье авторы также дали рекомендации по защите агентов: GuardRails AI, NER Natasha и наш HiveTrace🎉.
Post #1468 175

Forwarded from База знаний AI

В T-Bank AI Research разработали подход к интерпретации и управлению смысловыми процессами LLM

Подход основан на методе SAE Match, который был представлен командой ранее. Исследователи предложили концепцию графа потока признаков — это карта, которая отражает, где, когда и как в ИИ-модели появляются, трансформируются или исчезают важные смысловые элементы. Эту информацию можно использовать для активного управления LLM.

Новый метод позволяет проводить анализ как между слоями модели, так и внутри самих слоев: между такими модулями как Attention (механизм внимания, анализирует контекст) и Feedforward (отвечает за использование внутренних знаний модели). Как утверждают исследователи, вмешательство сразу на нескольких слоях и модулях позволяет управлять моделью точнее и с меньшими потерями в качестве текста, чем попытки повлиять на отдельный уровень.

Решение исследователей T-Bank AI Research позволяет усиливать или подавлять определенные признаки на разных этапах обработки без изменения параметров модели и без дообучения. Таким образом можно изменять стиль, тематику или тональность генерируемого текста.

🔗Источник: https://www.tbank.ru/about/news/23072025-researchers-from-t-bank-ai-research-have-learned-to-track-and-control-semantic-processes-within-ai/

***
📎Специалисты T-Bank AI Research представили метод SAE Match в апреле 2025 года. Он позволяет понять, в какой момент ИИ-модель начинает давать неправильные или нежелательные ответы и скорректировать их.
Post #1467 138

Forwarded from Al Talent Hub

ИИ-агенты вошли в топ‑5 на CTF, они решают задачи по безопасности быстрее и точнее, чем большинство участников…но не ты — с этой подборкой ⬇️

📌 Ассистенты и фреймворки для автоматического тестирования и поиска уязвимостей и багов

🔥 Агенты

✔️ Diffblue — генерация юнит–тестов для кода на Java.

✔️ Qod — два агента: один пишет, другой тестирует.

✔️ CodeQL — мощный семантический анализатор уязвимостей от GitHub, open-source.

✔️ Semgrep — кастомный поиск уязвимостей и багов.

✔️ Snyk — ассистент безопасной разработки.

✔️ TestSpark — плагин в IntelliJ: LLM-тесты, EvoSuite и Kex.

✔️ Codiga — code review и безопасность на всех языках.

✔️ Sourcegraph — поддерживает разные LLM и интеграции.

✔️ VulnBuster — агент-помощник от магистрантов AI Talent Hub. Использует 5 MCP-тулзов и выдает отчёт с предложениями по улучшению.

📌 Фреймворки

✔️ MLGym — открытый фреймворк и бенчмарк для агентов в автоматизации ML-задач

✔️ Voice Lab — тестирование голосовых агентов

✔️ AgentOps — мониторинг и бенчмаркинг производительности

✔️ AgentBench — набор тестов для оценки LLM-агентов в окружениях

✔️ LLAMATOR — фреймворк тестирования безопасности LLM-приложений. Продукт AI Security Lab ◾️

➡️ Хочешь находить и анализировать уязвимости с помощью ИИ?

Присоединяйся к AI Security Lab — исследовательской лаборатории AI Talent Hub х Raft. Здесь мы создаём собственные инструменты, участвуем в CTF и прокачиваемся в кибербезе на практике.

🐱 — если узнал рокеров на картинке

#ПолезнаяПодборка
#AITalentHub #ITMO #NapoleonIT
  • ❤ 1
Post #1466 158

Forwarded from Security Vision

❤️ Применение больших языковых моделей в кибербезопасности

В новой статье в блоге рассмотрели применение больших языковых моделей (LLM, Large Language Model) и их «братьев» из мира искусственного интеллекта (AI, Artificial Intelligence) в решении задач кибербезопасности.

➡️ Ознакомиться с полной статьей вы можете по этой ссылке.
  • 🔥 1
Post #1460 158

Forwarded from AlexRedSec

AI Controls Matrix (AICM) — ещё один фреймворк, содержащий набор мер управления для безопасной разработки, внедрения и эксплуатации облачных систем искусственного интеллекта от Cloud Security Alliance🧠

Фреймворк включает в себя:
🟡Матрицу мер управления, включающую в себя 243 контроля, сгруппированных по 18 доменам безопасности. Каждая мера привязана к типу/компоненту инфраструктуры и архитектуры, этапу жизненного цикла и категории угроз.
🟡Опросник для самооценки.
🟡Маппинг на стандарт NIST AI 600-1 (2024) и фреймворк Criteria Catalogue for AI Cloud Services – AIC4.

В будущих версиях планируется добавление маппинга на другие стандарты и фреймворки безопасности систем ИИ, а также руководств по внедрению мер управления и их аудиту.

Ниже приложил презентацию и сам сборник материалов AICM.

#ai #framework #csa #aicm #controls #architecture
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →