TGViewer
Channel Public Channel
ML&|Sec Feed

ML&|Sec Feed

@mlsecfeed

Feed for @borismlsec channel

author: @ivolake
Subscribers
1.39K
Photos
1.3K
Videos
89
Links
2K

Showing posts older than #1419 · Back to latest

Older Posts 19 shown
Post #1418 151

Forwarded from AlexRedSec

Компания Pillar Security опубликовала разработанный совместно с коллегами по цеху фреймворк SAIL (Secure AI Lifecycle), представляющий собой процессно-ориентированное руководство по разработке и развертыванию безопасных ИИ-приложений🧠

По факту фреймворк представляет собой матрицу рисков, сгруппированных по семи этапам разработки и развертывания ИИ-приложений. Для каждого риска есть описание, пример небезопасной реализации, затрагиваемые компоненты ИИ-приложения, меры митигации и связанные требования/меры из фреймворков NIST AI RMF, ISO 42001, OWASP и DASF.

В размещённой на сайте брошюре можно найти разбор пары кейсов атак и примеры выборы мер митигации из фрейворка SAIL, а в самом последнем приложении — ссылки на полезные руководства и фреймворки в области ИИ.

#ai #framework #risk #sail #lifecycle
  • 👍 1
Post #1417 144

Forwarded from Data Secrets

Лаборатория Goodfire предложила принципиально новый подход к интерпретации нейросетей. Разбираемся 👇

Как вам уже известно, нейросети и, в частности, LLM – это большие черные ящики. Аппарат их обучения понятный, но мы не знаем, как «думают» уже обученные модели, как они принимают решения, почему действуют так или иначе.

Так вот, все существующие методы интерпретации в основном опираются на активации, то есть на численные значения, которые принимают нейроны на инференсе.

В Goodfire же предложили опираться на параметры – то есть на сами веса модели, которые мы обучаем. Это похоже на попытку восстановить программу через обратное проектирование её исходного кода вместо наблюдения за её поведением на точечных тестах.

Предложенный метод Stochastic Parameter Decomposition (SPD) работает так:

➖Каждая матрица весов расладываются на матрицу ранга 1, которая представляется в виде произведения двух векторов. Это называется субкомпонента.

➖ Для каждой субкомпоненты создается функция, предсказывающая её каузальную важность. Это, грубо говоря, степень, до которой её можно "обрубить" (аблатировать) без изменения выходов модели.

➖ В начале эта функция даёт примерные значения важности для каждой субкомпоненты. На их основе субкомпоненты случайным образом маскируются, после чего модель делает предсказание, и оно сравнивается с оригинальным. Если отличается сильно – значит, значения важности были далеки от правильных. Используя ошибки, делаем шаг обучения, и начинаем с начала.

В итоге имеем набор простых субкомпонент и функцию важности, которые вместе показывают, какие параметры реально используются моделью для того или иного промпта. А это в свою очередь позволяет разложить работу сети на интерпретируемые механизмы и понять, как она принимает решения.

Интересно, что на игрушечных примерах SPD действительно очень точно восстанавливает процесс "мышления", то есть субкомпоненты совпадают с истинными параметрами, отвечающими за конкретные функции. Возможно, у подхода большое будущее.

Статью читаем здесь. А вот тут, кстати, какой-то энтузиаст уже воспроизвел прототип SPD, так что можно поиграться.
  • 🔥 1
Post #1414 147

Forwarded from AI Was Made For Lovin' You

22 мая в 16:00 жду вас на моём выступлении на Positive Hack Days, онлайн или живьём.

Расскажу про ИИ-агенты и их применение в анализе инцидентов: LangGraph, LangGraph Swarm, MCP, рой агентов, факапы и увлекательные приключения с отечественными топовыми LLM. Всё, что хочется рассказать не поместится в один час выступления, но будет доступно позднее в слайдах.

https://phdays.com/ru/forum/program/?date=2025%2F5%2F22&tags=ai&talk-id=1717
Post #1413 174

Forwarded from AI Was Made For Lovin' You

Обещанного три года ждут!

Друзья, огромное спасибо всем, кто был на PH Days и смотрел онлайн. Агенты, которых я обещал на выступлении, наконец-то появились в репозитории - https://github.com/anton-belousov/phd-ai-agentz

4 простеньких агента, которые сканируют цель nmap-ом и проверяют уязвимости в Shodan. Возможно, они будут полезны вам.

Реализованы следующие схемы:

- простой LangGraph
- LangGraph + MCP
- LangGraph Swarm
- франкенштейн LangGraph Swarm, обёрнутый в MCP инструмент

В репозитории есть небольшой конкурс/домашнее задание - смотрите README. Если кто-то захочет поучаствовать, буду безумно благодарен.

(мечтаю о пентест-тулзе, основанной на агентах, которую запустил и пошёл пить чай, а когда возвращаешься, у тебя уже всё исследовано и за тобой выехали готов отчёт)
Post #1411 206

Forwarded from Топ кибербезопасности Батранкова

Все выдержки об ИИ из приказа ФСТЭК № 117

П. 49: ИИ для мониторинга безопасности
«Допускается использование доверенных технологий искусственного интеллекта для анализа событий безопасности».
🔹ФСТЭК впервые легализовал ИИ в ИБ-мониторинге, но с ключевым ограничением – только «доверенные» (российские) решения. Это значит, что:
😶Зарубежные SIEM (Splunk, ArcSight) не подходят;
😶Нужны продукты с сертифицированными ИИ-модулями (например, Sber AI или Yandex AI);

П. 60: Запрет передачи данных
«Не допускается передача лицу, разработавшему модель ИИ, информации ограниченного доступа».
🔹Это революционное требование запрещает:
😶Дообучение моделей на чувствительных данных (гостайна, персданные);
😶Использование SaaS-ИИ (ChatGPT, Claude, DeepSeek) для обработки госинформации;
🔹Даже российские вендоры (Sber, Yandex) не получат доступ к сырым данным – только к анонимизированным датасетам.

П. 60: Защита ИИ-инфраструктуры
«Защита за счет воздействия на: наборы данных, модели, параметры, процессы обработки».
🔹ФСТЭК предписывает защищать весь ИИ-стек:
😶Данные: Шифрование (КриптоПро), DLP (Гарда DLP), БД (Гарда БД)
😶Модели: Контейнеризация (Kubernetes);
😶API: Анализ трафика (Гарда WAF и NDR);
Это сложнее, чем защита традиционных ИС.

П. 61: Контроль запросов/ответов
«Определены шаблоны запросов [...] контроль соответствия [...] разработаны критерии для выявления недостоверных ответов».
😶Фактически вводится «цензура ИИ»:
😶Для шаблонных интерфейсов – белый список команд (например, только SQL-запросы);
😶Для чат-ботов – фильтр тематик («запрещено спрашивать про гостайну»);
Ответы ИИ проверяются на галлюцинации (ложные факты) – нужны теперь встроенные детекторы в LLM.

П. 61: Реагирование на ложные ответы
«Реагирование [...] посредством ограничения области принимаемых решений».
🔹Если ИИ сгенерировал рискованный ответ (например, «удалить базу данных»), система должна:
😶Автоматически заблокировать выполнение команды;
😶Изолировать сегмент ИС;
Это требует интеграции ИИ с системами управления доступами

П. 61: Локализация ИИ
«Доверенные технологии ИИ [...] включаются непосредственно в состав ИС».
🔹Облачные ИИ-сервисы запрещены! Разрешены только:
😶Локальные (on-premise);
😶Российское ПО

#Кибербезопасность #ДляВсех #ИИ #ФСТЭК
Топ Кибербезопасности Батранкова
  • ❤ 1
  • 👍 1
Post #1410 170

Forwarded from Топ кибербезопасности Батранкова

117 приказ ФСТЭК.pdf1.9 MB
ℹ️ Вы уже посчитали свой КЗИ и ПЗИ?

Коллеги, анализирую свежий приказ ФСТЭК №117 (приложен). Этот приказ заменяет приказ № 17 и все изменения к нему № 27, 106, 61. C 1 марта 2026 года у нас с вами появляются обязательные метрики эффективности защиты информации.

🛡Новых обязательных KPI два:

✔️ КЗИ — Коэффициент Защищённости Информации
Он показывает как наши текущие меры защиты покрывают актуальные угрозы. Считаем каждые 6 месяцев, результат летит в ФСТЭК. В объектах КИИ требуется поддерживать и подтверждать КЗИ, равный 1.

✔️ ПЗИ — Показатель уровня Зрелости защиты Информации
Показываем зрелость процессов: мониторинг, управление уязвимостями, удалёнку и прочее. Считаем раз в 2 года, также отправляем регулятору.
Для объектов КИИ целевым считается максимально возможный уровень зрелости (обычно это уровень 4 или 5 по шкале CMMI), что соответствует полностью формализованным, автоматизированным, контролируемым и постоянно совершенствуемым процессам.

🔄 Мне очень нравится описание методики оценки уровня зрелости ИБ у Сбербанка.

📌 Внимание: ФСТЭК требует постоянно отчитываться о ПЗИ и КЗИ!
Если показатели проваливаются - у вас 3 дня на доклад руководству, 5 рабочих дней на отчёт в ФСТЭК. Жёстко?

🌍 Есть ли подобное в мире?
Конечно есть, но у нас впервые это именно KPI, а не рекомендация.
🔹КЗИ → NIST Risk Score, ISO 27005 Risk Index
🔹ПЗИ → NIST
CSF Tiers, COBIT, MIL (Maturity Indicator Levels) внутри Cybersecurity Capability Maturity Model (C2M2)

🔍 Что стоит делать уже сейчас
🔹Провести инвентаризацию угроз и реализованных мер
🔹Построить матрицу угроз и защит
🔹Найти или создать шаблоны расчётов КЗИ и ПЗИ
🔹Актуализирать регламенты и политику ИБ
🔹Назначить ответственных за расчёт и отправку

🧭 Моё мнение? Эти метрики — результат продвижения подхода результативной кибербезопасности. Пока иностранные ISO и NIST говорят: «Оцените себя сами», ФСТЭК говорит: «Ждем результатов».
Есть ощущение, что множество организаций начнут отдавать события безопасности во внешний SOC, чтобы повысить свой КЗИ и ПЗИ.

Кому важно прочитать и выполнять этот документ
🔹Бюджетные организации (больницы, школы, ВУЗы, музеи).
🔹ГУПы («Почта России», «Ростех», «Росатом»).
🔹Органы местного самоуправления (мэрии, районные администрации).
🔹Все федеральные и региональные органы власти (министерства, агентства, службы).
🔹Всем кто входит в реестр значимых объектов КИИ: энергетика, транспорт, здравоохранение, финансы. И да, еще ФЗ-187 «О безопасности КИИ» надо выполнить.

💬 А вы уже прикидывали, какой у вас сейчас КЗИ?

#ФСТЭК #КЗИ #ПЗИ #NIST #ISO27001 #compliance
Топ Кибербезопасности Батранкова
  • 👍 1
Post #1409 160

Forwarded from Похек

How-Anthropic-teams-use-Claude-Code_v2.pdf5.9 MB
How Anthropic teams use Claude Code
#Anthropic #Claude #vibecoding #coding #dev #ai #ии

PDFка от Anthropic, где они делятся своим опытом использования Claude Code для разработки, безопасности, API и т.д. Это не читшит/гайд с промптами или как правильно, а как не правильно. В каждой теме команда приводит пример последотельности мыслей/действий и топ советов, как использовать Claude Code под конкретную задачу

Оглавление:
Claude Code for data infrastructure
Claude Code for product development
Claude Code for security engineering
Claude Code for inference
Claude Code for data science and visualization
Claude Code for API
Claude Code for growth marketing
Claude Code for product design
Claude Code for RL engineering
Claude Code for legal

🔗pdf прикреплена к посту

🌚 @poxek | 🌚 Блог | 📺 YT | 📺 RT | 📺 VK
  • 🔥 2
Post #1403 202

Forwarded from Not Boring Tech

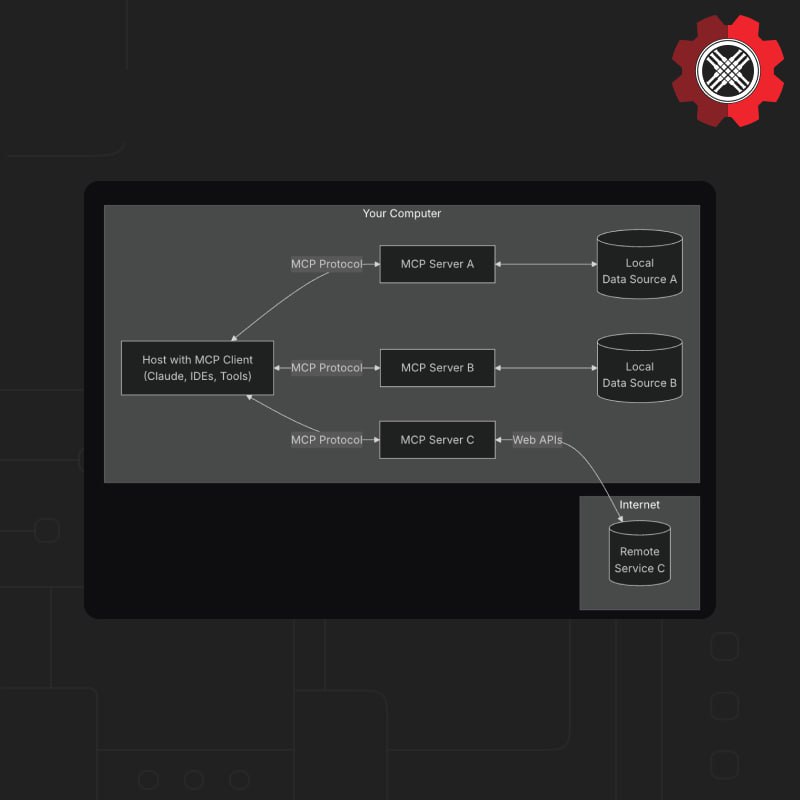
🫙 MCP-плагины теперь запускаются в разы проще — вышла база 450+ контейнерных версий серверов, которые можно установить в один клик через Docker без ручной настройки.

ИИ-агенты подключаются к любым тулзам на выбор — GitHub, Google, Todoist, Notion, Telegram, Airtable, Maps, Calendar и многим другим. Им можно поручать задачи и сразу наблюдать за процессом.

Сохраняйте — тут.

@notboring_tech
Post #1402 163

Forwarded from DayDreamMe|Ethical (DayDream)

😱Просто оставлю это здесь)

Кейс: Взлом голосового ассистента СберБанка (2022–2023)

Что произошло?

Мошенники нашли способ обманывать биометрическую систему Сбера, используя синтезированные голоса. Они:
1. Записывали короткие образцы голоса жертв (например, из соцсетей или телефонных разговоров).
2. С помощью нейросетей (подобных VALL-E от Microsoft) создавали клон голоса.
3. Звонили в колл-центр банка и проходили верификацию, после чего получали доступ к счетам.

Результат:
- По данным СберБанка, в 2023 году было более 100 успешных атак с использованием фейковых голосов.
- Банк усилил защиту, добавив проверку "живого голоса" (анализ дыхания, пауз и артефактов синтеза).

---

Как работала эта атака технически?
1. Сбор данных:
- Мошенники записывали голос жертвы через звонки ("Привет, как дела?") или сливы аудио из Telegram.
2. Обучение модели:
- Использовали opensource-нейросети (например, Silero или Kaldi), чтобы дообучить модель на голос жертвы.
3. Обход биометрии:
- Банковские системы проверяли только чистоту голоса, но не детектировали синтетику.

---

Как сейчас защищаются?
1. СберБанк:
- Ввел мультимодальную проверку (голос + лицо + поведенческий анализ).
- Добавил защиту от речевых deepfake (алгоритмы ищут цифровые артефакты).
2. ЦБ РФ рекомендации:
- Запрет на голосовое подтверждение для переводов >15 тыс. руб. (2024).
- Требование двухфакторной аутентификации для операций.

---

Что делать пользователям?
✅ Не записывать голосовые сообщения с фразами типа "Да", "Подтверждаю", "Я согласен".
✅ Отключить голосовую биометрию в банках, если она не критична.
✅ Использовать сложные пароли + SMS/push-подтверждение.

Этот случай показал, что даже продвинутые ИИ-системы уязвимы к атакам с нейросетями. Но благодаря публичности атак банки быстро усилили защиту.
  • 😱 1
Post #1401 168

Forwarded from GitHub Community

ContextGem — это бесплатная платформа LLM с открытым исходным кодом, которая значительно упрощает извлечение структурированных данных и аналитических сведений из документов с помощью минимального количества кода.

5️⃣ GitHub
Post #1399 198

Forwarded from Machinelearning

📌Учебное пособие по диффузионным моделям для обработки изображений и СV.

Учебник Стэнли Чана, профессора кафедры электротехники, вычислительной техники и статистики Purdue University (США), содержит ультраполезные знания в области диффузионных моделей в контексте обработки изображений и CV. Он доступно и детально объясняет сложные концепции и подходит как опытным профессионалам, так и тем, кто только начинает изучать эту область.

Для профессионалов, уже работающих с диффузионными моделями или стремящихся углубить свои знания, этот учебник послужит отличным ресурсом, который предоставляет прочную основу для понимания и применения концепций в прикладных задачах.

▶️ Содержание:

Вариационный автоэнкодер (VAE)

🟢Структурные элементы VAE
🟢Нижняя граница доказательства (ELBO
🟢Оптимизация в VAE
🟢Заключение и ограничения

Вероятностная модель диффузионного денойза (DDPM)

🟠Базовые элементы DDPM
🟠Нижняя граница доказательства (ELBO)
🟠Распределение обратного процесса
🟠Обучение и инференс
🟠Предсказание шума
🟠Неявная модель диффузионного денойза (DDIM)
🟠Заключение и преимущества DDPM и DDIM

Динамика сопоставления баллов Ланжевена (SMLD)

🟢Выборка из распределения
🟢Функция оценки Штейна
🟢Методы сопоставления баллов
🟢Итоги по SMLD

Стохастическое дифференциальное уравнение (SDE)

🟠От итерационных алгоритмов к обыкновенным дифференциальным уравнениям
🟠Что такое SDE?
🟠SDE для DDPM и SMLD
🟠Численные решатели для ODE и SDE
🟠Заключение и взаимосвязь между DDPM, SMLD и SDE

Уравнения Ланжевена и Фоккера-Планка

🟢Броуновское движение
🟢Мастер-уравнение
🟢Разложение Крамерса-Мойала
🟢Уравнение Фоккера-Планка
🟢Заключение и связь между SDE и уравнением Фоккера-Планка


🟡Arxiv


@ai_machinelearning_big_data

#AI #ML #Tutorial #Duffusion
Post #1398 177

Forwarded from Анализ данных (Data analysis)

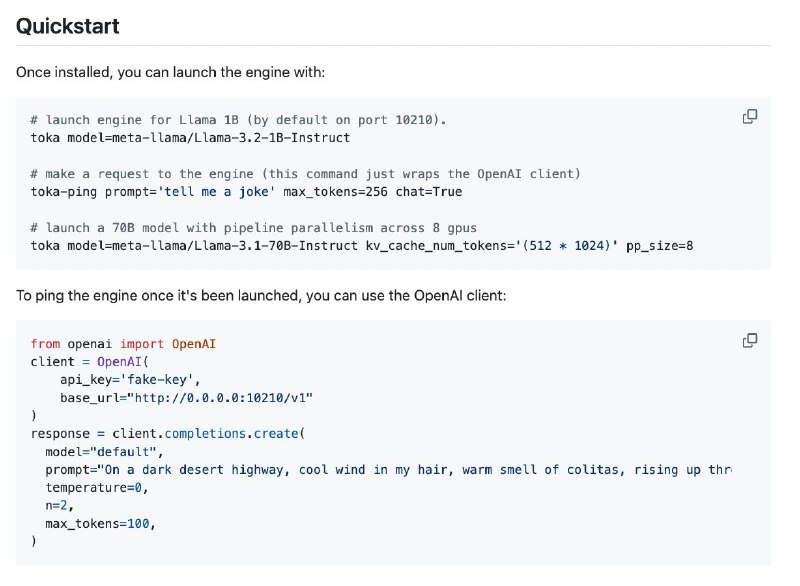
🦖 Tokasaurus — универсальный токенизатор с поддержкой 70+ языков

Tokasaurus — это быстрый и лёгкий инструмент для токенизации текста, созданный на базе библиотеки tokenizers от Hugging Face. Он поддерживает более 70 языков программирования и естественных языков.

🔍 Что умеет Tokasaurus:

• ✂️ Разбивает текст на токены для языковых моделей
• 🧠 Поддерживает GPT-совместимые токенизаторы (tiktoken, BPE и другие)
• 🌍 Работает с Python, JavaScript, C++, Rust, Markdown, JSON, YAML и многими другими
• ⚡ Очень быстрый — написан на Rust с Python-обёрткой
• 📦 Используется как CLI, Python-библиотека или Web API


pip install tokasaurus

🧪 Пример использования (Python):

from tokasaurus import tokenize

tokens = tokenize("def hello(): print('Hi')", model="gpt2")
print(tokens)


🎯 Кому подойдёт:

• Тем, кто работает с LLM
• Для оценки длины prompt'ов
• Для предобработки кода и текста
• Для интеграции в пайплайны, IDE, аналитические инструменты

🔗 GitHub: github.com/ScalingIntelligence/tokasaurus

💡 Если тебе нужен универсальный и быстрый токенизатор — попробуй Tokasaurus.

@data_analysis_ml
  • 👍 2
Post #1397 173

Forwarded from KazDevOps

👀 HashiCorp представила Terraform MCP Server: новый шаг в интеграции ИИ с IaC

MCP — это стандарт, который помогает языковым моделям получать структурированные и машиночитаемые данные из внешних систем в реальном времени. Вместо использования статических обучающих данных ИИ-инструменты могут запрашивать актуальную информацию с помощью JSON-over-gRPC для более точных и контекстно-зависимых ответов.

Это позволяет ИИ-системам, таким как Claude, GitHub Copilot и ChatGPT, генерировать более точный и актуальный код Terraform, опираясь на проверенные источники вместо устаревших или вымышленных примеров из обучающих данных.

ИИ-модель может запросить входные аргументы для провайдера, шаблоны использования популярного модуля или последнюю доступную версию — через стандартизированные запросы к MCP-эндпоинту.

Terraform MCP Server пока на ранней стадии разработки, но уже был продемонстрирован на Microsoft Build 2025 в интеграции с GitHub Copilot. Это позволило разработчикам получать рекомендации по Terraform, основанные на данных из реестра, прямо в их IDE.

Делитесь новостью с коллегами 🫡

@DevOpsKaz 😛
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →