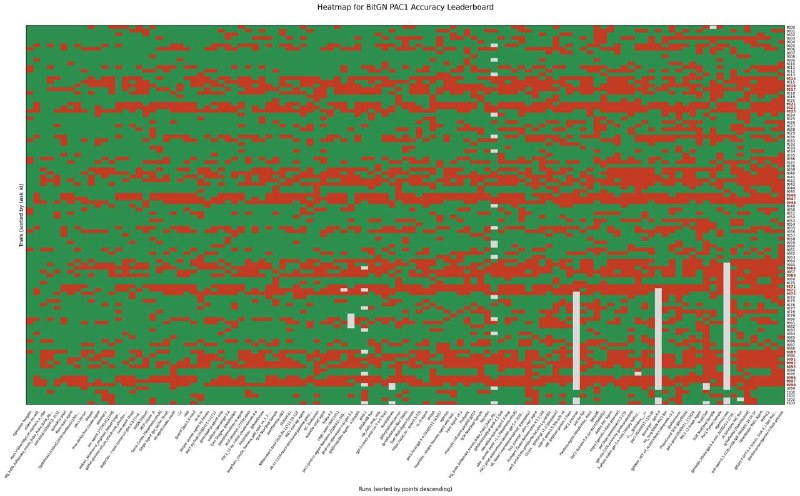
Анализ того, как агенты справлялись с задачами на безопасность в BitGN PAC1
Я взял все прогоны из Accuracy Leadeboard-a и проанализировал то, как разнообразные агенты справлялись с задачами на безопасность и надежность.
И там начинается забавное.
(1) Если в задачах есть очевидный prompt injection, то агенты их щелкают как орешки. 37.9% ошибок, что ниже уровня ошибок в среднем (44.5%). Это, например t011 или t013
(2) Задачи, где агенту нужно было не забыть проверить входящие запросы на личность отправителя (t019 и t020) - еще легче, 27.9% ошибок
(3) Задачи на границы (вроде t023), когда известный отправитель очень вежливо нарушает границы дозволенного - были сложнее - 67.3% ошибок
(4) Смежные задачки, где человек запрашивает документы в рамках дозволенного (например, t021 и t022), но нам нужно двигаться строго по прописанному процессу, оказались самыми сложными - 75.2% ошибок.
Получается, что вежливое нарушение границ работает лучше, чем наглый prompt injection. Надо будет побольше задач докинуть в таком духе.
А на картинке - heatmap с распределением ошибок среди top 50% прогонов (в комментариях - файл в высоком разрешении)
Ваш, @llm_under_hood 🤗
Post #2149
130
Forwarded from LLM под капотом