

Последние несколько дней аутирую над этой темой, потому что периодически натыкаюсь на эксперименты, где люди пытаются заставить сетку что-нибудь дизассемблировать, перегонять разные форматы данных к одному типу и т.п. Поэтому у меня возник вопрос: насколько подобные проекты применимы в продакшене? Ведь если алгоритм выдает разные результаты на один и тот же набор данных, это может породить непредсказуемое поведение для всей системы. Кажется, будто ответ лежит на поверхности - ставишь temperature=0 и greedy decoding всегда берет один и тот же наиболее вероятный токен. Но на деле это работает не совсем так.
Чтобы понять почему, нужно взять во внимание одно фундаментальное свойство чисел с плавающей точкой - неассоциативность. В математике (a + b) + c = a + (b + c), но когда дело начинает касаться float, на сцену выходит стандарт IEEE 754. Float хранит фиксированное количество значимых цифр, и когда складываете числа с очень разными масштабами, хвост отбрасывается:
(0.1 + 1e20) - 1e20  # = 0.0
0.1 + (1e20 - 1e20)  # = 0.1
Ниже приведу несколько статей, которые отталкиваются от этого свойства, но подсвечивают разные причины и варианты решений:
1) Understanding and Mitigating Numerical Sources of Nondeterminism in LLM Inference [ссылка] - разное железо
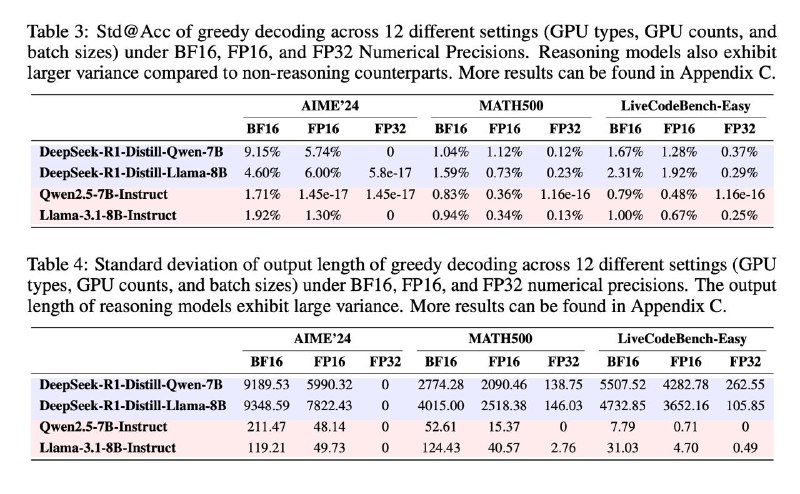
Авторы взяли 4 модели - два reasoning-варианта на базе DeepSeek-R1 и два instruct-варианта (Qwen2.5 и Llama-3.1) и прогнали их на 12 разных конфигурациях: два типа GPU (A100 и L40S), разное их количество и разный размер батча. В результате разброс точности на AIME'24 достигал 9%, а длина ответа расходилась до 9000 токенов при одном и том же промпте и greedy decoding.
Здесь важен аппаратный контекст. Исследователи из Манчестерского университета экспериментально проверили [ссылка], как тензорные ядра считают на V100, T4 и A100 - и обнаружили, что поведение отличается в зависимости от микроархитектуры (например V100 выполняет матричное умножение тайлами 4x4x4, A100 - тайлами 8x8x4, т.е. одно и то же произведение разбивается на разное количество шагов с разными промежуточными суммами, и из-за неассоциативности float итог разный). При этом NVIDIA в официальной документации PTX ISA [ссылка] прямо указывает для операций с .f16 и .bf16: "The accumulation order, rounding and handling of subnormal inputs is unspecified".
А так как в LLM инференсе повсеместно используется BF16 (с 7 битами мантиссы), токены с близкими вероятностями могут поменяться местами. В статье приведен пример: в точке расхождения два прогона дают токену "know" вероятности 49.75% и 46.65% и в одном прогоне побеждает "know", в другом "have". Расхождение происходит в среднем на 45-82 токене в зависимости от модели. Для reasoning-моделей это особенно критично, потому что одно неверное слово в начале разворачивается в другую цепочку рассуждений.
Собственно, они предлагают решить эту проблему через LayerCast [GitHub]: веса модели хранятся в BF16, но все вычисления выполняются в FP32 (23 бита мантиссы). Оно не устраняет ключевую проблему, но делает модель более устойчивой. Однако FP32 вычисления медленнее, потому что современные GPU оптимизированы под 16-битные тензорные операции. Хз, насколько именно оно медленнее - авторы статьи не предоставили этих тестов