DeepSeek снова выпустили что-то очень интересное: у них вышла OCR модель, но непростая
Она не просто распознает текст. Это в какой-то степени система для оптического сжатия контекста.
Как работает обычный OCR: получает картинку с текстом или PDF -> распознает символы -> возвращает текст.
Что делает DeepSeek OCR: получает документ -> сжимает его как зрительный объект -> восстанавливает в текст.
Глобально моделька состоит из двух частей – DeepEncoder и DeepSeek-3B-MoE Decoder. DeepEncoder здесь главная звезда. Он оптически сжимает изображения, превращая его в набор vision токенов.
Под капотом тут SAM + CLIP. SAM извлекает главную структуру и символы: буквы, главы, подписи, картинки, формулы. А CLIP добавляет глобальное понимание контекста и того, о чем вообще этот документ.
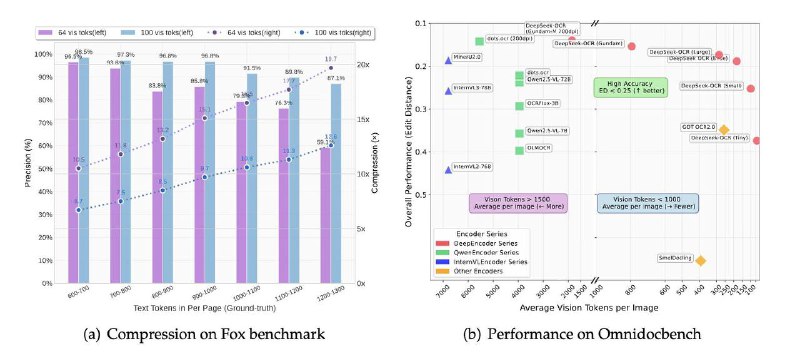
Их выходы затем проходят через сверточное сжатие и вот тут – центральный момент. Свертка уменьшает количество токенов в 10–20 раз, не теряя при этом смысла. То есть вместо 1000 токенов мы получаем, например, 100, а точность при этом сохраняется на уровне 97%. Если сжать в 20 раз – то на уровне 60%.
Дальше все в целом как обычно – сжатые визуальные токены отправляются в LLM, и та расшифровывает их в итоговый текст.
То есть: DeepSeek по сути придумали, как нам хранить в памяти модели в 10 раз больше информации при том же количестве токенов. DeepSeek-OCR может хранить не сам текст, а его сжатое визуальное представление: например, вместо 10 страниц сырого текста в памяти будет 1 страница его visual эмбеддингов, а информативность при этом не пострадает.
Чем вам не замена RAG, например? При этом все это работает в том числе с формулами, сложными структурами, чертежами, картинками и прочим. Полная мультимодальность. Плюс, на практике модель способна обрабатывать 200 000+ страниц в день на одной A100 GPU (ничего себе, как бы).
Ну и метрики. На OmniDocBench обходит GOT-OCR2.0, используя 2.5 раз меньше токенов,
и превосходит MinerU2.0, используя в 9 раз меньше ресурсов. По факту, SOTA. И по точности, и по эффективности.
Все в опенсорсе под лицензией MIT
github.com/deepseek-ai/DeepSeek-OCR
Post #1676
183
Forwarded from Data Secrets