
Недавно openai зарелизила оч классную штуку - Structured output - мы можем "заставить модель отвечать в соответствии с конкретной схемой данных.
Как это работает под капотом
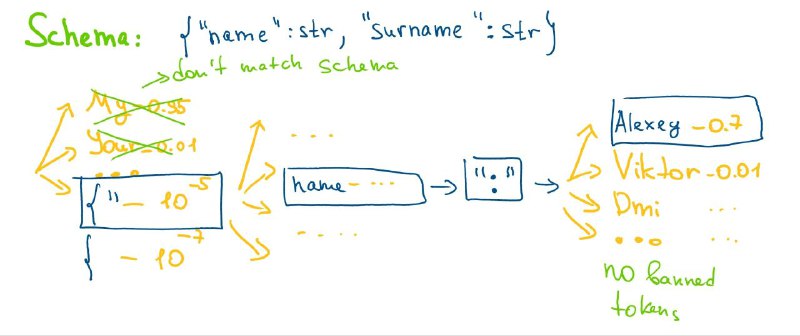
При генерации с обычным жадным декодированием, мы выбираем самый вероятный следующий токен из распределения вероятности что нам отдает модель. Однако в реальных бизнес кейсах от модели часто требуется определенный формат ответа, например json с какими то фиксированными полями.
В этом случае мы можем искусственно ограничить словарь модели, выкинув из них те токены, генерация которых будет противоречить схеме, и выбирать токены только из оставшихся (на каждом токене генерации список токенов получается разный).
У такого подхода есть несколько проблем.
Если схема накладывает ограничение, запрещающее все токены из моды распределеия, то сэмплирования будет проходить их хвоста, где токены довольно случайны и вперед выходят все баесы модели . Так же усиливаются все проблемы жадного (или почти жадного) декодирования, ведь выбор самого вероятного токена на каждом шаге не гарантируют наибольшую вероятностность всей фразе (по той же языковой модели). Так что если позволяет компьют то ставьте побольше beam search или вообще делайте полный просчет для важных и коротких полей (если делаете что то подобное со своими моделями, openai не дает нам контролировать семплирование)
Недавно писал пост про оч классную либу для структуризации оутпута ллм и там очень удобное апи на питоновских фстроках, очень советую посмотреть)
Post #98
1.84K

- 👍 7
- ❤ 1
- 🔥 1
- 🥰 1