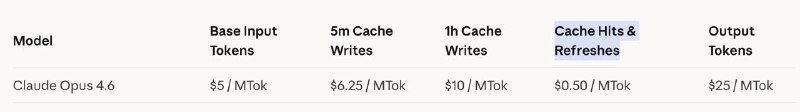
Кэшированные input токены у Антропиков стоят в 10 раз дешевле. Им это реально в 10 раз дешевле обходится.
Когда шлёшь промпт в LLM, модель прогоняет все входные токены через все слои и сохраняет промежуточные результаты - KV cache - рассчёт attention по входным токенам, "память" модели о том что она прочитала. Операция тяжёлая, даже на кластере H100 десятки тысяч токенов в секунду. Запрос на 500K токенов = секунды GPU-времени на каждый запрос.
Кэшированные токены этот шаг пропускают. KV cache уже посчитан, надо просто прочитать. Отсюда 10x разница в цене.
KV cache занимает гигабайты. Где хранить между запросами - иерархия от быстрого и дорогого к медленному и дешёвому:
G1 - видеопамять
G2 - оперативка сервера
G3 - SSD на сервере
G4 - обычное сетевое хранилище
У Антропика два TTL кэша - 5 минут и 1 час. Вероятнее всего 5 минут = кэш в видеопамяти, 1 час = сброс в оперативку или на SSD. Поэтому cache write дороже (копирование вниз по иерархии), а cache read в 10 раз дешевле - даже достать с SSD быстрее чем пересчитать заново.
Сейчас проблема в том что видеопамять быстрая но маленькая и дорогая, а SSD большой и дешёвый но медленный. Nvidia пилит Storage Next с SK hynix и Kioxia - SSD на 100 млн IOPS (обычные делают 3-5 млн), подключение напрямую к GPU минуя CPU. GPU работает с ним как с памятью. KV cache сможет жить дольше и дешевле чем в видеопамяти, но без просадки по скорости как на обычном диске.
Скорее всего это вызовет сильное удешевление кеша, и всех агенских систем в частности
Post #241
2.66K

- 👍 18
- ❤ 8
- 🔥 6
- 🥰 2