В чем ботлнек при работе ЛЛМки? Почему они не могут генерировать быстрее?
в GPU есть 2 основных ботлнека - память и компьют. Во первых нам надо считать все веса из VRAM в условные регистры, после чего произвести какие то вычисления.
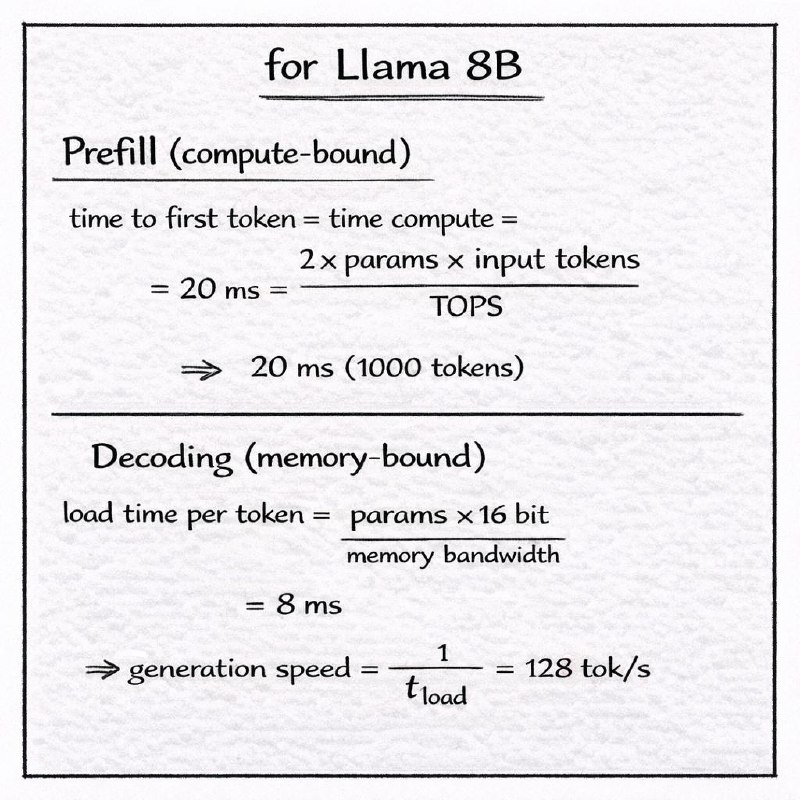
Перед началой генерации надо рассчитать KV кеш по всем input токенам + считать веса модели один раз. В этом случае компьют является ботлнеком - время до первого токена это обьем вычислений / мощность гпу, более подробные вычисления приведены в картинках. Замечу что это теоретическая оценка. Из-за разных оверхедов реальные значения у vLLM будут на 20-30% хуже.
При генерации, на каждый токен надо считать веса 1 раз + forward pass для всего одного токена. В этом случае ботлнеком является уже скорость памяти, а не компьют, время генерации одного токена - размер модели / скорость памяти
Подумайте почему квантизации активно применяются для ускорения ЛЛМок, но вот в случае с дифузиями таким занимаются не так активно. Жду ваших версий в коментариях?
Post #227
2.63K


- ❤ 10
- 👍 4
- 🔥 2
- 🥰 2
- 🤔 1