TGViewer
Channel Public Channel
How to AI in Farsi

How to AI in Farsi

@mlinfarsi

جدیدترین اخبار، مقاله‌ها و آموزش‌های دنیای هوش مصنوعی:

🧠 ایجنت‌های هوش مصنوعی (AI Agents)
🔎 سیستم‌های RAG و مدل‌های زبانی بزرگ (LLM)
⚙️ ابزارها، فریم‌ورک‌ها و پروژه‌های کاربردی GenAI

با ما همراه شوید و از تحولات این حوزه عقب نمانید.
Subscribers
1.13K
Photos
9
Videos
39
Links
324
Recent Posts 20 shown
Post #501 211
وقتی در حال توسعه یک ایجنت هستید، بعد از چند پیام ابتدایی همه‌چیز عالی به نظر می‌رسد؛ اما با رسیدن به پیام پانزدهم، ناگهان تاخیر پاسخ‌ها از چند صد میلی‌ثانیه به چند ثانیه می‌رسد و هزینه پردازش ابری چندین برابر می‌شود. دلیل آن ساده است: فرستادن کل تاریخچه چت در هر فراخوانی API.

دو راهکار دم‌دستی معمولاً برای حل این مشکل استفاده می‌شود:
• کوتاه کردن تاریخچه: کاهش هزینه به قیمت فراموشی سریع ایجنت و از دست رفتن زمینه‌های قبلی.
• تزریق ناشیانه حافظه در پرامپت سیستم: تغییر مداوم متن سیستم پرامپت که باعث نابودی کامل Prefix Cache در ارائه‌دهندگانی مثل OpenAI یا Anthropic می‌شود و هزینه تمام توکن‌ها را به قیمت ۱۰۰٪ محاسبه می‌کند.

معماری حافظه در ایجنت‌های سطح پروداکشن باید چند اصل کلیدی را رعایت کند:
• استخراج ناهمگام (Asynchronous): فرایند استخراج فکت‌ها در پس‌زمینه اجرا شود تا درخواست کاربر معطل نماند.
• ساختار دومرحله‌ای پرامپت (Dual-Tier Architecture): قرار دادن اطلاعات ثابت کاربر بعد از سیستم پرامپت برای کش ماندن ۹۵٪ توکن‌ها، و اضافه کردن حافظه‌های پویای استخراج‌شده در انتهای پرامپت.
• محدودیت‌های منفی در استخراج: تعیین دقیق مواردی که نباید ذخیره شوند تا پایگاه حافظه با نویز پر نشود.

در پست جدید خبرنامه MLnotes، این معماری و نحوه پیاده‌سازی آن را به همراه جزئیات فنی و دیاگرام معماری بررسی کرده‌ام:

🔗 https://mlnotes.substack.com/p/stop-dumping-chat-history-into-context
Substack Stop Dumping Chat History into Context The 4 architectural decisions behind production agent memory
Post #500 409
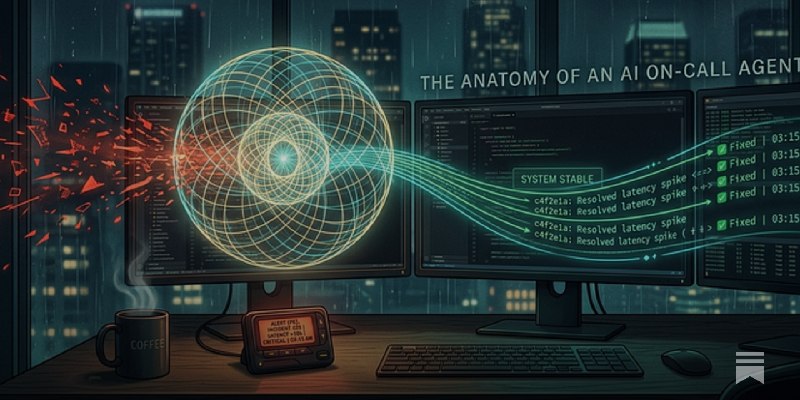
هر مهندس نرم‌افزاری که شیفت On-Call داشته باشد، حس بد آلارم‌های ساعت ۳ نیمه‌شب را خوب می‌شناسد؛ بیدار شدن در تاریکی و صرف حداقل ۲۰ دقیقه زمان فقط برای باز کردن تب‌های مختلف، بررسی لاگ‌ها، مانیتورینگ و پیدا کردن اینکه کدام کامیت یا کوئری مشکل درست کرده است. در این فرآیند مهندس عملاً مثل یک کابل انتقال داده دستی بین لاگ‌ها و سیستم‌ها عمل می‌کند!

شرکت Ramp با راه‌اندازی یک ایجنت هوشمند به نام OCA این معادله را تغییر داده است. این ایجنت توانسته در حل صدها حادثه مشارکت کند، زمان بررسی خطاها توسط انسان را ۵۰ درصد کاهش دهد و نیاز به تعداد مهندسان درگیر در حادثه را ۳۷ درصد کمتر کند. این سیستم ظرف ۵ دقیقه فرضیه اولیه ریشه خطا را اعلام می‌کند و در کمتر از ۱۵ دقیقه یک PR پیشنهادی برای رفع باگ آماده می‌کند.

معماری چنین سیستم‌هایی بر خلاف تصور اولیه، با نوشتن یک پرامپت حجیم ۲۰ هزار توکنی کار نمی‌کند؛ مدل‌ها در پرامپت‌های شلوغ سردرگم می‌شوند یا دچار خطای شناختی نتیجه‌گیری زودهنگام (Premature Closure) شده و اولین علت دم‌دست را به اشتباه ریشه اصلی حادثه معرفی می‌کنند. راهکار اصلی استفاده از روش Just-in-Time Prompting و قلاب‌های اجرایی (Execution Hooks) در یک معماری ۳ لایه‌ای است:

۱. محیط ایزوله و دسترسی‌های Read-Only: ایجنت در یک کانتینر ایزوله به لاگ‌ها، گیت و Read-Replica دیتابیس دسترسی دارد و خطاها را تحلیل می‌کند.

۲. لایه بازرسی و انحراف ایمن (Safety Detours): وقتی ایجنت تصمیم می‌گیرد گزارش نهایی را ثبت کند، کنترل‌کننده سیستم جلوی آن را می‌گیرد و یک چک‌لیست اعتبارسنجی را اجرا می‌کند تا فرضیه خودش را راستی‌آزمایی و ابطال کند.

۳. گیت تایید انسانی: ایجنت هرگز خودش تصمیم به دیپلوی مستقیم نمی‌گیرد؛ خروجی آن یک گزارش شفاف در اسلک و یک PR آماده است و تایید نهایی توسط مهندس انجام می‌شود.

بررسی عمیق‌تر این معماری و تله‌های پروداکشن آن را در پست جدید خبرنامه بخوانید:
https://mlnotes.substack.com/p/the-anatomy-of-an-ai-on-call-agent
Substack The Anatomy of an AI On-Call Agent: Why the Next Incident Responder Won’t Be Human How Ramp automated 50% of incident triage, why bloated 20,000-token system prompts fail, and the 3-loop architecture of autonomous on-call agents.
Post #498 527
در آخرین مقاله خبرنامه Substack، به سراغ مدلی رفتم که این روزها سر و صدای زیادی در جامعه هوش مصنوعی به پا کرده است: مدل Jev از استارتاپ TypeSafe AI (توسط یکی از نویسندگان اصلی مقاله معروف InstructGPT).

مدل Jev اساساً یک مدل گفتگو یا چت‌بات نیست؛ نه مقاله می‌نویسد و نه با شما چت می‌کند! این مدل به عنوان یک «سیستم ۱» (System 1) طراحی شده تا به جای تولید رشته‌های متنی و دست و پنجه نرم کردن با خطاهای JSON در برنامه‌نویسی، در کمتر از ۱۰۰ میلی‌ثانیه تصمیمات ساختاریافته، Type-Safe و کالیبره‌شده برای نرم‌افزارها بگیرد.

در این مقاله مفصل بررسی کردم:

🔹 چرا تولید متنی JSON در پروداکشن دردسرساز است؟ از توهم در ساختار کلیدها (Schema Drift) گرفته تا اتلاف منابع پردازشی با تولید تک‌تک توکن‌ها به صورت اتورگرسیو.

🔹 بنچمارک عملی روی اپل سیلیکون: مدل Jev را در برابر روش Parallel Constrained Decoding روی مک‌بوک و روش سنتی Autoregressive مقایسه و بنچمارک کردم که نشان داد ارزیابی موازی بیش از ۳ برابر سریع‌تر است و رفت‌وبرگشت‌های فوروارد را تا ۹۶.۸٪ کاهش می‌دهد بدون این که هیچ خطایی در اسکیما رخ دهد.

🔹 معماری دوسطحی آینده: تقسیم کار هوش مصنوعی به موتورهای استنتاج سنگین و کند (System 2 مانند o3 یا Claude 3.7) برای حل مسائل پیچیده، و مدل‌های فوق سریع و ارزان (System 1) برای روتینگ، گاردریل‌ها و شرط‌های نرم‌افزاری.

🔹 کاربردهای عملی: از فشرده‌سازی تاریخچه بدون از دست رفتن داده‌ها در ایجنت‌های کدنویسی تا کنترل زنده بازی DOOM با حلقه‌های ۱۰۰ میلی‌ثانیه‌ای.

متن کامل مقاله و نتایج بنچمارک‌ها:
https://mlnotes.substack.com/p/the-ai-model-that-wont-talk-to-you
Substack The AI Model That Won’t Talk to You: Why “System One” Models Are the Missing Piece for AI Workflows Why autoregressive JSON causes friction in production, how non-generative models deliver sub-100ms typed decisions, and what our 50-sample benchmarks revealed.
Post #497 618
مهندسان اوبر در یک مقاله فنی جدید توضیح داده‌اند که چطور توانستند تاخیر (Latency) جستجو در اوبر ایتس (Uber Eats) را به نصف کاهش دهند. نکته جالب این مقاله، ترکیب بهینه‌سازی‌های عمیق معماری با استفاده از ایجنت‌های هوش مصنوعی برای کدنویسی و دیباگ خودکار است.

خلاصه اقدامات کلیدی و جالب آن‌ها:

🔹 تغییر متریک از بک‌اند به تجربه واقعی کاربر (ATF): به جای تمرکز صرف روی زمان پاسخ API، متریک را به زمان رندر اولین بخش تصویر در صفحه گوشی کاربر (Above-The-Fold) تغییر دادند و رندرینگ را به صورت موازی (Async) بازنویسی کردند.

🔹 جداسازی فرآیند هیدریشن (Hydration Split): قبلاً تا تمام اطلاعات نمایشی (مثل قیمت، تصاویر و تخفیف‌ها) لود نمی‌شد، فرآیند رتبه‌بندی مدل‌های یادگیری ماشین شروع نمی‌شد. آن‌ها این مرحله را دو تکه کردند؛ سیگنال‌های لازم برای رتبه‌بندی بلافاصله واکشی می‌شوند و لود جزییات ظاهری به صورت Async انجام می‌گیرد.

🔹 بهینه‌سازی امبدینگ‌ها و لایه سیستم: سایز امبدینگ‌های مدل را با کاهش دقت اعشار و فشرده‌سازی تا ۴۶٪ کوچک‌تر کردند. همچنین در کد‌های زبان Go با تبدیل پوینترها به Value types بار Garbage Collector حافظه را که تا ۴۰٪ پردازنده را درگیر می‌کرد به شدت کاهش دادند.

🔹 لوپ ایجنتی خودکار (Agentic Loop): به یک ایجنت هوش مصنوعی تارگت کاهش تاخیر و دسترسی به لاگ‌های پروفایلینگ پروداکشن دادند. ایجنت گلوگاه‌ها را پیدا می‌کرد، کد بهینه‌سازی می‌نوشت، پول‌ریکوئست می‌ساخت و با بنچمارک‌های خودکار عملکرد را می‌سنجید تا بدون دخالت دستی مشکلات ریز اما پرتکرار را حل کند.

🔹 برنامه‌های بعدی: پیاده‌سازی بچینگ در مقیاس ریز (Microbatching)، فیلتر اولیه داخل لایه ایندکس (Zero-Pass Ranking) و استریم کردن فرگمنت‌های نتایج به سمت کلاینت.

لینک مقاله کامل:
https://www.uber.com/us/en/blog/uber-eats-search-pipeline/
Post #495 715
نسخه‌ی جدید Pocket TTS Farsi v2 منتشر شد!

تبدیل متن فارسی به گفتار که روی CPU اجرا می‌شه؛ بدون GPU و بدون API. فقط حدود ۱۰۰ مگابایت، چند برابر سریع‌تر از زمان واقعی، و با امکان کلون کردن هر صدایی فقط با ۵ ثانیه فایل صوتی.

این نسخه با ۹۷۳ ساعت داده و ۲,۹۷۸ گوینده آموزش داده شده و در تمام معیارها از v1 بهتره. حتی در تست شنیداری blind هم عملکرد بهتری داشت.
توی ویدیوی پایین توضیح دادم یک سری چیزها را. با صدا ببینید.👇

اما جالب‌ترین چیزی که در این مسیر یاد گرفتم (۱۰۰۰ دلار بیشتر هزینه آموزش😅 ) این بود که benchmark من در واقع داشت مدلی رو ارزیابی می‌کرد که تقریباً درعمل اینجوری نبود. به خاطر ۴ تا باگ مهم که توی کدی پنهان شده بود و evaluation من حتی یک بار هم اجراشون نکرده بود. از جمله یک خط کد که بی‌سروصدا اولین کلمه‌ی هر جمله رو حذف می‌کرد!

توی پست جدید، کل این مسیر رو نوشتم؛ از مشکلات benchmark گرفته تا چیزهایی که یک benchmark اساساً نمی‌تونه در زبانی مثل فارسی بشنوه، زبانی که Vowels / مصوت‌ها رو به‌صورت کامل در نوشتار نمایش نمی‌ده.
لینک بلاگ: https://mlnotes.substack.com/p/my-benchmark-was-testing-a-model

🤗 مدل: http://huggingface.co/mehdi-hf/pocket-tts-farsi-v2
💻 کد: http://github.com/mallahyari/pocket-tts
Substack My Benchmark Was Testing a Model Nobody Used Four bugs, a language that doesn't write its own vowels, and $2,530 spent before I built the listening test I should have started with.
Post #494 544
این ویدیو از این ریپو
Post #493 473
پروژه جذاب و متن‌باز God's Eye View یک شبیه‌ساز تصاویر ماهواره‌ای در مرورگر است که داده‌های دنیای واقعی را روی یک کره سه‌بعدی Photorealistic به نمایش می‌گذارد. نکته جالب اینجاست که تمام داده‌های استفاده‌شده در آن عمومی و زنده هستند.

این ابزار با ترکیب داده‌های منابع عمومی و هوش مصنوعی، لایه‌های مختلفی از اطلاعات را به صورت Real-time مانیتور می‌کند:

🔹 ردیابی زنده پروازها و هواپیماها (از طریق ADS-B و OpenSky)
🔹 ردیابی زنده کشتی‌ها و شناورهای دریایی (AIS)
🔹 موقعیت ماهواره‌ها در مدار زمین (با محاسبات مداری SGP4 و TLE)
🔹 داده‌های زلزله‌نگاری جهانی (USGS) و دوربین‌های ترافیکی عمومی
🔹 کره زمین سه‌بعدی و واقعی با استفاده از CesiumJS و Google Photorealistic 3D Tiles
🔹 قابلیت کنترل صوتی با ایجنت‌های بلادرنگ (Realtime AI Agent) برای جابه‌جایی و بررسی نقاط مختلف

لینک پروژه در گیت‌هاب:
https://github.com/bilawalsidhu/gods-eye-view
GitHub GitHub - bilawalsidhu/gods-eye-view: A spy satellite simulator in your browser, except the data is real. Live open source spatial… A spy satellite simulator in your browser, except the data is real. Live open source spatial intelligence on a photorealistic 3D globe. - bilawalsidhu/gods-eye-view
Post #492 501
هاگینگ‌فیس به‌تازگی مجموعه آموزشی ۶ قسمتی خود با عنوان Training Agents را کامل کرده است؛ یک پلی‌لیست کاربردی که مسیر ساخت، ارزیابی و آموزش ایجنت‌ها در محیط‌های واقعی را به همراه کدهای کاملاً باز پوشش می‌دهد.

مروری بر مباحث این ۶ جلسه:

🔹 ارزیابی ایجنت‌ها (Agentic Evaluations):
بررسی وضعیت واقعی ارزیابی‌ها و چرایی فاصله داشتن نتایج بنچمارک‌ها با عملکرد عملی ایجنت‌ها در دنیای واقعی.

🔹 یادگیری تقویتی برای ایجنت‌ها (RL for Agents):
طراحی محیط‌ها، استراتژی Rollout، ساخت تابع پاداش و گلوگاه‌های استنتاج (Inference) در گذار از RL سنتی به ایجنت‌ها.

🔹 آموزش با نظارت (SFT on Agent Traces):
تبدیل لاگ‌ها و ردپای تعاملات ایجنت‌ها به داده‌های آموزشی و فاین‌تیون با کتابخانه‌های TRL و LoRA.

🔹 تقطیر دانش (Distillation):
انتقال توانایی و مهارت‌های مدل‌های بزرگ به ایجنت‌های کدنویسی کوچک‌تر و سبک‌تر با روش‌های مختلف Distillation.

🔹 یادگیری تقویتی با GRPO:
پیاده‌سازی الگوریتم GRPO بعد از مرحله SFT، کار با توابع پاداش قابل اعتبارسنجی (Verifiable Rewards) و تحلیل رفتار مدل و دور زدن پاداش‌ها (Reward Hacking).

🔹 اتصال به محیط‌های تعاملی (From Rewards to Environments):
گذر از توابع پاداش ساده به ساخت محیط‌های تعاملی شبیه به ساختار Gym، اتصال OpenEnv به GRPOTrainer و آموزش عملی یک ایجنت کدنویسی در محیط‌های Sandbox.

لینک تماشای کل پلی‌لیست در یوتیوب:
https://www.youtube.com/playlist?list=PLo2EIpI_JMQvQZm-kVlz4wY1vWF0LBcf5
Post #490 445
این روزها ساختن یک برنامه وب یا بک‌اند با کمک هوش مصنوعی از همیشه سریع‌تر و ساده‌تر شده، اما چالش اصلی زمانی شروع می‌شود که برنامه رشد می‌کند و ترافیک بالا می‌رود؛ جایی که سیستم دیزاین (System Design) اهمیت پیدا می‌کند. در این ویدیوی آموزشی فوق‌العاده، یکی از مهندسان مفاهیم پایه‌ای سیستم دیزاین را به جای استفاده از اصطلاحات پیچیده و گیج‌کننده، با یک رویکرد کاملاً عملی از صفر قدم‌به‌قدم توضیح می‌دهد.

روند طراحی سیستم در این آموزش با شکستن مرحله‌به‌مرحله معماری پیش می‌رود:

🔹 شروع از ساده‌ترین معماری:
یک سرور و یک دیتابیس برای هزاران کاربر اول کاملاً جواب می‌دهد و نیازی به پیچیدگی بی‌مورد نیست.

🔹 مقیاس‌پذیری عمودی و افقی (Vertical vs Horizontal Scaling):
وقتی بار ترافیک بالا می‌رود، ابتدا ارتقای سخت‌افزاری سرور (Vertical) و سپس اضافه کردن سرورهای همسان پشت یک لود بالانسر (Horizontal) مطرح می‌شود.

🔹 مدیریت نشست‌ها (Session Management):
جدا کردن وضعیت نشست‌ها و استیت کاربر از سرورها و انتقال آن‌ها به یک حافظه مشترک برای حفظ حالت بی‌وضعیت (Stateless) بودن وب‌سرورها.

🔹 تفکیک بار دیتابیس (Read Replicas & Connection Pooling):
جدا کردن کوئری‌های خواندن از نوشتن با استفاده از رپلیکاها و مدیریت اتصالات برای جلوگیری از داون شدن پایگاه داده.

🔹 کش‌گذاری و صف‌های ناهمگام (Caching & Message Queues):
استفاده از کش برای پاسخ‌های تکراری و پرهزینه، و انتقال کارهای زمان‌بر به صف‌های پس‌زمینه (Background Workers) برای پاسخ‌دهی سریع به کاربر.

🔹 شاردینگ دیتابیس (Database Sharding):
تقسیم داده‌ها روی چند پایگاه داده مجزا بر اساس کلید مشخص به عنوان آخرین راهکار در مقیاس‌های بسیار بزرگ و بررسی چالش کوئری‌های چندشاردی (Cross-shard).

لینک تماشای ویدیو در یوتیوب:
https://www.youtube.com/watch?v=EaXHfuHRWwg
YouTube How Senior Engineers Actually Think About System Design & Architecture | Full Course The JSM Agentic Engineering Course is FINALLY LIVE! 🔥 🔔 20% off launch discount ends September 29th. Invest in your engineering future 🚀 https://jsm.dev/ai Learn real System Design by taking one server and breaking it on purpose, over and over again. Every…
Post #489 410
تیم OpenBMB مدل جدید MiniCPM5-2B را با معماری استاندارد Llama و تحت مجوز Apache-2.0 منتشر کرد. این مدل با اندازه ۲ میلیارد پارامتر به طور ویژه برای اجرا روی دستگاه‌های محلی (On-device)، دستیارهای کدنویسی و تسک‌های مبتنی بر ایجنت طراحی شده و با وجود جثه کوچکش، نباید اصلاً دست‌کم گرفته شود؛ حتماً دانلودش کنید و عملکردش را خودتان تست کنید چون حتی از مدل‌های بزرگ‌تر رده 4B هم در بنچمارک‌ها پیشی گرفته است.

ویژگی‌ها و دستاوردهای کلیدی این مدل:

🔹 عملکرد فراتر از انتظار در تسک‌های ایجنتی و کدنویسی:
در بنچمارک SWE-bench Verified به امتیاز ۴۶.۴٪ رسیده که برای یک مدل 2B رقمی فوق‌العاده است. همچنین در ارزیابی‌های سرچ ایجنت (GAIA Text-103) امتیاز ۸۸.۷٪ و در ابزارمحوری (Tool Use) امتیازات بسیار بالایی ثبت کرده است.

🔹 قدرت استدلال ریاضی و کد (Deep Reasoning):
در حل مسائل ریاضی سطح بالا از جمله AIME 2025/2026 امتیاز ۸۶.۵٪ و در MATH-500 امتیاز ۹۴.۶٪ به دست آورده است. در آزمون LiveCodeBench v6 نیز نمره ۶۹.۱٪ را به ثبت رسانده است.

🔹 پشتیبانی بومی از طول زمینه ۱۲۸K:
مدل به صورت پیش‌فرض از کانتکست ۱۲۸ هزار توکن (131K) برای پردازش مستندات طولانی پشتیبانی می‌کند.

🔹 پایپ‌لاین آموزشی و تقطیر ایجنتی (RL + OPD):
آموزش این مدل شامل SFT عمیق تفکر، یادگیری تقویتی (RL) بر پایه الگوریتم JustRL II و در نهایت تقطیر سیاستی (On-Policy Distillation) حاصل از ۱۶ مدل تخصصی اکسپرت (از جمله ۵ اکسپرت ایجنتی) است. مجموعه‌داده‌های آموزشی این مدل نیز به عنوان بخشی از پروژه UltraData منتشر شده‌اند.

🔹 استقرار سریع با فریم‌ورک‌های استاندارد:
پشتیبانی بدون نیاز به کرنل کاستوم در vLLM ،SGLang و Hugging Face Transformers.

صفحه مدل در هاگینگ‌فیس:
https://huggingface.co/openbmb/MiniCPM5-2B

پروژه در گیت‌هاب:
https://github.com/OpenBMB/MiniCPM
huggingface.co openbmb/MiniCPM5-2B · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science.
Post #488 496
چندتا مثال درست کردم و گذاشتمشون توی ریپو گیتهاب که راحت بتونید گوش بدید.
Post #484 715
من یک مدل تبدیل متن به گفتار (TTS) فارسی آموزش دادم که روی CPU اجرا می‌شه.

یک مدل ۱۰۰ میلیون پارامتری که از یک مدل معلم ۲۴ لایه distill شده و از صفر روی ۴۹۷ ساعت گفتار فارسی با لایسنس عمومی CC0 آموزش دیده؛ داده‌هایی از Mana-TTS، فیلیمو و زیرنویس‌های یوتیوب.

مدل می‌تونه فقط با چند ثانیه صدای ورودی، صدای گوینده رو تقلید کنه و روی CPU، بسیار سریع‌ اجرا بشه. این مدل بر پایه‌ی pocket-tts ساخته شده که توسط
kyutai_labs
توسعه داده شده.

تا جایی که من بررسی کردم، این اولین مدل فارسی در لیست community-models خود pocket-tts محسوب می‌شه و یکی از معدود مدل‌های TTS فارسیه که واقعاً روی CPU با سرعت قابل استفاده اجرا می‌شه. بیشتر مدل‌های متن‌به‌گفتار متن‌باز برای فارسی، و حتی خیلی از زبان‌های دیگه، عملاً فرض می‌کنن که یک GPU در اختیار دارید.

نکته جالب‌تر اینه که دانشجوی ۶ لایه در تمام معیارهایی که اندازه‌گیری کردم، از معلم ۲۴ لایه خودش بهتر عمل کرد: نرخ خطای کلمات (WER)، شباهت گوینده و کیفیت ادراکی صدا.

البته یک محدودیت واقعی هم وجود داره که بهتره صادقانه بهش اشاره کنم:

در فارسی، اضافه (ezafe)،(کسره ربط بین اسم و صفت/مضاف‌الیه)، معمولاً در نوشتار مشخص نمی‌شه. بنابراین مدلی که متن خام رو می‌خونه، باید اضافه رو از روی context حدس بزنه و گاهی هم اشتباه می‌کنه.

حتی نمی‌شه این مشکل رو صرفاً با اضافه کردن دستیِ علامت‌ها حل کرد، چون در داده‌های آموزشی، این علامت‌ها تقریباً هیچ‌وقت به شکل یکدست و consistent نوشته نشده‌اند. بنابراین pipeline پردازش متن هم باید اون‌ها رو حذف کنه.

همه‌چیز رو عمومی کردم: اسکریپت‌های آموزش، pipeline ارزیابی، یک runbook مرحله‌به‌مرحله و توضیحات کامل پروژه.

توی ویدیو کامل توضیح دادم. ۲تا نکته: توی ویدیو گفتم "فاین تیون" که درست نیست. آموزش کامل دادم روی زبان فارسی. و اینکه گفتم ۷۰۰ ساعت که ۵۰۰ ساعت دیتا بود.

🤗 مدل: https://huggingface.co/mehdi-hf/pocket-tts-farsi
💻 کد و توضیحات کامل: https://github.com/mallahyari/pocket-tts

ویدیو تو پست بعدی به همراه نمونه صدا.
huggingface.co mehdi-hf/pocket-tts-farsi · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science.
Post #483 514
پروژه اوپن‌سورس Rakazo یک پلتفرم جدید برای ساخت و اجرای هم‌تیمی‌های هوش مصنوعی دائمی (Persistent AI Teammates) است که به عنوان یک جایگزین متن‌باز برای Grok Bot معرفی شده است. برای آشنایی بیشتر، گراک بات (Grok Bot) یک پلتفرم هوش مصنوعی چند ایجنتی و دائمی توسعه‌داده‌شده توسط xAI است که درون اکوسیستم Cursor یکپارچه شده است.

حالا Rakazo این امکان را فراهم کرده تا چنین ساختاری را با مدل و سندباکس دلخواه روی زیرساخت خودتان پیاده کنید.

ویژگی‌های کلیدی Rakazo:

🔹 دسترسی به محیط‌های سندباکس و GUI:
ایجنت‌ها از طریق داکر یا ارائه‌دهندگانی مثل E2B و Daytona به ترمینال، مرورگر، فایل‌ها و حتی دسکتاپ گرافیکی دسترسی دارند و تسک‌ها را مستقیماً اجرا می‌کنند.

🔹 همکاری چند ایجنتی و ساب‌ایجنت‌ها:
امکان تفویض تسک بین بات‌ها یا ساخت ساب‌ایجنت‌های موقت برای انجام کارهای موازی.

🔹 اتصال مدل دلخواه و پشتیبانی از MCP:
امکان استفاده از API مدل‌های مختلف (از طریق OpenRouter و...) و اتصال ابزارها با پروتکل MCP و OpenAPI.

🔹 حالت صوتی پیشرفته:
امکان مکالمه و تعامل صوتی دوطرفه با کلیدهای اختصاصی ElevenLabs ،OpenAI یا Cartesia.

🔹 سلف‌هاست و چندسکویی:
دارای وب‌اپ، نسخه دسکتاپ (Electron) و موبایل (Expo) که به راحتی با Docker Compose روی سرور شخصی بالا می‌آید.

لینک مخزن گیت‌هاب:
https://github.com/elie222/rakazo
GitHub GitHub - elie222/rakazo: Open-source Grok Bot alternative. Choose your own model and sandbox. Open-source Grok Bot alternative. Choose your own model and sandbox. - elie222/rakazo
Post #482 596
اوبر به‌تازگی مقاله فنی فوق‌العاده‌ای درباره معماری «کارخانه نرم‌افزار» (Software Factory) خود منتشر کرده که خواندنش برای هر تیم مهندسی فعال در حوزه ایجنت‌ها واجبه.

در اوبر بیش از ۷۰ درصد Pull Requestها توسط ایجنت‌ها تولید یا ویرایش می‌شوند و روزانه بیش از ۳۰ هزار اجرای مهارت (skill) دارند. نکته شگفت‌انگیز اینه که با وجود رشد ۷ برابری کاربران و ۹٫۴ برابری درخواست‌ها، هزینه کل AI آن‌ها ثابت مانده و هزینه هر تسک تا ۵۲ درصد کاهش پیدا کرده است.

چند درس و راهکار کلیدی از معماری بهینه‌سازی اوبر:

🔹 حذف سربار اسکیماهای MCP با رویکرد CLI و جستجوی ابزار:
بارگذاری مستقیم ده‌ها سرور MCP باعث می‌شد مدل قبل از دریافت اولین پرامپت، ۵۰ تا ۷۰ هزار توکن اسکیما را در هر دور با خودش حمل کند. اوبر تمام سرورهای MCP را پشت یک گیت‌وی برد و آن‌ها را به‌شکل دستورات CLI یا جستجوی درجا درآورد تا فقط اسکیماهای لازم وارد کانتکست شوند.

🔹 اجرای ابزارها با رویکرد Code-Mode به‌جای فراخوانی مستقیم چتی:
به‌جای اینکه مدل برای اجرای کوئری و چند بار بررسی وضعیت (polling) در هر مرحله توکن مصرف کند، این فرآیندها در قالب اسکریپت‌های پایتونی در یک ساب‌پراسس اجرا می‌شوند و فقط نتیجه نهایی به مدل برمی‌گردد. همین تغییر ساده مصرف توکن را بین ۵۰ تا ۹۹ درصد کاهش داده است.

🔹 گراف کانتکست با ۲۴ میلیون نود:
ایجنت‌ها به‌جای جستجوی کورکورانه در صدها مخزن کد، مستقیماً از یک گراف دانشی شامل سرویس‌ها، لاگ‌ها، معماری و PRهای قبلی اطلاعات می‌گیرند. این کار زمان حل تسک را از ۲۰ دقیقه سرگردانی به ۳۸ ثانیه کاهش داده است.

🔹 روتینگ مدل‌ها بر اساس بنچ‌مارک واقعی (Pareto):
اوبر ساب‌ایجنتهای کمکی را به‌طور پیش‌فرض به مدل‌های ارزان‌تر و سریع‌تر می‌سپارد و مدل‌های پیشرفته‌تر (Frontier) را فقط برای برنامه‌ریزی اصلی نگه می‌دارد.

🔹 مدیریت کش کانتکست و زمان بیکاری:
افزایش TTL کش به یک ساعت برای سشن‌های تعاملی برنامه‌نویسان (به‌دلیل وقفه‌های کاری) و ۵ دقیقه برای ساب‌ایجنتهای موقت، از هدررفت بازسازی مداوم کانتکست جلوگیری کرده است.

مطالعه متن کامل بلاگ‌پست اوبر:
https://www.uber.com/us/en/blog/efficient-software-factory/?uclick_id=8c39ed77-46d9-4e1a-bd0a-20aaec118b9a
Uber Running a Software Factory Efficiently at Uber Scale We just published a deep dive on how we keep AI coding costs under control at Uber, even as usage keeps climbing. Since February, weekly active employees across all functions on our agentic offerings grew 7x, and weekly agent requests grew 9.4x. Over that…
Older posts →

About this channel

How can I read @mlinfarsi without a Telegram account?
TGViewer shows the public web preview Telegram publishes for How to AI in Farsi: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does How to AI in Farsi have?
How to AI in Farsi (@mlinfarsi) has 1.13K subscribers on Telegram, refreshed roughly every 30 minutes.
Does How to AI in Farsi know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →