
Reasoning в LLM
В разных каналах часто наблюдал посты о том, что какая-то компания создала свою reasoning-LLM. И хотя способность заставлять модель обосновывать ответ вам наверняка известна, хотелось бы разобраться, почему reasoning-LLM выносят в отдельное направление развития.
📝 Пару вводных
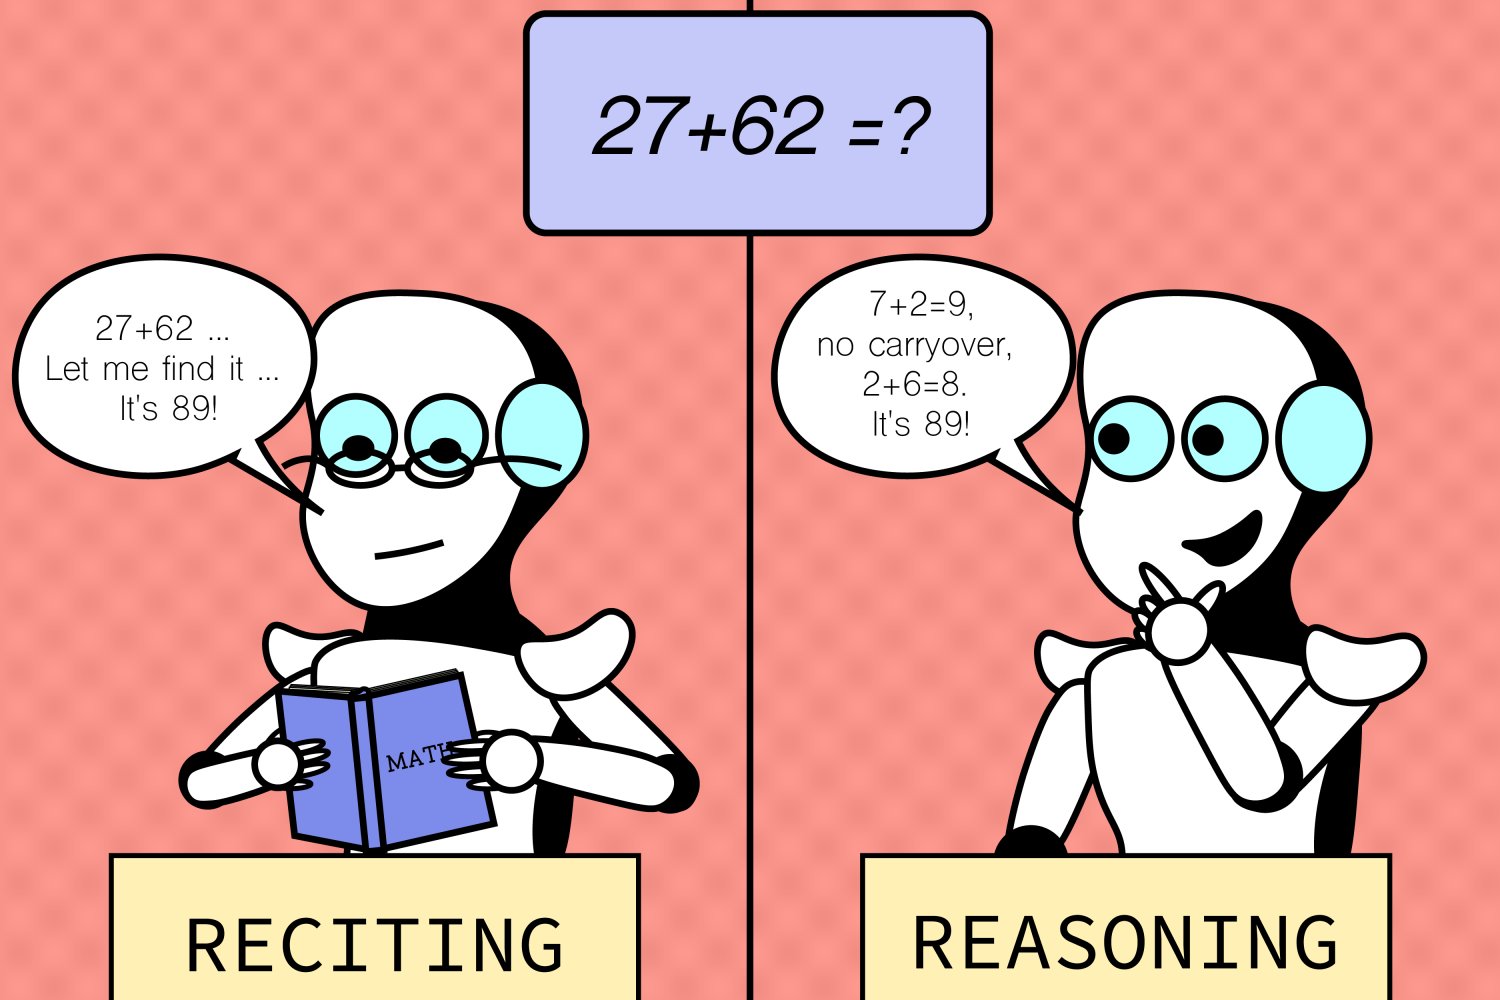
Reasoning - это способность LLM не просто выдавать конечный ответ на запрос, а рассуждать, как именно получился такой ответ. Понятно, что это повышает доверие пользователя к ответу. Но еще, как показывают эксперименты, именно способность рассуждать повышает точность результатов (например, 17,7% -> 78,7% на матане).
И хотя пояснить ответ можно по-разному, в этом посте мы будем говорить о цепочке рассуждений — chain-of-thoughts reasoining.
🔹 Как модель заставляют рассуждать?
Простые инструкции
Самый банальный вариант — в запросе указать соответствующие инструкции, типа "Let's think step by step". Или "Представь, что ты студент на экзамене. Расскажи подробно... "
Так мы ожидаем, что модель даст на просто ответ, а ряд пояснений.
Промпт с примерами рассуждений
Когда в самом запросе приводятся примеры подробного решения. И просят таким же образом решить другую задачу. Это еще называют chain-of-thoughts prompting.
Supervised Fine-tuning
Нельзя не упомянуть, что если нужно, чтобы модель умела рассуждать, нужны соответствующие подробные решения комплексных задач в обучающей выборке. Мы же должны объяснить модели "смотри, как надо, учись". Если доступных датасетов не хватает, самим намайнить таких данных — это тот еще квест... Один из вариантов - использовать другую reasoning-LLM.
🔹 Повышаем надежность
Подумай еще раз, еще раз
Это модификация chain-of-thoughts reasoining. Только теперь один и тот же промпт мы прогоняем через LLM несколько раз. И каждый раз модель через рассуждения приходит к конечному ответу. Какой ответ был чаще, тот и правильный. Это повышает точность финального результата, но сильно замедляет процесс. Это обозвали self-consistency.
Внешние инструменты
При использовании рассуждений есть риск галлюцинаций даже в простейших математических операциях. Поэтому модели дают API разных инструментов (калькулятор или внешняя база знаний) и поощряют ее за их использование. Статья
Таким образом, учитывая такой фронт работы над reasoining-LLM, это действительно можно считать отдельным направлением. Потому как LLM учат воспроизведению знаний, языковым задачам и обобщению информации. А у reasoner больше упор на понимание условий задачи, разбиение на части, последовательное решение и сохранение при этом всей логики.
Post #77
97
- 👍 3
- 🔥 1