TGViewer
Channel Public Channel
ML доставляет

ML доставляет

@ml_kuper

Привет! Ты заглянул на канал ML-команды Купер.тех. Здесь мы рассказываем, как создаём доставку будущего с помощью DS, NLP, CV и как стать одним из нас.
Subscribers
784
Photos
346
Videos
2
Links
48
Recent Posts 7 shown
Post #390 141

Forwarded from ecom.tech

#ивент #спикер ecom.tech на karpov.courses

Когда: 16 сентября, 19:00
Формат: online

Доклад для тех, кто только начинает свой путь в ML — уже сегодня на online-вебинаре karpov.courses.

Наш спикер Денис Гордеев, ведущий специалист по машинному обучению, покажет, как с помощью русскоязычных новостей и ML-модели предсказывать движение акций MOEX.

Вы узнаете о влиянии новостей на фондовый рынок, научитесь превращать заголовки в признаки и объединять их с историей котировок. А ещё построите модель для предсказания роста или падения акций на следующей торговой сессии и разберётесь, как избежать утечки данных при работе с новостями и временными рядами.

🙂 Записаться
  • ❤‍🔥 5
  • 🔥 1
Post #380 5.74K
✨Хороший work-life balance сам себя не настроит

В ML много задач, где мозг постоянно что-то считает, сравнивает, проверяет гипотезы и пытается понять, почему метрика снова ведёт себя странно. Поэтому особенно важно уметь переключаться и отдыхать от рутины.

Спросили ребят из команды: от руководителей до стажеров, чем они занимаются в свободное от работы время, что любят и как расслабляются. Читайте в карточках выше – некоторые ответы получились очень нишевые 😎
  • ❤ 11
  • 👍 3
  • 🔥 3
Post #379 502
🔥uvидел, установил, победил

Есть вещи, которые в Python-разработке объединяют всех: любовь к удобным библиотекам и тихая усталость от долгой установки зависимостей.

Обычно, чтобы этого избежать, мы в команде вместо pip и poetry используем uv.

uv — это современный Python package manager и resolver от команды Astral (те же ребята, что делают Ruff). Он невероятно быстрый и при этом довольно удобный.

Вот что нам особенно понравилось:

🟢Скорость

uv написан на Rust и использует продвинутые алгоритмы разрешения зависимостей (на основе pubgrub — тот же, что в poetry, но сильно оптимизированный). Это даёт значительный прирост производительности в разрешении зависимостей, парсинге, проверке хэшей и т.д. В наших проектах разница особенно заметна на CI и при работе с большим количеством зависимостей.

🟢Простая работа с окружениями

uv может заменить сразу несколько инструментов:

uv venv — быстрое создание виртуального окружения
uv pip install — ускоренная установка пакетов
uv sync — работа с pyproject.toml / requirements

🟢Параллельная загрузка и установка

Скачивает и устанавливает пакеты параллельно (много потоков).
Использует эффективный HTTP-клиент с HTTP/2 и хорошим кэшированием.
При повторной установке часто вообще ничего не скачивает — просто берёт из кэша.
Кэш shared между проектами (экономия места и времени).

🟢Отличная интеграция с Ruff и другими современными инструментами

Поскольку uv от тех же авторов, что и Ruff, они очень хорошо дружат между собой. Это позволяет держать весь Python-стек современным и быстрым.


Когда лучше использовать uv:

- Хотите максимальную скорость разработки;
- Работаете в ML / Data Science (много тяжёлых пакетов);
- Часто создаёте новые окружения;
- Любите современный и минималистичный стек (Ruff + uv);
- Не нужны сложные build-системы и скрипт.

Когда лучше оставить Poetry:

Если проект уже большой, стабильно работает на Poetry, а команда не хочет перестраивать привычные процессы без явной необходимости. Poetry также может быть удобнее, если вам нужны продвинутые возможности: группы зависимостей, скрипты, сложная сборка или полная совместимость со старыми инструментами.

👉 Мы постепенно переводим часть наших ML-пайплайнов и внутренних инструментов на uv — и пока очень довольны результатом. Рекомендуем попробовать, особенно если вы устали ждать, пока pip install завершит работу.

А как вы используете uv в своих проектах? Делитесь опытом в комментариях 🏃
  • ❤ 9
Post #378 743
💬 От интуиции к алгоритму: как мы научились управлять массовым привлечением курьеров

9 июля на Data Day Элен Теванян, руководитель управления машинного обучения Купера, расскажет, как мы переходили от экспертного управления к алгоритмическому решению в привлечении курьеров. Будет полезно тем, кто внедряет ML/AI в операционные и коммерческие задачи.

Если будете на Data Day 2026 — приходите послушать доклад и пообщаться!
  • 🔥 12
  • ❤ 5
Post #377 489
⚡️ MLOps-платформа Купера: вопросы и ответы

MLOps-платформа растёт вместе с командами, моделями и инфраструктурой. А ещё регулярно подкидывает вопросы: что автоматизировать, что оставить командам, где поставить ограничения и как понять, куда её развивать.

В мини-интервью Юрий Классен, руководитель команды MLOps, рассказывает, как в Купер.тех развивают MLOps-платформу и что влияет на решения:

1️⃣ Как понять, что ML-платформа действительно помогает, а не просто добавляет ещё один слой абстракции?

Мы много этим вопросом задавались и задаемся до сих пор, особенно когда выбираем задачи, которые делать стоит, а какие нет. В нашей команде мы в первую очередь смотрим на обратную связь пользователей платформы: ML-инженеров и разработчиков.
Долгое время нашей основной целью было снижение Time to Market ML-проектов. Сейчас с помощью платформы мы также стараемся оптимизировать затраты на инфраструктуру. Кроме того, ML-платформа влияет на количество инцидентов и время их устранения, но этот элемент мы пока не оценивали в формате «до/после».


2️⃣ Что перестало работать по мере роста числа моделей и команд? Какие подходы пришлось пересмотреть?

Основное, что перестало работать, является даже не техническим решением, а форматом работы. У нас была модель поддержки, в которой инженеры MLOps-команды при возникновении каких-то проблем у ML-инженеров приходили разбираться в их технических решениях, не всегда даже связанных со взаимодействием с платформой. В таком формате небольшая MLOps-команда перестала справляться, поэтому мы постепенно перестроили поддержку: начали делать инструкции, проводить встречи, делиться опытом и интересными кейсами из поддержки. Теперь на основе этих материалов более опытные ML-инженеры могут помогать своим коллегам.


3️⃣ Есть ли у вас механизмы, которые помогают не сжечь весь кластер
одной моделью?


Стоимость ML-инфраструктуры для нас очень важна. Даже если фича даёт бизнес-эффект, важно понимать, не обходится ли она дороже, чем приносит пользы. В таком случае разрабатывать и внедрять её просто не имеет смысла. Поэтому мы стараемся не только ускорять работу ML-команд, но и помогать им оптимально использовать инфраструктурные ресурсы.

Чтобы одна модель не могла забрать на себя весь кластер, мы разделяем ноды по критичности нагрузки, используем requests и limits в Kubernetes и контролируем, сколько ресурсов запрашивается под разные задачи. Для GPU-нагрузок используем MIG. Он помогает эффективнее делить GPU между задачами и снижает риск, что они будут мешать друг другу.


4️⃣ Есть ли сценарии, где задержка в несколько сотен миллисекунд уже становится критичной?

Обычно это сценарии, напрямую связанные со взаимодействием с пользователем. Пользователь заметит, если результаты поиска или рекомендации загружаются слишком долго, и, конечно, это влияет на удовлетворённость клиентов. Поэтому, когда мы делаем решения для таких систем, на latency смотрим очень внимательно. Например, у меня даже был доклад о том, как мы оптимизировали этот показатель в нашем Feature Store. С ним можно ознакомиться по ссылке.
  • 😎 5
  • 👏 2
Post #371 769
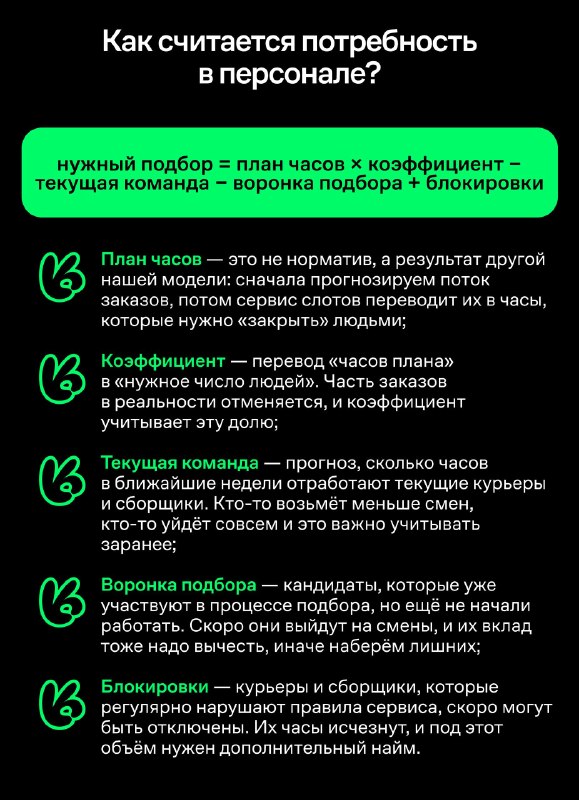
📦 Как с помощью ML-моделей посчитать, сколько человек нужно для доставки?

Если курьеров и сборщиков окажется слишком мало — заказы начнут опаздывать. Если слишком много — люди останутся без работы.

В карточках Егор Дмитриев, руководитель команды анализа данных, рассказывает, как мы решаем эту задачу с помощью ML: откуда берутся данные, как мы делаем расчеты для разных типов доставки и как найм превращается из реакции на проблему в планирование наперёд.
  • 🔥 9
  • 👍 6
  • 😎 1
Post #370 494
🌍 LLM-платформа звучит красиво, пока её не надо поддерживать

4 июня на Infra.conf’26 в Москве наш старший MLOps-инженер Роза Морозенкова расскажет, как мы используем KServe для ML- и LLM-инференса.

На примере платформы Купер.тех разберёмся, как выстроить инфраструктуру от инференс-сервисов до gateway и guardrails — так, чтобы ей могли пользоваться команды по всей компании. Ведь хочется, чтобы всё было красиво: платформенно, переиспользуемо, удобно и желательно без ощущения, что ты теперь пожизненно дежуришь у этого костра.

✨ Если будете на Infra.conf’26 офлайн — приходите послушать доклад, поддержать Розу и позадавать вопросы!
  • 🔥 12
  • ❤ 9
  • 👍 6
Older posts →

About this channel

How can I read @ml_kuper without a Telegram account?
TGViewer shows the public web preview Telegram publishes for ML доставляет: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does ML доставляет have?
ML доставляет (@ml_kuper) has 784 subscribers on Telegram, refreshed roughly every 30 minutes.
Does ML доставляет know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →