
Коллеги, вы как боретесь с item cold start?
Сегодня расскажу про статью от Google: «Item-centric Exploration for Cold Start Problem»
На недавнем RecSys 2025 было много неплохих работ, которые зацепили сходу.
Сегодня хочу рассказать про простую идею, которую можно переиспользовать везде, где важна вероятность.
Например, для кандидатогенерации. В моем докладе про кросскат мы предсказываем не айтемы, а категории товаров. Для каждой категории находим вероятность и пропорционально ей семплируем уже айтемы из этой категории.
Проблемы рекомендательных систем:
Допустим, мы научились предсказывать вероятность клика/контакта от показа — но насколько такой вероятности можно доверять?
Если айтем новенький и по нему мало коллаборативных фичей-счетчиков, то модели ранжирования поставят его сильно ниже. Похожая ситуация и в кандидатогенерации.
Что предлагают авторы:
Давайте не показывать айтемы слепо. Посчитаем честную конверсию для айтема из показа в клик/контакт. Также у нас уже есть обученная модель ранжирования, которая предсказывает персональную вероятность клика S на айтем для конкретного пользователя.
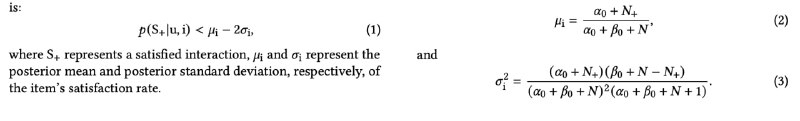
Если персональная вероятность меньше, чем глобальная вероятность клика - 2 * std, то этот айтем можно не показывать пользователю — с большой вероятностью он ему не интересен.
Но получается, что мы уменьшаем пул айтемов, не предлагая ничего взамен?
Тут на арену выходят параметры alpha и beta. Когда мы считаем честную вероятность N+/N (N+ — положительное событие "клик/контакт", N — показы), мы можем добавить в числитель alpha, а в знаменатель — alpha + beta.
Таким образом, если у айтема было много N+, то alpha и beta не внесут большого вклада — мы уверены в истинной конверсии айтема.
Но если айтем холодный, то alpha и beta значительно скорректируют (повысят) его расчетную конверсию.
На картинке представлена полная картина: условия фильтрации (1), перерасчитанная конверсия (2) и поправка для оценки std (3).
Результат:
Метод позволяет без дополнительного обучения модели поднять выдачу для холодных айтемов.
Мои мысли:
Такую поправку очень легко использовать в современных индустриальных рекомендательных системах — расчет количества контактов/кликов и показов это уже решенная задача.
Для ранжирования можно дешево "прогревать" новые категории объявлений, не переобучая модель ранжирования, что обходится кратно дороже.
Для кандидатогенерации — чуть сложнее. Если брать в расчет вероятностные кандгены — например, на базе semantic ids, где можно посчитать вероятность на этапе инференса — то, добавив поправку, можно настроить количество свежих айтемов для пользователя. Для векторного отбора кандидатов — сложнее, так как вероятность будет известна уже после похода в БД за кандидатами.
Вот такие мысли по статье :)
Делитесь, как еще вы решаете cold-start проблему для айтемов.
Post #58
1.32K
- 🔥 6
- ❤ 2