Сегодня рассмотрим статью поискового ранжирования от Pinterest - InterRact
Абстракт
Современные поисковые системы используют многоступенчатый подход:
item corpus -> Retrievial -> PreRanking -> Ranking/Blending
В этой статье хотят решить проблемы, с которыми столкнулся pinterest на этапе PreRanking
Проблема
1) Нужно укладываться в latency - классические DLRM или DCN не поспеют
2) Обычно используют two tower подходы - тут есть ограничение в dot product - может не найти сложные зависимости между векторами айтемов и запросов
3) Вспоминают про BM25, который по сути счетчик в пересечении слов. Ему сложно дается найти семантические зависимости , а также он не учитывает контекст пользователя в данной сессии
Решение
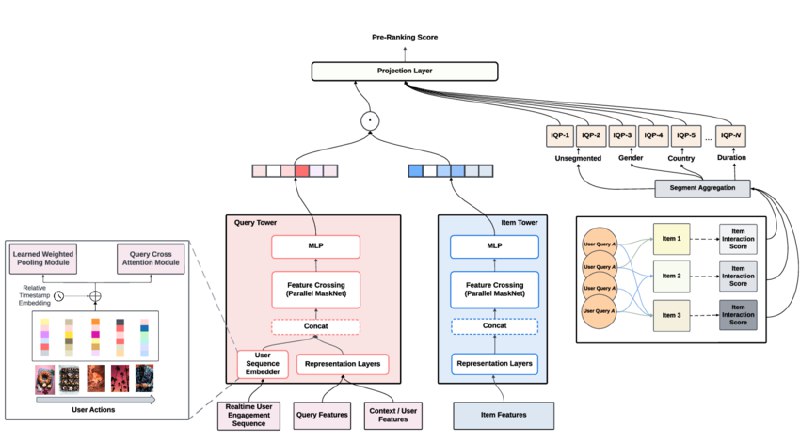
Представляют архитектуру InteractRank. Свойства
1) Двубашенная - вектор запроса, вектора айтема
2) Доп модуль для cross-interaction фичей
3) Используют контекст активной сессии
Данные
Берут кликстрим логов с поиска за T дней. Для каждого поискового запроса собирают показанные айтемы и взаимодействие пользователя с ними (клик, скачивание пина, скриншот и т д).
В качестве трейна берут T-k дней и k дней в тест.
Архитектура
Состоит из нескольких блоков: Query Tower, Item Tower, Segmented Aggregation.
Towers - принимают на вход фичи соответсвующей сущности, прогоняют через Feature Crossing, По сути механизм внимания.
Используют IQP (Segmented Aggregation.) - счетчики совстречаемости для сущности p и q нормированные на частоту q. В качестве p и q могут выступать категорийные фичи: страна, пол, запрос, айтем. Они помогают ухватить долгосрочный интерес.
Лосс
Состоит из 2 - cross entropy для ранжирования выдач и sampled soft max - для Retrieval части:
1) В качестве таргета берут Ui на поисковой выдачи. Если у пользователя есть хотя бы 1 положительное действие, то Ui=1, иначе 0.
2) Семплируют из батача негативы + LogQ и подают в софтмакс. Подают эмбединги айтема и запроса
Оффлайн Метрики
Берут метрику HITS@K.
Получилось улучшить качество по сравнению с Two Tower моделями на 3 процента, при это вычислений стало больше на 10%. Дополнительно смотрят влияние каждого блока на качество (моя любимая часть любой статьи - показатель, что все компоненты уместны)
Железо
Тренируют на 8 карточках A100 по 80 GB. Что в онлайне - не нашел
A/B-test
Основной метрикой берут SIFR = (количество полезных выдач)/(общее количество выдач). Выдача полезная - если было хотя бы 1 целевое действие . Выросла на 6.5%
Что я думаю.
Крутая идея использовать счетчики совстречаемости на этапе преранжирования/кандгена - их можно подготовить заранее. Также показали как выглядит хорошее исполнение поиска:
1) Берем фичи запроса - поверх них внимание
2) Берем айтемы, на их фичах тоже внимание
3) Дот продукт и лосс к нем, Для большей робастности - in batch negative.
Выглядит как классический рецепт для статей такого уровня - еще раз убедился, что она рабочий
Также радует - простая и понятная метрика в оффлайне. Стоит тоже ориентироваться на такой подход .
Post #41
1.35K