
Условная максимизация в uplift моделировании
TL;DR
Позволяет персонализировать принятие решений, выбирая оптимальную стратегию с учётом не только эффекта, но и стоимости воздействия.
Почему обсуждается?
Обычная uplift модель выбирает вариант с максимальным ожидаемым эффектом. Но в реальных задачах каждое воздействие имеет свою цену или риск. Рассматриваемый подход решает эту проблему: он позволяет находить оптимальное решение при фиксированном уровне затрат.
Проблема
Нужно персонализировать выбор воздействия так, чтобы максимизировать ожидаемое значение целевой метрики, не превышая средний уровень затрат.
Предположения
Для каждого клиента известны:
– X — набор признаков,
– T — какой из вариантов воздействия был оказан,
– Y — целевая метрика,
– S — затраты на воздействие.
Предполагается, что данные получены из эксперимента: вероятность выбора воздействия P(T = t | X) = p(t) не зависит от X.
Решение
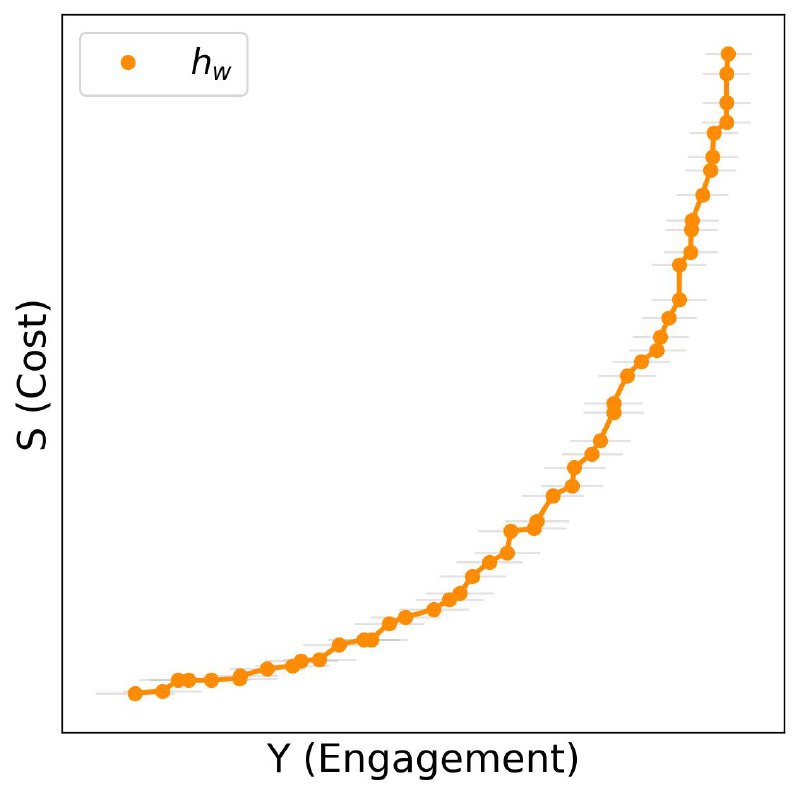
1. Для набора весов w решаем задачу uplift моделирования с одной целевой метрикой U = Y - w·S (например, как в постах про S-learner или Causal Random Forest). Получаем набор стратегий h(w).
2. Для каждой стратегии h(w) на отложенной выборке оцениваем средние значения целевой метрики Y(w) и затрат S(w) (например, как в посте об оценке качества персонализации).
3. Выбираем такой вес w, при котором оценка S(w) не превышает заданную стоимость C. Соответствующая стратегия h(w) является искомой.
Достоинства
– При достаточном качестве модели выбор воздействия будет приближаться к оптимальному.
– Позволяет строить стратегию с посегментными ограничениями, аналогично задаче Лагранжа.
– Метрики, между которыми строится размен, произвольны. Например, если метрика S должна быть не меньше некоторого порога C, следует использовать целевую функцию U = Y + w·S.
Ограничения
– Требует подбора коэффициента w, который может зависеть и от времени, и от поданной выборки.
– Метрики эффекта и затрат должны быть достаточно чувствительными, чтобы на них можно было обучать модели и находить оптимальные размены.
– Несмещённые оценки S(w) и Y(w) получаются только при обучении на данных эксперимента.
Библиография
Kharlamov V. Conditional Optimization in Uplift Modelling // Proceedings of the Fourteenth International Conference “Computer Data Analysis and Modeling: Stochastics and Data Science”. – 2025. – С. 121-124.
P.S.
Этот подход был разработан на хакатоне по повышению эффективности выдачи кэшбэка. В прошлом месяце на статистической конференции CDAM’25 мы рассказали об этой и других методологиях ASL. На пути от хакатона к проду модель прошла несколько итераций изменений, лучше адаптировавших её к применению в бизнесе. О том, какие фишки и доработки были внесены в модель и методологию, расскажу в следующем посте!
Post #15
1.98K
- 🔥 17
- ❤🔥 4
- ❤ 2
- 🦄 2