


🌸AI Research Preference Model🌸
#nlp #про_nlp #nlp_papers
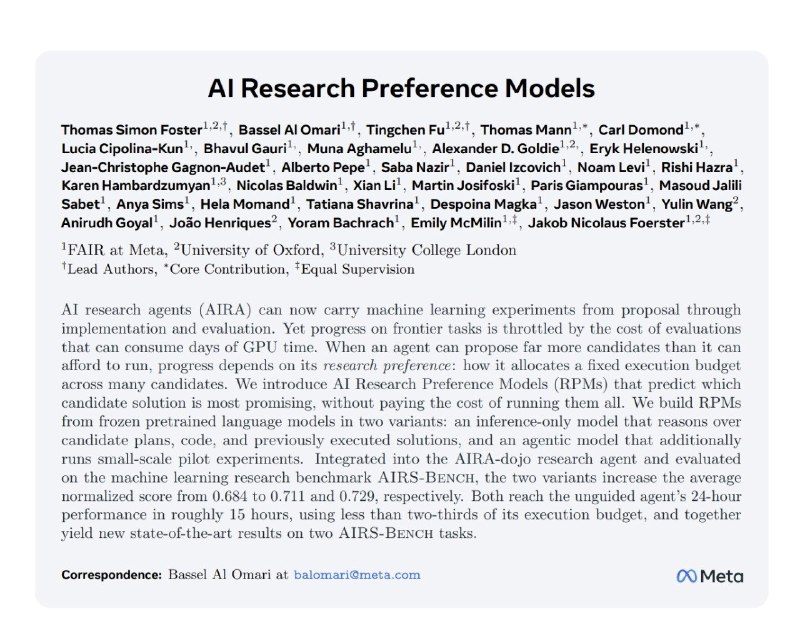
Сегодня опять про скаффолды для агентов. Мы уже говорили про то, хорошая ли идея применить сверху preference models для оценки потенциала идей (спойлер: нет). А что, если попробовать обучить такую preference-модель не на вкусовщине (новизна идеи, "вкус", интуиция и т.д.), а на верифицируемом сигнале? Про это наша новая статья — “AI Research Preference Models”.
🌸TL;DR
Главная проблема: AI-агент может быстро придумать множество вариантов эксперимента, но полноценный запуск каждого варианта — обучение модели и оценка результата — требует часов работы GPU. Поэтому критически важно заранее понять, какие идеи действительно стоит проверять.
Мы предлагаем Research Preference Model (RPM) — модель, которая сравнивает несколько предложенных решений и выбирает наиболее перспективное до их полного запуска. В идеале, такая модель может выучить паттерны лучших практик МЛ, чтобы использовать эту информацию для попарного сравнения экспериментов, какой будет более перспективным.
Рассматриваются два варианта:
Inference-only RPM анализирует планы, код и результаты предыдущих экспериментов только при помощи рассуждений LLM.
Agentic RPM дополнительно проводит дешёвые пилотные эксперименты: запускает сокращённое обучение (5 минут, 30 минут, 4 часа), проверяет код и использует полученные метрики для выбора.
🌸Агент
RPM встроена в исследовательского агента AIRA-dojo. На каждом шаге агент генерирует 15 вариантов продолжения, после чего RPM проводит попарное сравнение и отправляет на полноценный запуск только победителя.
🌸Данные
Эксперименты проведены на 20 задачах AIRS-Bench, охватывающих языковое моделирование, математику, биоинформатику и временные ряды. Каждому запуску предоставлялись 24 часа на одной H200 GPU.
🌸Основные результаты
обычный AIRA-dojo: 0,684 среднего нормализованного балла;
с Inference-only RPM: 0,711;
с Agentic RPM: 0,729;
теоретически достижимый результат: 0,748.
Обе RPM достигают результата обычного 24-часового агента примерно за 15 часов, то есть требуют примерно в 1,5 раза меньше вычислений. Кроме того, были получены новые SOTA:
94,1% на WinoGrande против прежнего агентного SOTA 90,4%;
95,7% на SVAMP против опубликованного человеческого SOTA 94,2%.
🌸Главный вывод статьи:
прогресс исследовательских агентов зависит не только от способности генерировать хорошие идеи, но и от умения выбирать, какие идеи заслуживают дорогой экспериментальной проверки. Дополнительные вычисления выгодно тратить не только на генерацию решений, но и на их предварительный отбор, основанный на предсказуемых и верифицируемых сигналах.
Сигнала от мини-версии эксперимента, с первых 5 минут, бывает вполне достаточно!
Проверено на одном скаффолде, но для всех tree-search подходов такой апгрейд должен сработать.
🟣Arxiv https://arxiv.org/abs/2608.13940
🟣Alpharxiv https://www.alphaxiv.org/abs/2608.13940
Post #3765
648